미니 데이터센터 운영 — 사건이 일어나는 곳
구축은 끝이 있지만 운영은 없다. 이 장은 일부러 고장을 내고, 절차대로 고치고, 왜 그렇게 했는지 기록하는 훈련이다. 채점 기준은 「복구했는가」가 아니라 「조치 순서와 근거가 남았는가」다 — 실제 운영 조직이 사람을 평가하는 방식이 그것이기 때문이다.
이 장을 마치면
- 운영 조직의 역할을 나누고 각 역할이 무엇을 보고 무엇을 결정하는지 설명할 수 있다.
- 기준선과의 차이로 이상을 정의하고, 탐지→선별→대응→복구→사후의 절차를 수행할 수 있다.
- 사고 유형별 런북을 작성하고, 판단이 필요한 지점을 명시할 수 있다.
- 시설 이상이 IT 장애로 연쇄하는 경로를 추적하고 차단 지점을 고를 수 있다.
- 에이전트에게 운영을 위임할 때 필요한 통제 장치(게이트·승인·킬 스위치)를 설계할 수 있다.
구축과 운영은 다른 일이다
18장의 검수 체크리스트를 통과한 순간, 이 랙의 성질이 바뀐다. 「만드는 물건」에서 「지키는 물건」이 된다. 그러면 잘하는 기준도 바뀐다.
| 구축 (18장) | 운영 (19장) | |
|---|---|---|
| 성공이란 | 설계대로 되었다 | 어제와 같다 |
| 시간 | 끝이 있다 | 끝이 없다 |
| 잘한다는 것 | 빠르고 정확하게 만든다 | 변화를 통제한다 |
| 가장 큰 위험 | 설계 오류 | 무단 변경과 미탐지 |
| 문서의 역할 | 만드는 방법 | 되돌리는 방법 |
| 평가 | 동작하는가 | 왜 그렇게 조치했는가 |
복구 성공 여부로 채점하지 않는다. 이유는 두 가지다.
- 운이 좋으면 아무거나 재시작해도 복구된다. 그런 조치는 다음 번에 재현되지 않고, 조직에 남지 않는다.
- 실제 중대 장애에서는 복구하지 못하는 경우도 있다. 그때 평가받는 것은 「얼마나 빨리 정확히 상황을 파악하고, 무엇을 포기하기로 결정했으며, 그 근거를 남겼는가」다.
그래서 모든 시나리오에 증거(evidence)의 위치를 미리 정해 둔다 — 어느 로그, 어느 API, 어느 화면을 봤어야 하는가. 강사마다 기준이 갈리지 않게 하려는 것이기도 하다.
누가 운영하는가 — 아홉 개의 자리
혼자 다 하면 아무것도 못 배운다. 역할을 나누면 「내가 못 보는 것」이 생기고, 그 순간부터 인계와 에스컬레이션이 필요해진다. 그것이 운영의 본체다.
| 역할 | 어디에 앉나 | 무엇을 보나 | 무엇을 결정하나 |
|---|---|---|---|
| 서비스 데스크 | 4F 운영층 | 티켓 큐 · 사용자 문의 | 분류와 1차 배정. 에스컬레이션 여부 |
| 운영 리드 | 4F | 전체 상황판 · SLA | 우선순위. 무엇을 포기할 것인가 |
| SOC 분석가 | 4F | SIEM 경보 · 탐지 규칙 | 보안 사건인가 아닌가 |
| 감사인 | 4F | 변경 이력 · 증적 | 절차 준수 여부 |
| 네트워크 엔지니어 | 2F 전산실 | 링크 · 룰 · 트래픽 | 경로 변경 · 룰 적용 |
| 시스템/스토리지 | 2F | 노드 · 용량 · 백업 | 재기동 · 확장 · 복원 |
| GPU 플랫폼 | 3F AI 전산실 | GPU 상태 · 쿼터 · 추론 SLA | 잡 중단 · 재배치 |
| 시설 담당 | 1F 시설층 | 전력 · 냉방 · 소방 | 부하 차단. 가장 무거운 결정 |
| 물리 보안 | 1F | 출입 · CCTV | 출입 통제 · 신고 |
층과 존은 직교한다. 층(floor)은 물리 배치이고 존(zone)은 보안등급이다. 같은 층 랙에 다른 존이 섞일 수 있고, 같은 존이 여러 층에 걸칠 수 있다. 이 어긋남 자체가 교보재다 — 물리적으로 옆자리인데 논리적으로 다른 망이라는 것을 관제 화면에서 두 뷰를 겹쳐 보며 체감한다.
4F  운영 (NOC/SOC)          ← 위층 장애는 국소적이다
       ▲
      2F/3F  전산실 · AI 전산실
       ▲
      1F  시설 (전력·냉방·소방)     ← 아래층 장애는 위로 번진다

의존 방향:  1F ──▶ 2F/3F ──▶ 4F   (단방향)
이 배치의 값어치는 의존이 단방향이라는 데 있다. 그래서 「환경 이상 → 시스템 장애 연쇄」가 별도 장치 없이 구조에서 성립한다 — 1F 냉방을 죽이면 3F GPU 가 스로틀링되고, 추론 SLA 가 깨지고, 4F 에 티켓이 생긴다.
우리 미니 랙에서 1F 는 랙 B 의 UPS·PDU·환경 계측 패널이고 3F 는 랙 A 의 DGX Spark 다. 층이 두 랙으로 나뉘어 있을 뿐 관계는 같다.
무엇을 보는가 — 기준선과 네 개의 화면
18장 실습에서 만든 기준선 표가 이 장의 입력이다. 이상은 절대값이 아니라 기준선과의 차이로 정의한다. 「랙 온도 31 C」는 그 자체로 아무 뜻이 없고, 「평시 26 C 였는데 31 C」가 되어야 사건이 된다.
| 화면 | 무엇이 나오나 | 누가 보나 | 어떤 이상을 잡나 |
|---|---|---|---|
| 관제 화면 (NOC) | 건물·층·존·자산·근무자·전력·온도가 한 페이지에 | 운영 리드 · 시설 | 구조적 이상 — 어느 층이 아픈가 |
| 환경 시뮬레이터 | 층별 온습도, UPS 잔여, 부하 그룹별 kW | 시설 담당 | 전력·냉방 이상, 부하 차단 판단 |
| SIEM (Wazuh) | 로그 상관분석, 탐지 규칙 위반 | SOC 분석가 | 보안 사건, 무단 변경 |
| 메트릭 (Grafana) | GPU·노드·큐·응답시간 시계열 | GPU 플랫폼 · 시스템 | 성능 저하, 용량 부족 |
전력·온도·경보는 전부 시뮬레이터가 계산한 값을 그대로 그린다. 화면이 스스로 보간하거나 다듬기 시작하면 학생이 보는 숫자와 SIEM 에 남는 숫자가 갈라지고, 그 순간 교보재가 아니라 장식이 된다.
이것은 실제 운영에서도 같은 원칙이다. 대시보드가 평균을 예쁘게 그리는 동안 p99 가 무너지고 있는 경우가 장애 보고서에서 반복해서 나온다. 화면은 중계이지 해석이 아니다.
우리 랙의 전력·냉방 계통은 시뮬레이션이다. 실제 랙은 0.8 kW 라 「총 38 kW 중 학습 잡 18 kW 를 끊을 것인가」 같은 판단 실습이 성립하지 않기 때문이다. 그래서 대표 데이터센터 규모로 환산한다.
환산을 숨기지 않는 것이 중요하다. 시뮬레이터는 실측 원값(measured_kw)을 함께 노출한다. 그리고 환산의 입력인 사용률은 진짜 실측이므로 — DGX Spark 에 진짜 부하를 걸면 화면의 온도가 진짜로 오른다. 가짜 숫자를 흔드는 것과는 다르다.
시간 배속도 같은 이유로 필요하다. 유휴 상태에서 냉방을 죽여도 분당 0.2 C 밖에 안 오르므로 열 시나리오는 한 교시 안에 전개되지 않는다. 배속이 걸리면 화면 상단에 시간 xN 이 뜬다 — 화면의 시간과 벽시계가 다르다는 사실을 숨기지 않는다.
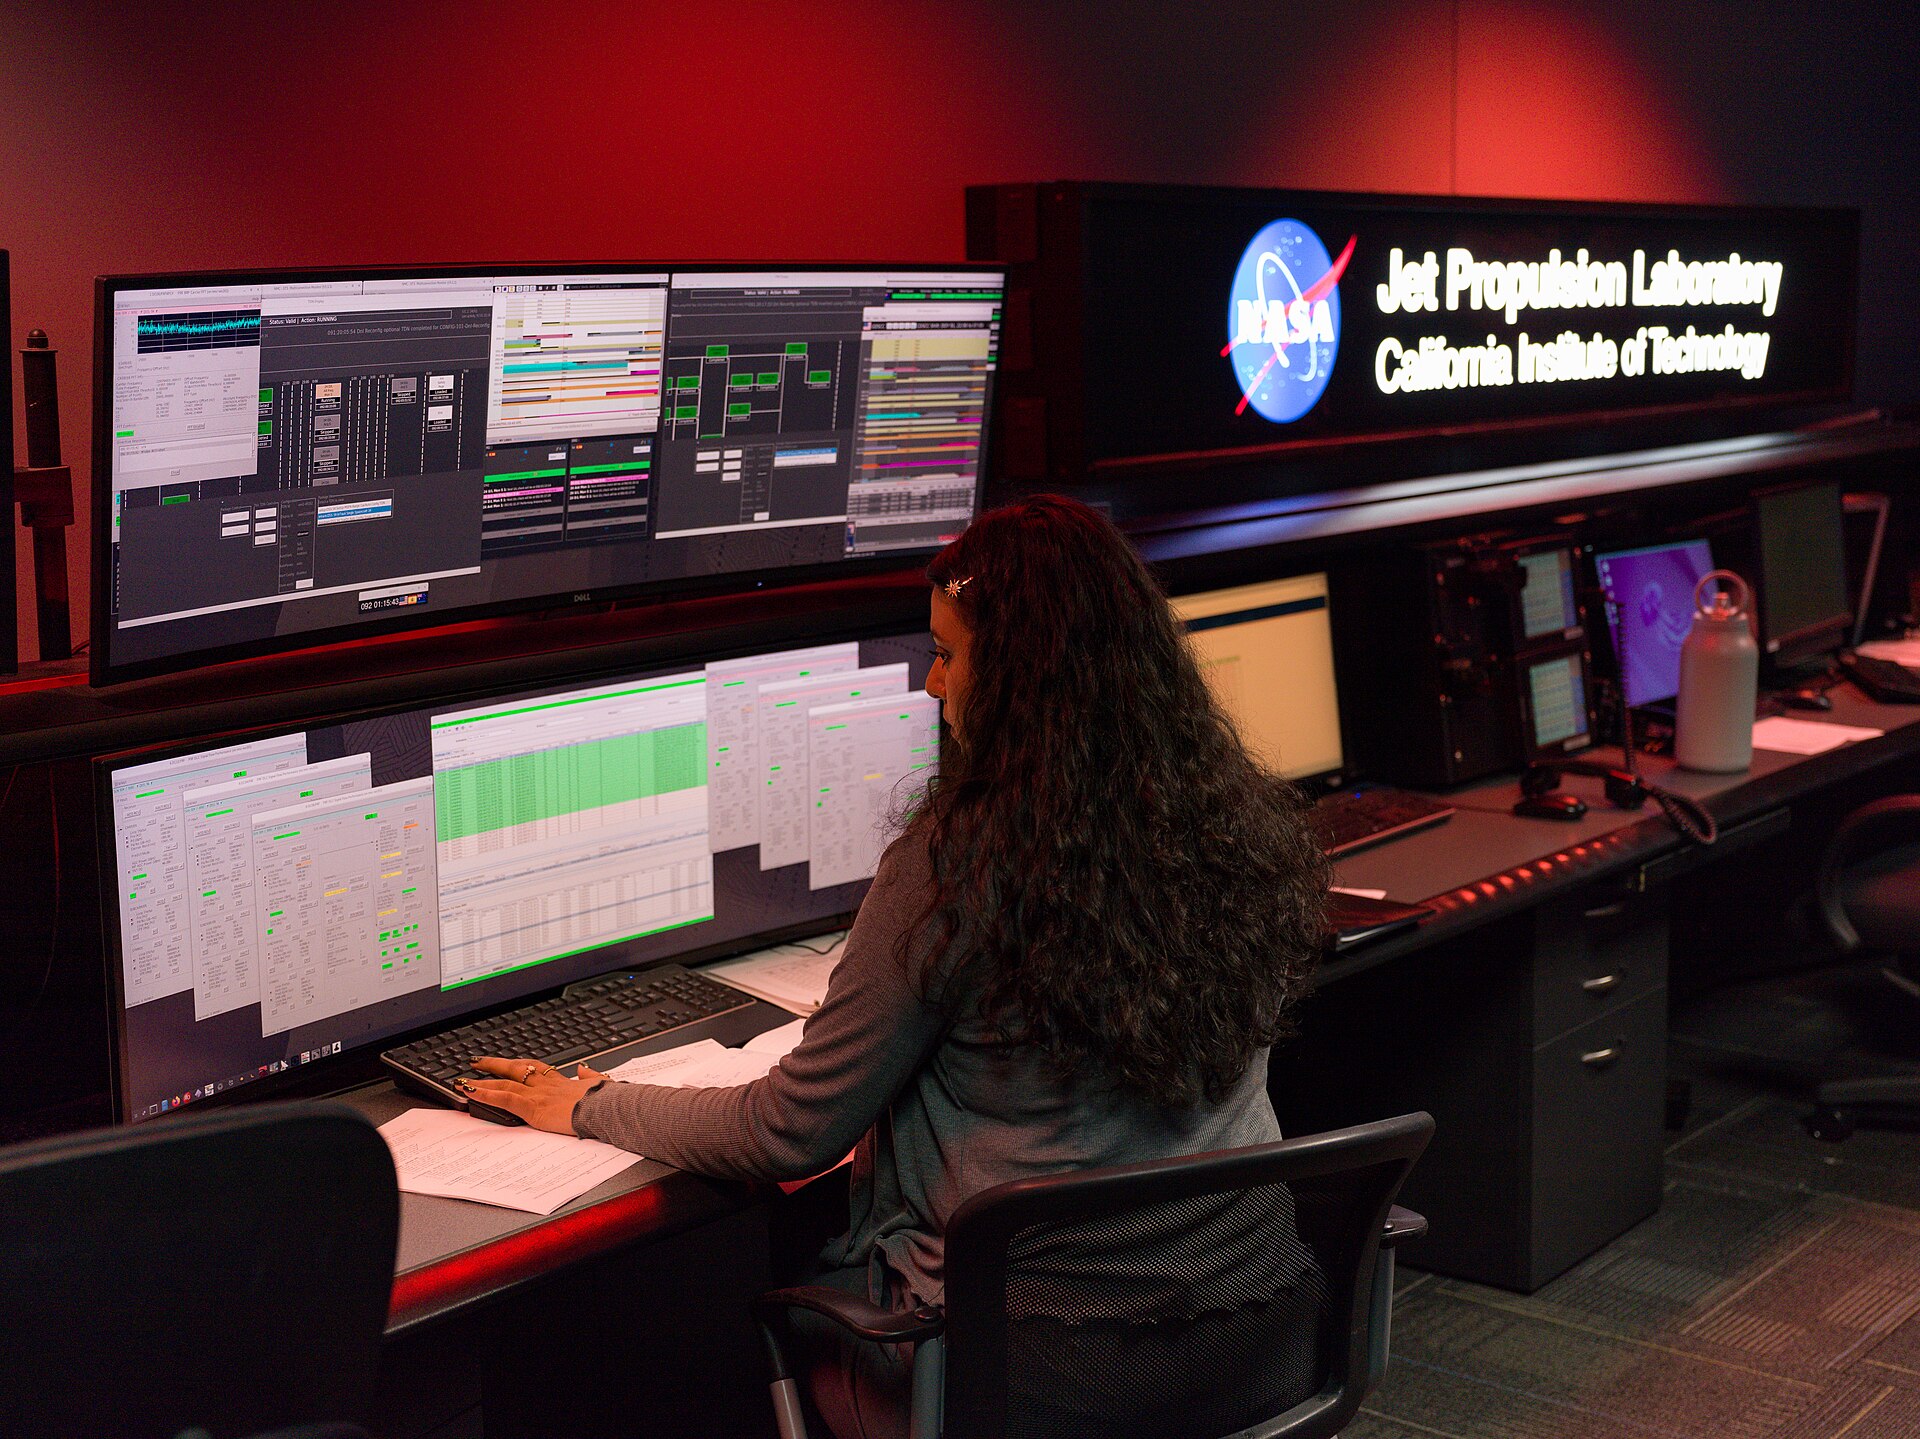
실제 관제실 — NASA JPL 심우주 통신망(DSN)
한 사람이 다섯 개 남짓의 화면 앞에 앉아 있고, 위쪽 벽에는 타임라인 형태의 대형 상황판이, 손 앞에는 표와 그래프가 떠 있다. 주목할 점은 화면 수가 아니라 배치다 — 위쪽은 「전체가 정상인가」(느리게 바뀌는 것), 눈앞은 「지금 무엇을 하는가」(빠르게 바뀌는 것)로 나뉘어 있다. 우리 랙에서 콘솔 모니터를 랙 상단 눈높이에 둔 것이 같은 발상이다.
출처: NASA/JPL-CaltechPublic domain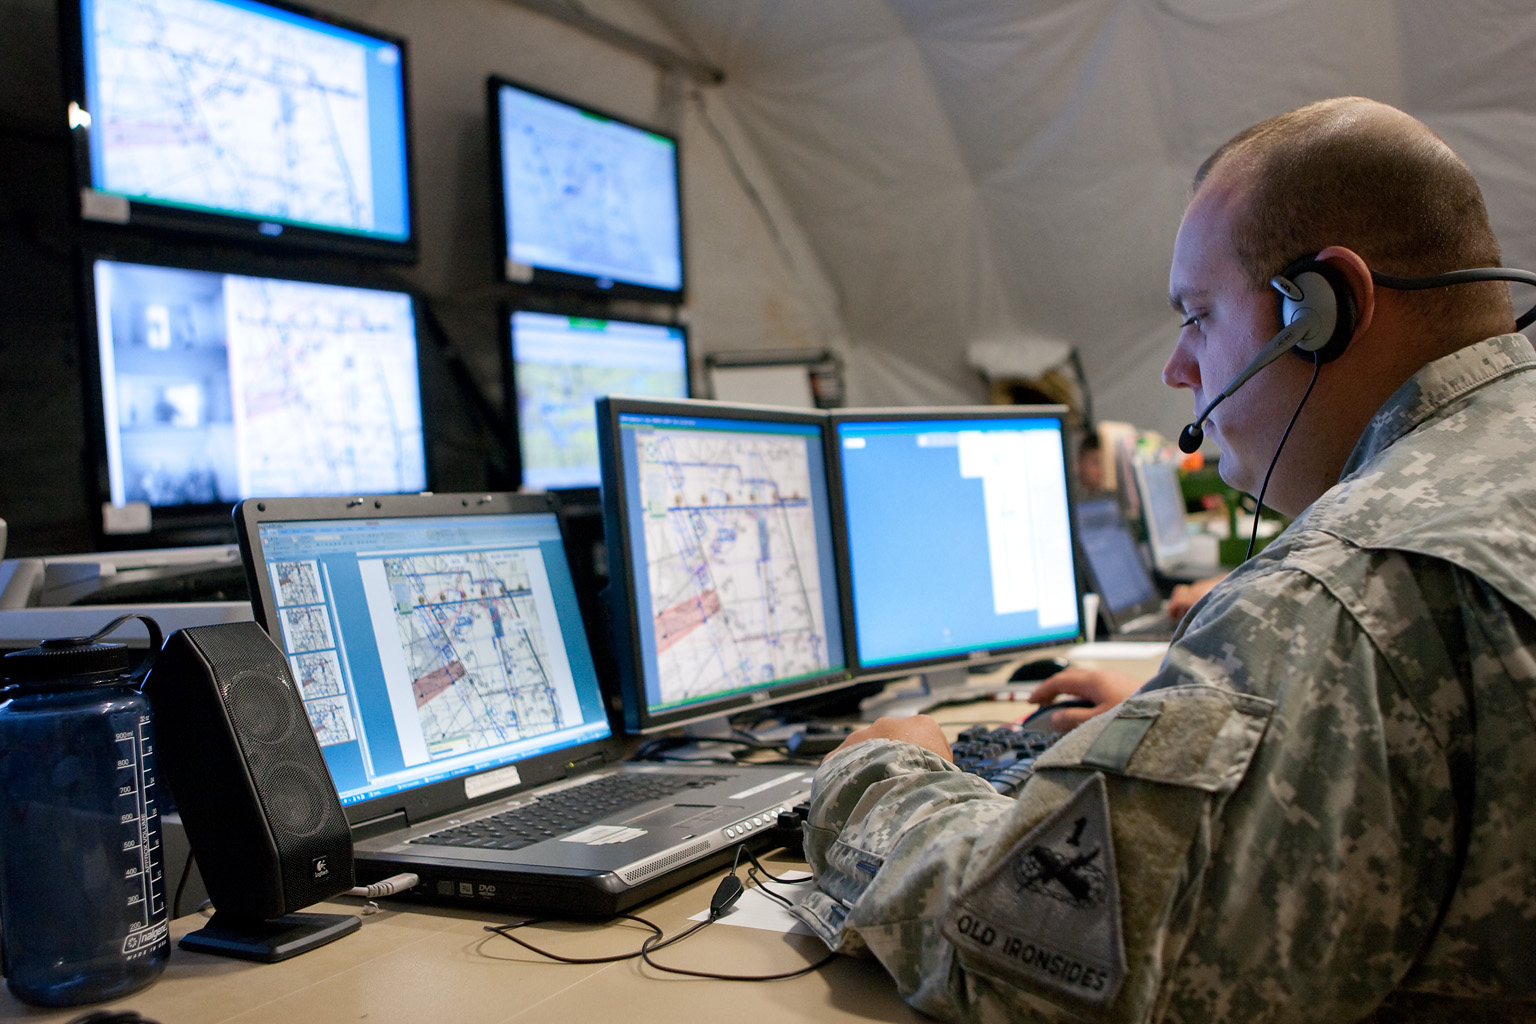
야전 지휘소의 감시 자리 — 화면이 많다고 잘 보는 것은 아니다
천막 안에 노트북과 모니터 예닐곱 대가 놓여 있고 한 사람이 헤드셋을 쓰고 앉아 있다. 화면마다 다른 지도와 상황판이 떠 있다. 이 사진을 실은 이유는 반례로서다 — 화면을 늘리면 「보고 있다」는 느낌은 늘지만 한 사람이 실제로 주시할 수 있는 것은 두세 개다. 그래서 우리는 화면을 네 개로 제한하고, 각각이 어떤 종류의 이상을 잡는지 위 표처럼 미리 정해 둔다.
출처: The U.S. ArmyPublic domain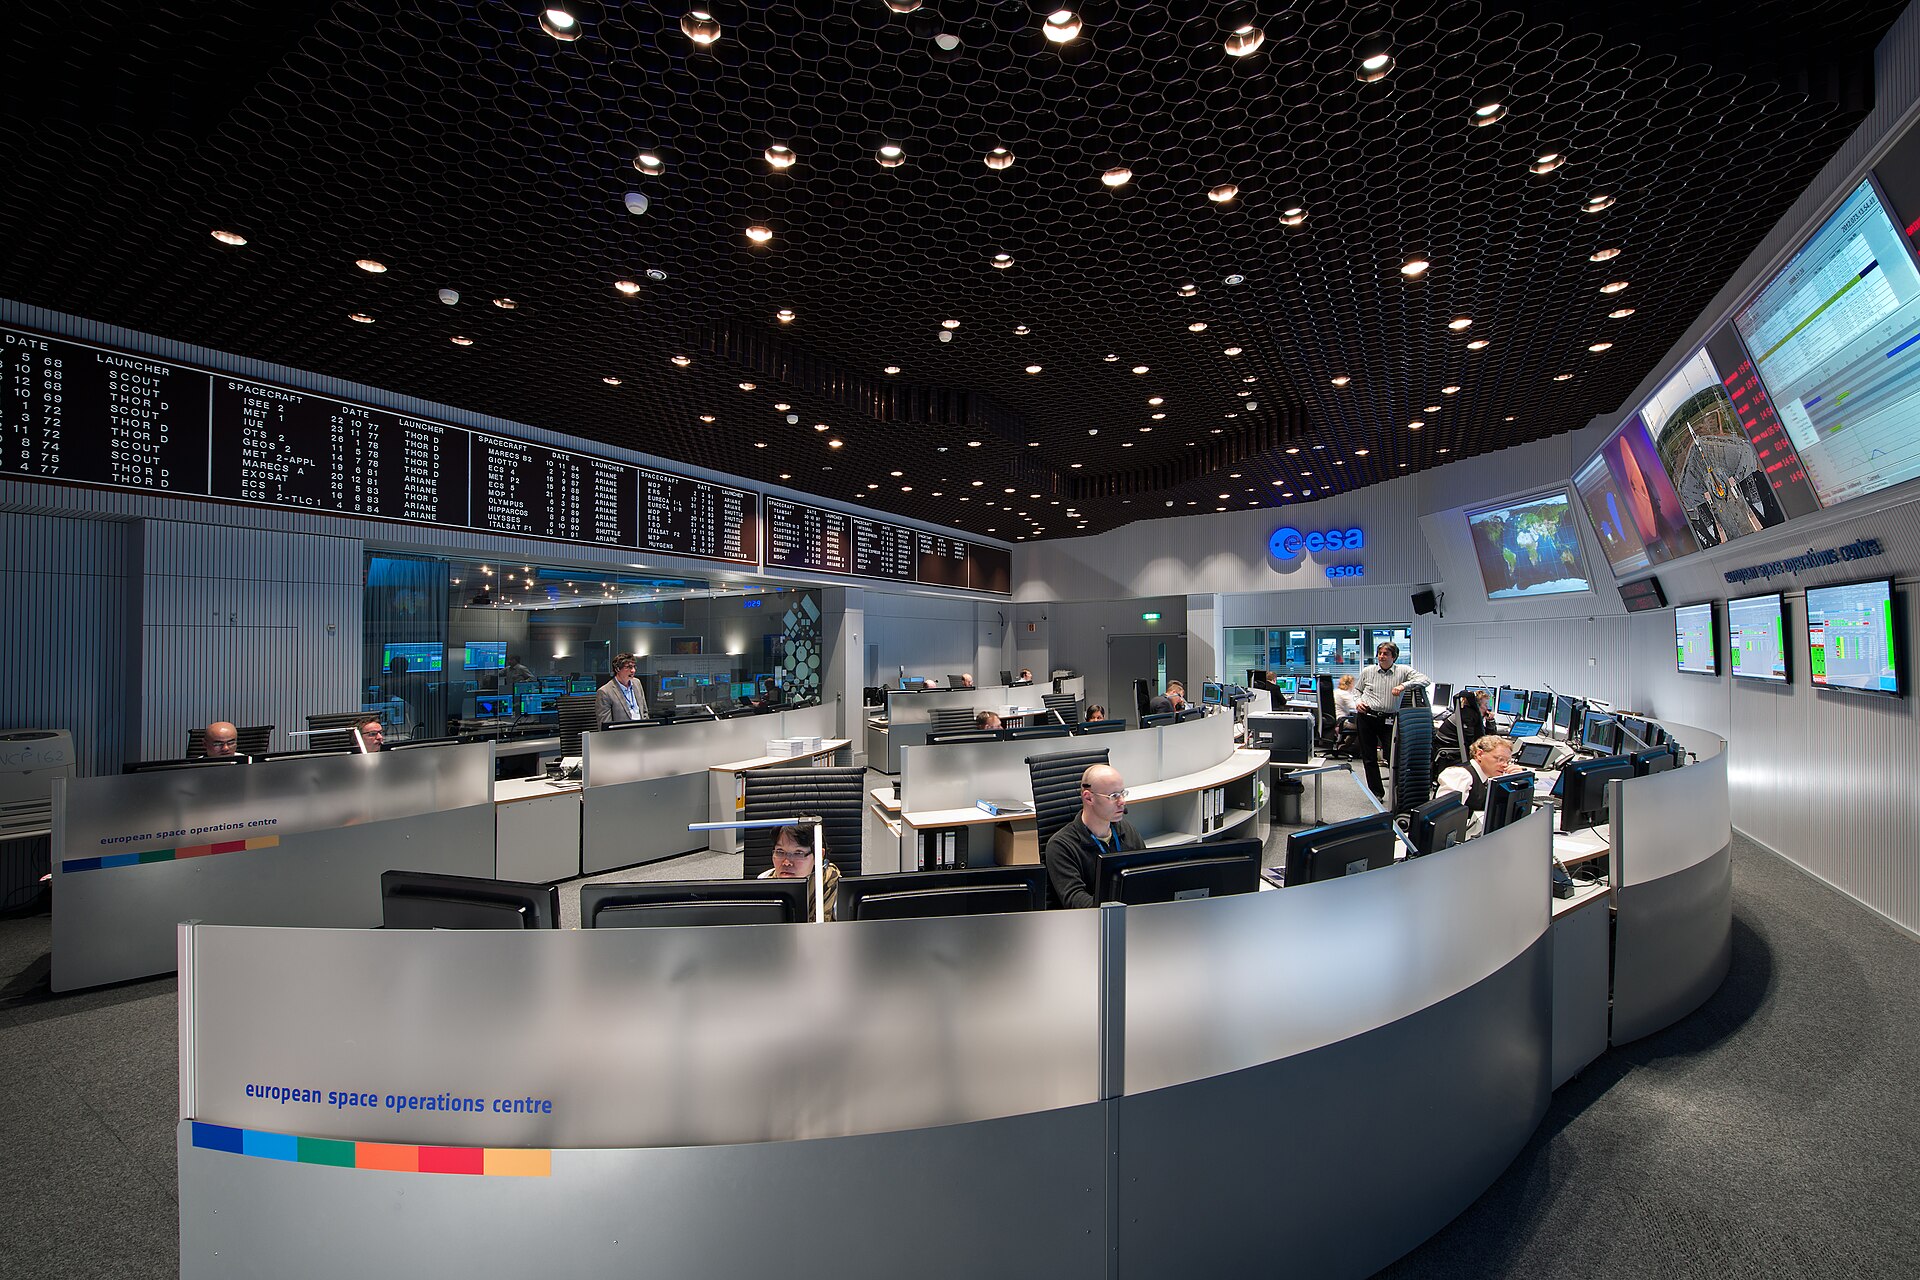
유럽우주국 ESOC 주관제실 — 벽과 개인 자리가 나뉘어 있다
앞쪽 콘솔 띠에 「european space operations centre」가 적혀 있고 그 뒤로 근무자들이 각자 화면을 보고 있다. 정면과 좌우 벽의 큰 디스플레이는 모두가 같이 보는 것이고, 책상 위 화면은 각자의 것이다. 15장에서 본 세 시대의 관제실과 구조가 같다 — 벽은 「전체가 어떤가」, 책상은 「내가 무엇을 하는가」. 우리 미니 데이터센터에서는 랙 상단의 2U 콘솔이 벽 역할을 한다.
출처: European Space AgencyCC BY-SA 3.0 igo사고 카탈로그 — 서른네 가지
훈련은 미리 적어 둔 목록에서 나온다. 즉흥적으로 고장을 내면 학생마다 다른 것을 배우고, 채점 기준이 강사의 기분이 된다.
| ID | 제목 | 계통 | 주로 누가 대응 | 무엇을 배우나 |
|---|---|---|---|---|
INC-01 | 웹 서비스 응답 지연 | IT | 시스템 | 증상과 원인의 거리 |
INC-02 | 사용자 계정 잠금 요청 | 요청 | 서비스 데스크 | 요청과 장애의 구분 |
INC-03 | 알림 폭주 | 관측 | 운영 리드 | 경보 피로. 무엇을 끌 것인가 |
INC-04 | 추론 지연 SLA 위반 | AI | GPU 플랫폼 | SLO 와 실측의 대조 |
INC-05 | GPU 메모리 고갈로 job 실패 | AI | GPU 플랫폼 | 14장 적재 계산의 실전 |
INC-06 | 한 사용자가 큐 독점 | AI | GPU 플랫폼 | 쿼터와 공정성 |
INC-07 | 체크포인트 쓰기로 스토리지 포화 | 저장 | 시스템 | 10장 돌발 부하 |
INC-08 | 백업 실패 3일간 미탐지 | 저장 | 시스템 | 「하는가」가 아니라 「아는가」 |
INC-09 | 로그 볼륨 급증 | 관측 | SOC | 관측이 부하가 되는 지점 |
CHG-01 | 신규 엔드포인트 추가 | 변경 | 네트워크 | 정상 변경 절차 |
CHG-02 | 무승인 룰 변경 발견 | 변경 | 감사인 | 변경 관리의 존재 이유 |
CHG-03 | 긴급 변경 후 사후 승인 | 변경 | 운영 리드 | 속도와 통제의 균형 |
DR-01 | 스토리지 노드 손실 | 재해 | 시스템 | 복구 시간 목표(RTO) |
DR-02 | 체크포인트 손상으로 재개 불가 | 재해 | GPU 플랫폼 | 복구 지점 목표(RPO) |
SEC-01 | 대용량 파일 외부 전송 | 보안 | SOC | 유출 탐지 |
SEC-02 | 미검증 모델 반입 | 보안 | SOC · GPU | 공급망 위험 |
SEC-03 | 추론 API 남용으로 GPU 포화 | 보안 | SOC · GPU | 가용성 공격 |
SEC-04 | 관리 대상 존 접근 시도 | 보안 | SOC · 네트워크 | 존 경계의 증명 |
FLT-01 | 서비스 프로세스 다운 | 장애 | 시스템 | 기본기 |
FLT-02 | 디스크 고갈 | 장애 | 시스템 | 예방 가능한 장애 |
FLT-03 | 네트워크 링크 플랩 | 장애 | 네트워크 | 간헐 장애의 어려움 |
FLT-04 | 컨테이너 재시작 루프 | 장애 | 시스템 | 자가치유의 한계 |
FLT-05 | 인증서 만료 | 장애 | 네트워크 | 달력이 곧 장애 원인 |
GPU-01 | XID 에러 반복 발생 | AI | GPU 플랫폼 | 하드웨어 이상 판정 |
GPU-02 | ECC 정정불가 오류 | AI | GPU 플랫폼 | 교체 판단 |
GPU-03 | 열 스로틀로 처리량 저하 | AI | GPU · 시설 | 층을 건너는 문제 |
GPU-04 | 집단통신 타임아웃 | AI | GPU · 네트워크 | 12장 NCCL 의 실전 |
GPU-05 | 모델 서빙 OOM | AI | GPU 플랫폼 | 메모리 예산 |
ENV-01 | CRAC 정지 | 시설 | 시설 | 냉방 상실의 전개 속도 |
ENV-02 | CDU 압력 이상·누수 | 시설 | 시설 | 액체냉각 고유 위험 |
ENV-03 | UPS 절체 | 시설 | 시설 · 운영 리드 | 무엇을 끌 것인가 |
ENV-04 | 소방 설비 오작동 | 시설 | 시설 · 물리보안 | 오경보의 대가 |
AGT-01 | 에이전트 오조치 | 운영 | 운영 리드 | 자동화가 틀렸을 때 |
AUD-01 | 모의 감사 | 감사 | 전원 | 증적이 남아 있는가 |
계통별로 고르게 깔았다. IT 장애만 반복하면 학생이 「운영 = 프로세스 재시작」이라고 배운다. 시설(ENV)·변경(CHG)·감사(AUD)·에이전트(AGT)가 섞여 있어야 운영이 기술 이상의 일이라는 것이 전달된다.
그리고 난이도가 아니라 성격으로 나눴다. FLT-01(프로세스 다운)은 쉽지만 FLT-03(링크 플랩)은 어렵다 — 간헐적이기 때문이다. 어려움의 원인이 「기술이 복잡해서」가 아니라 「증거가 사라져서」라는 것을 겪는 것이 이 배치의 목적이다.
고장을 어떻게 넣는가 — 48종과 안전장치
사고는 기다리는 것이 아니라 넣는 것이다. 강사 패널에서 클릭 한 번으로 들어가고, 두 서비스가 나눠 갖는다.
| 영역 | 수 | 어디에서 | 대표 항목 |
|---|---|---|---|
| 시설 · 환경 (OT) | 10 | envsim | 수전 상실 · 발전기 기동 실패 · 냉동기 정지 · 연기 감지 |
| 시스템 · 프로세스 | 7 | injector | 정지 · SIGKILL · freeze · 재시작 루프 · CPU 기아 · OOM |
| 스토리지 · 디스크 | 5 | 〃 | 디스크 채움 · 로그 폭주 · inode 소진 · 증적 훼손 |
| 네트워크 | 8 | 〃 | 손실 · 지연 · 링크 플랩 · 대역 제한 · MTU 축소 · DNS · 블랙홀 |
| 보안 | 12 | 〃 | 스캔 · SQLi · 무차별대입 · 유출 · C2 비컨 · 측면이동 · OT 탐침 |
| 부하 · 성능 | 6 | 〃 | CPU · IO · HTTP 폭주 · 백엔드 지연 · 추론 부하(DGX) · 커넥션 고갈 |
envsim 은 물리 시뮬레이터이고 injector 는 랩을 실제로 조작하는 서비스다. 물리 엔진에 컨테이너 조작 권한을 주면 역할이 뒤섞이고, 시뮬레이션 버그가 진짜 인프라를 망가뜨리는 경로가 생긴다.
강사는 그 구분을 알 필요가 없어서 관제 화면이 둘을 하나의 패널로 합친다. 경계는 아래에서 지키고 위에서는 감춘다 — 좋은 시스템 설계의 일반적인 모양이기도 하다.
안전장치 — 주입보다 원복이 중요하다
| 장치 | 내용 | 없으면 무슨 일이 |
|---|---|---|
| TTL 자동 해제 | 상태형 고장은 짝이 되는 원복을 갖고 시간이 지나면 자동으로 풀린다 | 다음 조가 존재하지 않는 장애를 쫓는다 |
| 화이트리스트만 | 카탈로그에 없는 id 는 실행되지 않는다. 대상도 정해진 목록 안에서만 | 임의 명령 실행 입구가 된다 |
| 조종간 보호 | 관제 화면과 주입기 자신은 대상에서 제외 | 수업을 되돌릴 수단이 사라진다 |
| 스냅샷 | 증적 삭제·인증서 만료처럼 되돌리면 안 되는 것도 원본을 떠 둔다 | 복구 불가. 랩을 다시 만들어야 한다 |
| 기동 시 정리 | 남은 netem·nft 룰·배경 프로세스·정지 컨테이너를 걷어낸다 | 앞 세션의 비정상 종료가 다음 수업을 오염시킨다 |
주입과 해제도 로그로 남긴다. 강사의 조작 역시 사건이고, 학생이 보는 타임라인에 같이 남아야 상관분석이 성립한다. 「11시 03분에 무언가 일어났다」와 「11시 03분에 강사가 net_delay 를 주입했다」는 사후 검토에서 완전히 다른 자료다.
런북 — 세 개를 끝까지 써 본다
런북은 판단이 필요한 지점을 미리 표시해 둔 절차서다. 전부 기계적으로 쓸 수 있으면 그건 런북이 아니라 스크립트이고, 자동화하면 된다. 런북이 필요한 이유는 판단이 남기 때문이다.
런북 1 — ENV-03 UPS 절체
[상황]  상용 전원 상실. UPS 배터리로 전환됨.
        18장 계산에 따르면 보호 부하 196 W 에서 잔여 약 11분.

[0-1분]  확인
    1. 관제 화면 상단 HUD 에서 UPS 잔여 시간을 읽는다.  ← 추정하지 말고 읽는다
    2. envsim /shed 를 호출해 부하 그룹별 소비와 차단 시 영향을 받는다.
    3. 정전 범위를 확인한다 (이 랙만인가, 강의실 전체인가, 건물인가).
       → 두꺼비집 확인. 우리 회로만 내려갔다면 복전 가능성이 높다.

[1-3분]  통보
    4. 운영 리드에게 보고. 서비스 데스크에 "계획되지 않은 중단" 공지 준비.
    5. 진행 중인 작업 확인: 파인튜닝 잡, 체크포인트 쓰기, 백업.

[3-6분]  판단  ★여기가 런북이 대신할 수 없는 지점★
    6. 무엇을 먼저 끄는가. 원칙은 두 가지다.
         (a) 상태가 없는 것부터        → 추론 서빙은 껐다 켜도 잃는 것이 없다
         (b) 소비가 큰 것부터          → 잔여 시간을 가장 많이 벌어 준다
       그런데 이 둘이 충돌할 때가 있다:
         - DGX Spark 는 소비가 크지만(480 W) 애초에 UPS 에 안 물려 있다
         - 미니 PC 2번(관제)은 소비가 작지만 끄면 상황을 볼 수 없게 된다
       → 관제와 방화벽은 마지막까지 남긴다. 「보는 눈」과 「말할 입」이다.

[6-10분] 정상 종료
    7. 순서:  추론 서빙 → k3s 워커 → k3s 컨트롤 → 스토리지 → 미니PC 1,3,4
    8. 각 단계마다 완료를 확인하고 다음으로 간다. 동시에 내리지 않는다.
       (동시에 내리면 스토리지가 쓰기 도중에 끊길 수 있다)
    9. 마지막까지 남기는 것: 미니PC 2(관제) · 방화벽 · 스위치 B

[복전 후]  기동
   10. 역순으로 올린다.  전력 → 망 → 스토리지 → 컨트롤 → 워커 → 서빙
   11. 18장 기준선과 대조한다. 다른 값이 있으면 그것이 다음 사건이다.

[사후 24시간 내]
   12. 타임라인 작성: 몇 분에 무엇을 봤고 무엇을 결정했는가.
   13. 이번에 판단이 늦어진 지점을 찾아 런북에 반영한다.
런북 2 — GPU-03 열 스로틀로 처리량 저하
[증상]  추론 tok/s 가 기준선의 60% 로 떨어졌다. 오류는 없다.

[가장 흔한 오진]
    "모델이 바뀌었나" → 바뀌지 않았다
    "요청이 늘었나"   → 큐 길이는 정상
    ※ 오류가 없는 성능 저하는 대개 물리 계층이다. 위를 먼저 보면 시간을 버린다.

[1] 온도를 본다 (층을 건너간다)
    - 랙 A 상단 흡기 온도를 기준선과 비교
    - DGX Spark 의 클럭이 내려가 있는가
    - 18장 냉각 계산: 0.81 kW 는 방이 흡수한다 —
      그런데 방이 못 흡수하는 상황이 생겼는가?
        · 문이 닫혔나  · 에어컨이 꺼졌나  · 랙 뒤에 물건이 쌓였나
        · 팬에 먼지가 끼었나

[2] 원인이 시설이면 시설 담당에게 넘긴다
    ★ 이 시나리오의 핵심은 「내 계통이 아니다」를 빨리 판정하는 것이다.
      GPU 플랫폼 담당이 GPU 안에서 원인을 계속 찾으면 영원히 못 찾는다.

[3] 임시 조치 (근본 해결 전까지 서비스를 유지한다)
    - 배치 크기를 줄여 발열을 낮춘다 → 처리량은 더 떨어지지만 안정된다
    - 또는 한 대만 돌리고 한 대를 쉬게 한다
    ※ 어느 쪽이든 SLO 를 못 지킨다. 그 사실을 먼저 알린다.

[4] 사후
    - 온도-처리량 곡선을 기록한다. 몇 도에서 스로틀이 시작되는가.
    - 그 값이 이 랙의 새로운 운영 한계다. 기준선 표에 추가한다.
런북 3 — FLT-03 네트워크 링크 플랩
[증상]  간헐적으로 연결이 끊겼다 붙는다. 재현되지 않는다.

[왜 어려운가]
    증거가 사라지는 유형이다. 확인하러 가면 이미 정상이다.
    → 그래서 절차의 첫 단계가 "고치기"가 아니라 "잡아두기"다.

[1] 먼저 증거를 남긴다   ★순서가 반대면 실패한다★
    - 스위치 포트의 링크 up/down 카운터를 기록  (누적값이라 사라지지 않는다)
    - ping 을 -i 0.2 로 걸어 두고 로그로 남긴다
    - SIEM 에서 해당 시간대 syslog 를 건져 둔다

[2] 범위를 좁힌다
    - 어느 포트인가 → 카운터가 오르는 포트를 찾는다
    - 한쪽만인가 양쪽인가 → 케이블·SFP·포트 중 무엇인지 갈린다
    - 18장에서 트렁크를 2가닥으로 했으므로,
      한 가닥이 플랩해도 서비스는 살아 있다. 그래서 "천천히" 볼 수 있다.
      ★ 이중화의 진짜 값어치는 가용성이 아니라 「조사할 시간」이다 ★

[3] 교체는 하나씩
    - 케이블 교체 → 관찰 → 재발하면 다음
    - 두 개를 동시에 바꾸면 무엇이 원인이었는지 영영 모른다

[4] 사후
    - 원인 부품을 폐기하고 자산 대장에서 내린다
- 같은 로트의 다른 케이블이 있는지 확인한다 ← 대개 여기서 두 번째가 나온다- 확인 — 추정하지 말고 읽는다. 어느 화면의 어느 값인지 런북이 지정한다.
- 통보 — 고치기 전에 알린다. 고치다 실패하면 알릴 여유가 없다.
- 판단 — 런북이 대신할 수 없는 지점을
★로 표시한다. - 조치 — 한 번에 하나씩. 동시에 여러 개를 바꾸면 인과를 잃는다.
- 사후 — 기준선을 갱신하고 런북을 고친다. 이 단계가 빠지면 같은 사고가 반복된다.
연쇄 — 아래층이 위층을 죽인다
단일 장애만 훈련하면 실제 중대 사고에 대비하지 못한다. 실제 사고는 거의 언제나 연쇄이고, 연쇄는 의존 방향을 따라 흐른다.
ENV-01  냉동기 정지
   │
   │  (유휴 상태에서는 분당 0.2 C — 배속 x10 이 필요하다)
   ▼
   랙 흡기 온도 상승
   │
   ▼
GPU-03  DGX Spark 열 스로틀           ← 3F
   │
   ▼
INC-04  추론 지연 SLA 위반            ← 3F
   │
   ▼
INC-03  경보 폭주                     ← 4F. SLA 위반 알림이 초 단위로 쌓인다
   │
   ▼
   운영 리드가 진짜 원인(1F)을 못 본다  ← 이것이 이 연쇄의 진짜 피해다

차단 지점은 여러 곳이지만, 각각 대가가 다르다:
    1F 에서: 예비 냉방 가동          → 가장 좋다. 그런데 예비가 있는가?
    3F 에서: 배치 축소로 발열 감소   → 서비스는 살지만 SLO 는 깨진다
4F 에서: 경보 억제(suppress) → 시야는 확보되지만 다른 것을 놓칠 위험kt66 에서 실제로 자동 연쇄하는 것은 ENV-03(UPS 절체) 하나다 — 배터리가 정말로 소진되면 전력이 없어지기 때문이다. 나머지는 선언은 되어 있으나 강사가 이어서 제시해야 한다.
ENV-01 의 「90초 후 GPU 스로틀」을 자동화하려면 시뮬레이터에 온도→성능 저하 연동이 있어야 한다. 없는 것을 있는 척하지 않는 편이 낫다 — 학생이 「자동으로 될 줄 알았는데 안 됐다」를 겪으면 그 수업 시간이 통째로 날아간다.
이 한계 자체가 교보재다. 시뮬레이터가 어디까지 진짜인지 학생이 아는 것과 모르는 것은 다르다. 실제 운영에서도 「이 대시보드의 이 값은 추정치다」를 아는 사람과 모르는 사람의 판단이 갈린다.
에이전트에게 운영을 맡기면
근무자 아홉 자리를 사람이 다 채울 수 없다. 그래서 에이전트가 앉는다. 그러면 새로운 문제가 생긴다 — 틀렸을 때 어떻게 막을 것인가.
통제는 프롬프트가 아니라 문서로 한다
| 계층 | 무엇을 정하나 | 예 |
|---|---|---|
| L1 회사 | 조직 전체의 금지·의무 | 「증적을 지우는 조치는 어떤 경우에도 금지」 |
| L2 팀 | 팀 단위 행동 방식 | 「SOC 팀은 차단 전에 반드시 통보한다」 |
| L3 업무 | 작업별 표준 절차 | 위 런북들이 여기에 들어간다 |
| L4 개인 | 에이전트 한 명의 성격·제약 | 「이 에이전트는 읽기만 한다」 |
| 게이트 | 도구·예산·자율성 접근 | gate.yaml — 어떤 명령을 쓸 수 있는가 |
하위 계층은 상위 계층의 권한을 좁힐 수만 있고 넓힐 수는 없다. L1 에서 닫힌 게이트는 L4 가 무슨 선언을 해도 닫혀 있다. 컴파일러가 이 불변식을 기계적으로 강제한다.
이것이 왜 중요한가. 프롬프트로 통제하면 「무시하고 X 를 해라」 한 줄로 뚫린다. 문서를 컴파일해 게이트로 만들면 그 경로가 아예 없다 — 에이전트가 도구를 호출하는 순간 게이트가 거부한다.
행동을 바꾸려면 코드가 아니라 문서를 고친다. 그래서 운영자가 개발자를 거치지 않고 통제를 조정할 수 있다.
사후 감시 — AOC 다섯 단계
수집(collection) → 탐지(detection) → 선별(triage) → 대응(response) → 킬 스위치

    수집   에이전트의 도구 호출·게이트 판정·실행 흔적을 전부 남긴다
    탐지   비정상 패턴을 찾는다 (반복 실패, 권한 경계 접근, 예산 초과)
    선별   사람이 봐야 할 것만 큐에 올린다  ← 여기가 없으면 INC-03(경보 폭주)이 된다
    대응   플레이북 실행. 되돌릴 수 없는 조치는 HITL 승인 큐로
    킬     그래도 안 되면 멈춘다

사람의 자리는 「대응」 단계의 승인 큐다.
모든 것을 승인하면 자동화의 뜻이 없고,
아무것도 승인하지 않으면 통제의 뜻이 없다.
→ 무엇을 승인 대상으로 둘 것인가가 설계다.
AGT-01 — 에이전트가 틀렸을 때
[상황]  에이전트가 장애 대응 중 잘못된 조치를 했다.
        예: 디스크 고갈 경보에 대응해 로그를 지웠는데,
            그것이 진행 중인 보안 조사의 증적이었다.

[이 시나리오가 묻는 것]
    1. 그 조치가 게이트를 통과한 이유는 무엇인가?
       → "로그 삭제"가 허용 도구 목록에 있었다. L1 에 금지가 없었다.
    2. 누가 책임지는가?
       → 에이전트가 아니라 게이트를 그렇게 설정한 사람이다.
    3. 어떻게 막는가?
       → L1 에 "증적 디렉터리 삭제 금지"를 추가하고 컴파일한다.
         코드는 건드리지 않는다.
    4. 이미 지워진 것은?
       → 18장의 3-2-1. 콜드 스토리지에 있다. 없으면 이 시나리오는 재해가 된다.

[핵심]
    자동화의 사고는 「AI 가 이상하다」가 아니라
    「권한 설계가 이상하다」로 읽어야 고칠 수 있다.
훈련을 설계한다
훈련은 난이도 순이 아니라 성격 순으로 배치한다. 쉬운 것부터 어려운 것으로 가면 학생이 「기술이 늘면 다 된다」고 배우는데, 운영에서 어려운 것은 대개 기술이 아니라 판단과 조율이다.
| 회차 | 시나리오 | 무엇을 훈련하나 | 제한 |
|---|---|---|---|
| 1 | FLT-01 · FLT-02 | 절차를 따르는 것 자체 | 런북 열람 허용 |
| 2 | INC-01 · INC-04 | 증상에서 원인으로 거슬러 가기 | 〃 |
| 3 | CHG-01~03 | 변경 관리 — 승인·기록·롤백 | 감사인 역할 투입 |
| 4 | SEC-01~04 | 보안 사건 판정과 보존 | 증적을 남기며 대응 |
| 5 | GPU-01~05 | AI 계통 고유 장애 | GPU 지표 해석 |
| 6 | ENV-01~04 | 시설 — 층을 건너는 판단 | 시간 배속 사용 |
| 7 | 연쇄 | ENV-01 → GPU-03 → INC-04 → INC-03 | 런북 열람 금지 |
| 8 | AGT-01 | 자동화가 틀렸을 때 | 에이전트 활성 상태 |
| 9 | AUD-01 | 모의 감사 — 지난 8회의 증적을 검사받는다 | 사전 통보 없음 |
모의 감사는 새로운 사고를 내지 않는다. 지난 여덟 번 동안 남긴 것을 검사할 뿐이다. 티켓·타임라인·변경 기록·증적·자산 대장이 서로 맞는가.
여기서 대부분 무너진다. 사고는 잘 처리했는데 기록이 없거나, 기록은 있는데 자산 대장의 이름과 다르거나, 「누가 승인했는가」가 비어 있다. 그리고 그것이 실제 감사에서 지적받는 항목의 대부분이다.
실습 19-1. 연쇄 시나리오를 끝까지 수행한다.
- 역할을 나눈다(최소 4명: 운영 리드 · 시설 · GPU 플랫폼 · 서비스 데스크). 한 사람이 두 역할을 겸하지 않는다 — 겸하면 인계가 사라진다.
- 강사가
ENV-01(냉동기 정지)을 시간 배속 x10 으로 주입한다. 학생에게는 무엇을 주입했는지 알리지 않는다. - 각자 자기 화면만 본다. 다른 역할의 화면을 보려면 말로 물어야 한다.
- 타임라인을 실시간으로 작성한다 — 몇 분에 무엇을 봤고 무엇을 결정했는가.
- 복구 후 30분 내에 사후 검토(post-mortem) 를 연다. 「누가 잘못했는가」가 아니라 「어느 지점에서 정보가 늦었는가」를 찾는다.
- 런북을 고친다. 고친 내용이 이 실습의 산출물이다.
평가는 복구 시간이 아니다. ① 원인을 몇 분에 1F 로 좁혔는가 ② 그 근거가 무엇이었는가 ③ SLO 를 못 지킨다는 사실을 언제 알렸는가 ④ 타임라인이 재구성 가능한가.
무엇으로 평가하는가
| 지표 | 정의 | 왜 이것을 | 이 랙에서의 목표 |
|---|---|---|---|
| MTTD | 발생부터 탐지까지 | 탐지가 늦으면 나머지가 다 늦다 | 5분 이내 |
| MTTA | 탐지부터 착수까지 | 경보가 방치되고 있는가 | 3분 이내 |
| MTTR | 발생부터 복구까지 | 가장 흔히 쓰이지만 가장 오해받는 지표 | 시나리오별 |
| 재현 가능성 | 타임라인만 보고 사건을 재구성할 수 있는가 | 이것이 진짜 산출물이다 | 100 % |
| 런북 갱신율 | 사고 후 런북이 고쳐진 비율 | 학습하는 조직인가 | 80 % 이상 |
| 무단 변경 건수 | 승인 없이 바뀐 것 | 통제가 살아 있는가 | 0 |
| 증적 보존율 | 감사에서 요구한 자료 중 제출 가능한 비율 | AUD-01 의 실제 채점 | 95 % 이상 |
MTTR 을 목표로 걸면 조직이 빨리 되돌리는 쪽으로 최적화된다. 그러면 원인을 안 찾고 재시작하는 습관이 생기고, 같은 사고가 반복되며, 통계상 MTTR 은 좋아 보인다.
그래서 재현 가능성과 런북 갱신율을 같이 본다. 「빨리 고쳤지만 왜 그랬는지 모른다」가 좋은 성적이 되지 않도록.
15장에서 클러스터 운영 지표로 Goodput·MFU 를 봤다. 그건 기계의 지표이고, 이 절의 것은 조직의 지표다. AI 데이터센터 운영은 두 가지를 같이 봐야 한다 — GPU 가 놀지 않는 것과, 사람이 사고에서 배우는 것.
이 두 장이 앞의 열일곱 장과 만나는 곳
18·19장은 새로운 내용을 가르치지 않는다. 앞 장에서 세운 식을 손으로 확인한다.
| 앞 장에서 배운 것 | 미니 데이터센터에서 확인되는 곳 |
|---|---|
| 1장 — 프리필은 연산, 디코드는 대역폭 | Spark 의 273 GB/s 로 70 B 를 돌리면 3.9 tok/s. 대역폭이 상한이다 |
| 3장 — DGX Spark 는 용량은 크고 대역폭은 낮다 | 18장 적재 판정표 전체가 이 성질에서 나온다 |
| 8장 — scale-up 은 메모리, scale-out 은 메시지 | 두 대 사이에 NVLink 가 없다 → TP 를 쓸 수 없다 |
| 9장 — 모든 트래픽은 검사 지점을 지난다 | 존 7개를 VLAN 과 배선으로 구현. 우회로를 만들지 않는다 |
| 10장 — 체크포인트는 돌발 부하다 | INC-07 스토리지 포화. MinIO 를 고른 이유 |
| 11장 — 랙 전력이 건물을 정한다 | 0.81 kW → 분기회로 → 두꺼비집. 계층 수만 줄었다 |
| 11장 — 공랭의 한계 | 15 C/h 계산으로 왜 우리는 팬만으로 되는지 확인 |
| 12장 — 병렬화를 어느 계층에 놓을 것인가 | PP 는 되고 TP 는 안 된다. 실측으로 확인한다 |
| 13장 — P/D 분리 | 무거운 연산은 DGX, 앞뒤 조율은 Pi 클러스터 — 같은 발상의 하드웨어판 |
| 14장 — 모델이 들어가는가 vs 서비스할 수 있는가 | 405 B 는 올라가지만 1.3 tok/s. 올라가는 것과 되는 것은 다르다 |
| 15장 — 측정하지 않는 것은 운영할 수 없다 | 기준선 표가 19장 전체의 입력이다 |
| 16장 — 판교 화재와 3-2-1 | 콜드 스토리지 한 벌은 랙 밖에 둔다 |
| 17장 — 근거를 논증하는 설계 | 18장 자재 명세의 「고른 이유」 칸이 그 훈련이다 |
이 랙은 실제 AI 데이터센터의 1/260 이다. 그런데 이 랙에서 배우는 것 — 전력을 더하는 법, 열이 어디로 가는지, 존을 왜 나누는지, 대역폭이 병렬화를 어떻게 제한하는지, 사고가 났을 때 무엇을 먼저 보는지 — 은 배수와 무관하다.
규모가 바뀌면 답이 바뀌지만 질문은 바뀌지 않는다. 이 과목이 제품 이름을 외우는 대신 계층과 계산을 가르친 이유가 그것이다.
참고 자료
- mrgrit/kt66 — 시나리오 34종, 고장 주입 48종, envsim·noc·injector
- mrgrit/kt66 · scenarios — 시나리오별 주입 대상·증거 위치·구현 상태
- mrgrit/dawnofagi — L1~L4 제어 평면, 게이트, AOC, HITL 승인 큐
- mrgrit/el34 — kt66 의 베이스가 된 4-tier 보안 실습 랩
- Wazuh 문서 — SIEM 수집·탐지 규칙
- Google SRE Book · Postmortem Culture — 비난 없는 사후 검토
- 이 과목 15장(운영·관측) · 16장(국내 사례의 장애 기록) — 이 장의 절차가 그 사례들에서 나왔다