추론 서빙 아키텍처 — P/D 분리와 오케스트레이션
1장에서 시작한 이야기가 여기서 소프트웨어로 결실을 맺는다. 프리필과 디코드의 성격이 반대라면, 같은 기계에 두지 않는 것이 답이다. 그 단순한 발상이 서빙 스택 전체를 다시 그리게 만들었다.
이 장을 마치면
- vLLM·SGLang·TensorRT-LLM의 선택 기준을 워크로드별로 제시할 수 있다.
- P/D 분리 서빙의 구조와 이득의 원천을 설명할 수 있다.
- TTFT·TPOT·동시성을 측정하고 SLO 관점에서 해석할 수 있다.
- KV 캐시 재사용, 투기적 디코딩 등의 기법이 어느 병목을 노리는지 말할 수 있다.
서빙 엔진 — 무엇을 고를 것인가
추론 서빙 엔진의 핵심 과제는 하나다. 길이도 도착 시각도 제각각인 요청들을 GPU에 잘 채워 넣는 것.
| 핵심 기법 | 강점 | 고를 만한 상황 | |
|---|---|---|---|
| vLLM | PagedAttention | KV 캐시를 페이지 단위로 관리해 메모리 낭비를 없앰 | 범용. 처음 시작할 때의 기본값 |
| SGLang | RadixAttention | 프리픽스를 트리로 공유해 재사용률을 극대화 | 시스템 프롬프트·문서가 반복되는 워크로드, 에이전트 |
| TensorRT-LLM | 커널 수준 최적화 · 컴파일 | NVIDIA 하드웨어에서 최고 성능 | 구성이 고정된 대규모 프로덕션 |
전통적인 방식은 요청마다 최대 길이만큼 KV 캐시 공간을 미리 잡았다. 실제 길이는 훨씬 짧으니 대부분이 낭비였고, 그만큼 동시 처리 요청 수가 줄었다.
PagedAttention은 운영체제의 가상 메모리처럼 KV 캐시를 작은 페이지로 쪼개 관리한다. 필요한 만큼만 잡으니 같은 HBM으로 훨씬 많은 요청을 담을 수 있다. 메모리 관리가 곧 처리량인 것이 추론 서빙의 특징이다.
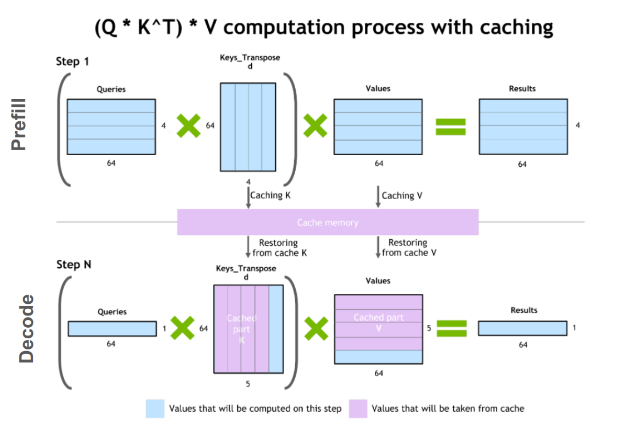
KV 캐싱 — 프리필과 디코드에서 계산이 어떻게 달라지는가
위쪽 Prefill에서는 Query가 4행짜리 행렬이고, 그 결과 Key·Value를 캐시에 저장한다(아래 화살표). 아래쪽 Decode(Step N)에서는 Query가 1행뿐이고, Key·Value의 대부분(보라색)은 캐시에서 꺼내 오며 새로 계산하는 것은 파란 한 칸뿐이다. 1장의 「행렬×행렬 vs 벡터×행렬」이 이 그림에서 그대로 보인다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)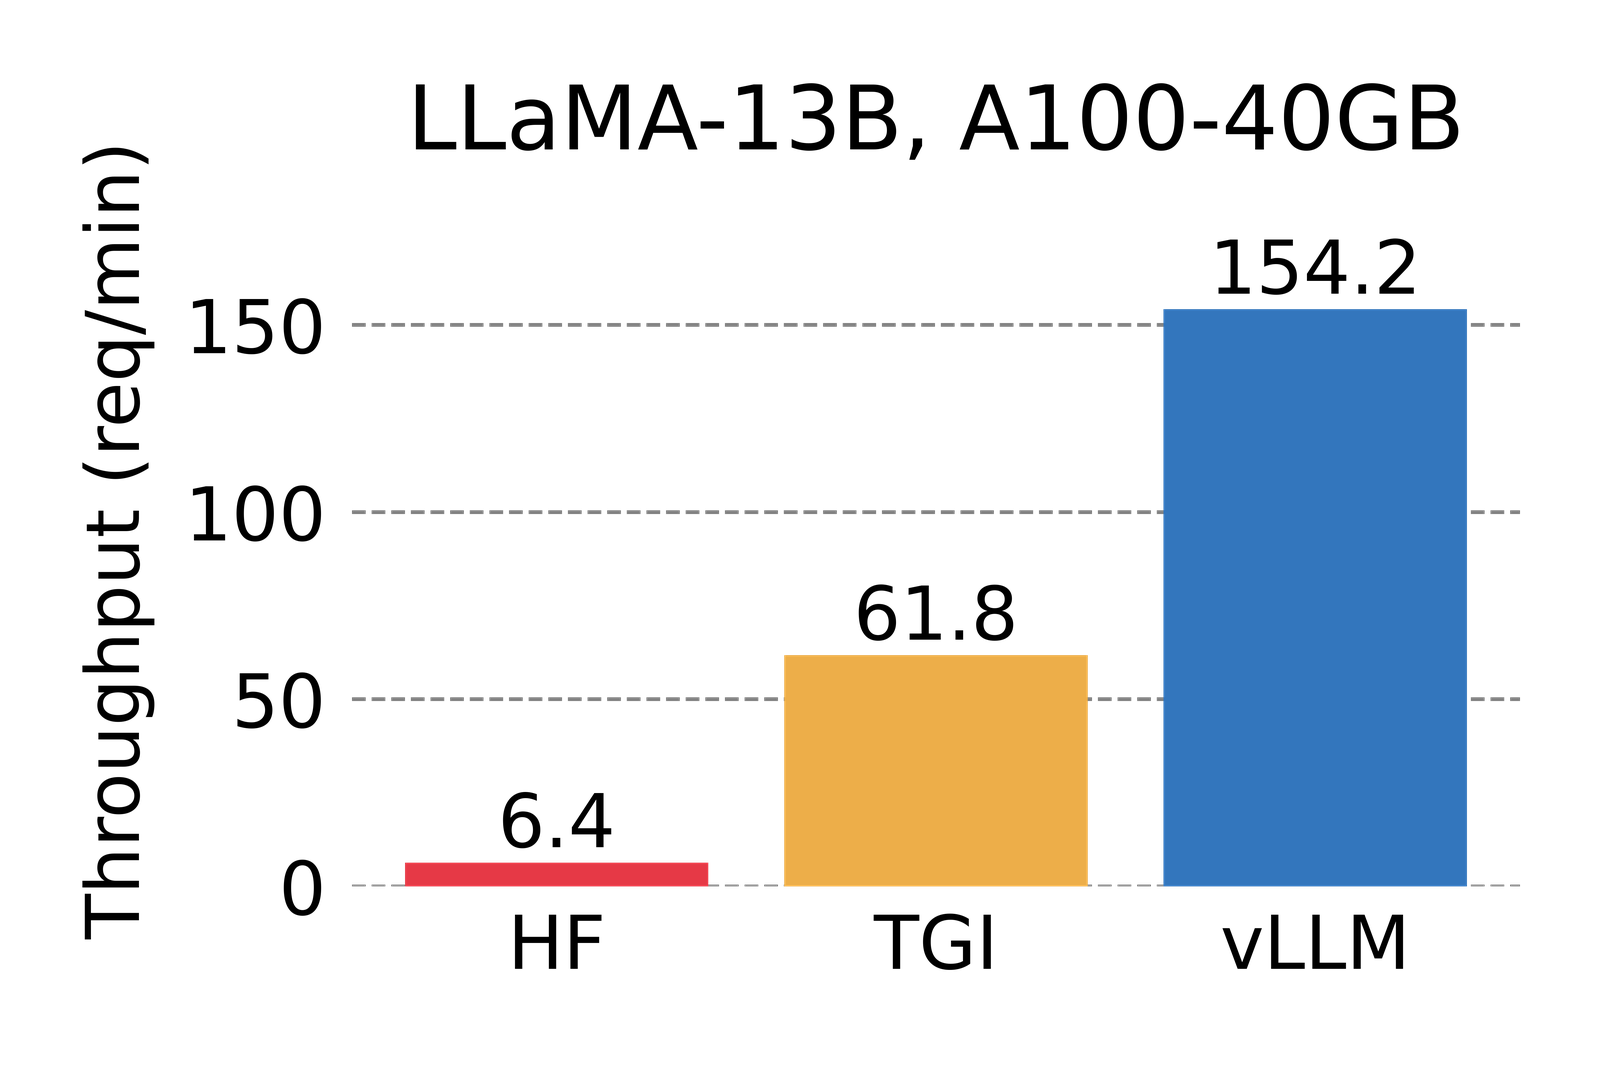
서빙 엔진별 처리량 — LLaMA-13B · A100 40GB 기준
HuggingFace 기본 파이프라인 6.4, TGI 61.8, vLLM 154.2 req/min이다. 같은 하드웨어에서 소프트웨어만 바꿔 24배 차이가 난다는 뜻인데, 그 대부분이 PagedAttention으로 메모리 낭비를 없애 동시 요청을 늘린 결과다. 다만 모델·요청 분포·측정 시점이 명시된 조건에서의 값이므로 다른 조건에 그대로 대입하면 안 된다.
출처: blog.vllm.ai© blog.vllm.ai (교육 목적 인용)P/D 분리 — 성격이 다른 일을 다른 기계에
프리필과 디코드를 같은 GPU에 두었을 때와 분리했을 때.
직접 제작 도해 · 자유 사용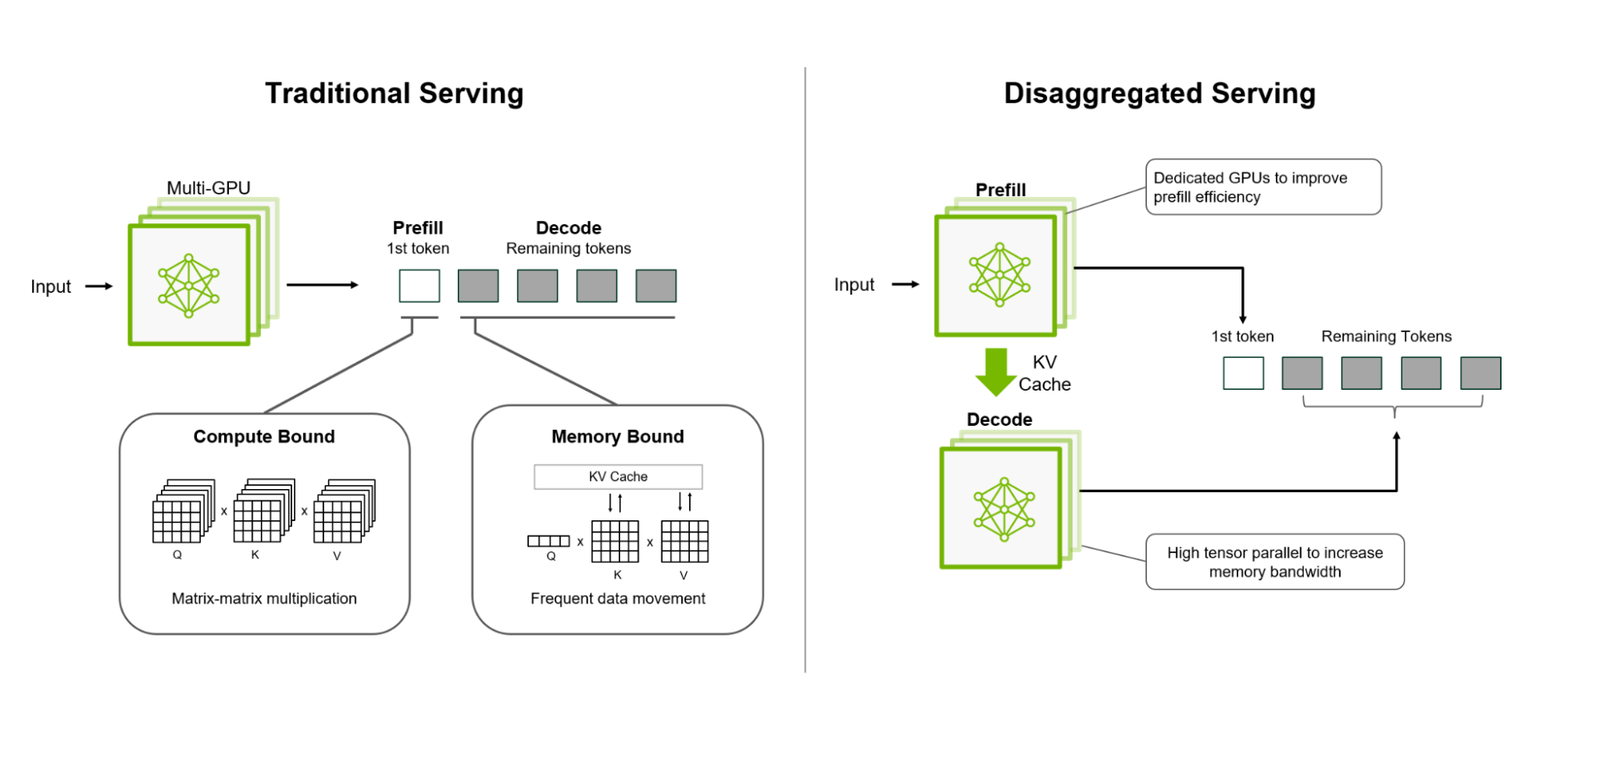
통합 서빙과 분리 서빙의 구조 비교.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)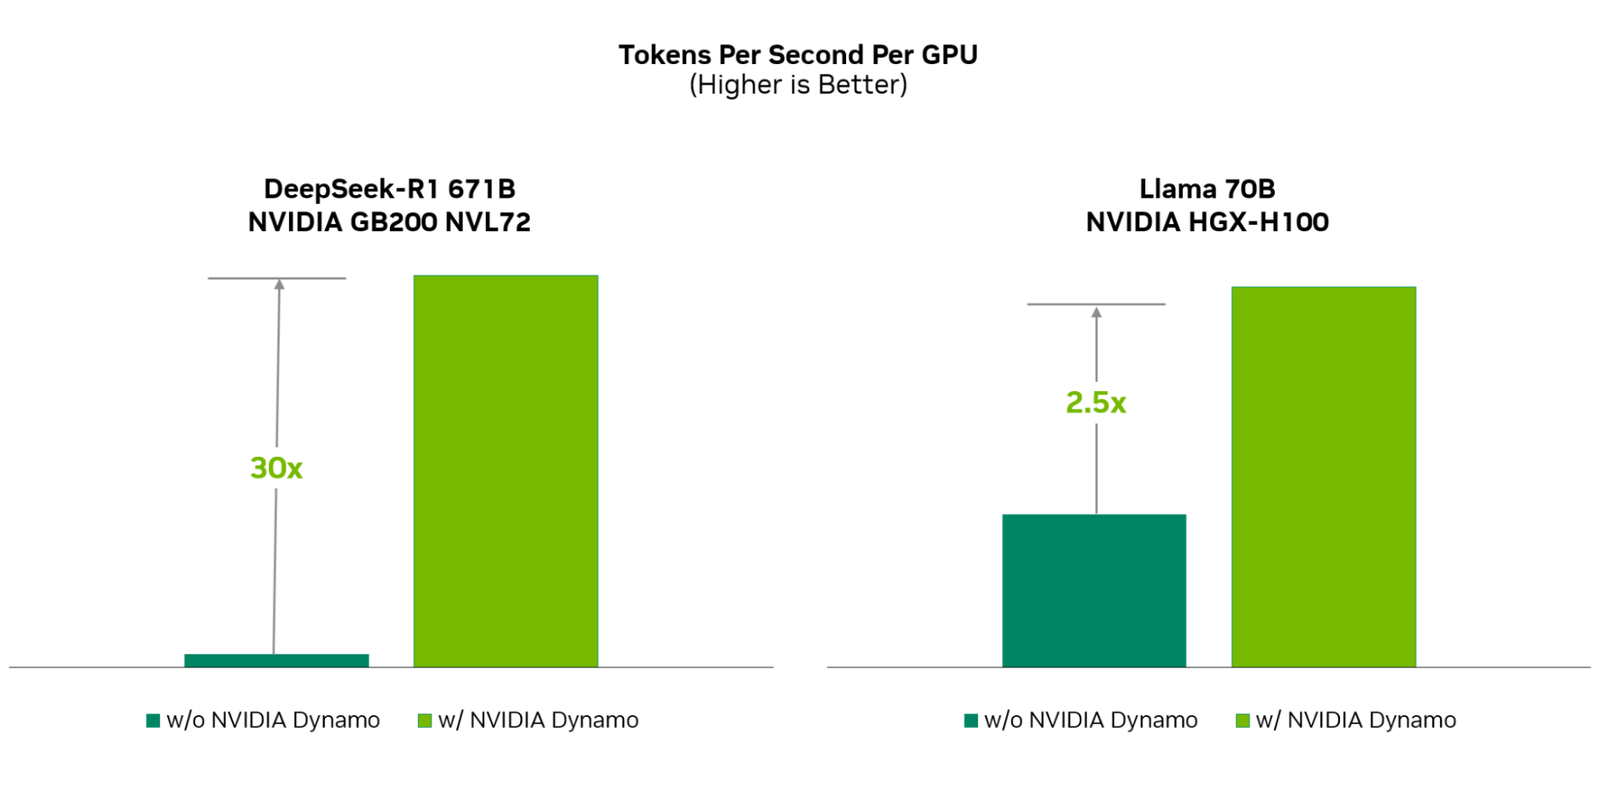
Dynamo 적용 전후의 GPU당 초당 토큰 — 두 가지 사례
왼쪽은 DeepSeek-R1 671B를 GB200 NVL72에서 돌린 경우로 30배, 오른쪽은 Llama 70B를 HGX H100에서 돌린 경우로 2.5배다. 같은 소프트웨어인데 배수가 12배 차이 난다는 점이 중요하다 — MoE 모델이고 scale-up 도메인이 클수록 분리의 이득이 커지기 때문이다. 「30배」만 떼어 인용하면 안 되는 이유가 이 그림 안에 있다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)프리필은 큰 배치로 몰아서 돌려야 GPU를 채울 수 있고, 디코드는 지연을 지켜야 하므로 배치를 무한정 키울 수 없다. 한 GPU에서는 이 둘을 동시에 만족시킬 수 없다.
분리하면 각 풀을 자기 최적점에 놓을 수 있다. 병렬화 구성도, 배치 크기도, 심지어 하드웨어까지 다르게 가져갈 수 있다 — 4장의 「Groq 3 LPX 디코드 랙」과 7장의 SRAM 기반 가속기가 여기에 꽂힌다.
멀티모달이 더하는 단계
이미지·오디오가 섞이면 프리필 앞에 인코드(encode) 단계가 하나 더 붙는다. 이 단계는 또 성격이 다르므로(비전 인코더는 연산 집약이지만 프리필과 자원 요구가 다르다) 같은 논리로 다시 분리하는 설계가 나온다. 워크로드를 쪼갤수록 랙 종류가 늘어난다는 4장의 관찰이 여기서도 반복된다.
오케스트레이션 — 요청을 어디로 보낼 것인가
풀을 나누면 새로운 문제가 생긴다. 어느 요청을 어느 GPU로 보낼 것인가? 무작위로 보내면 분리의 이득이 사라진다.
| 구성 요소 | 하는 일 |
|---|---|
| Smart Router | KV 캐시가 이미 있는 곳으로 요청을 보낸다 — 프리픽스가 캐시된 GPU에 같은 대화를 몰아주면 프리필을 통째로 건너뛴다 |
| Planner | 부하를 보고 프리필 풀과 디코드 풀의 비율을 조정한다 |
| NIXL | KV 캐시를 노드·랙 사이로 옮기는 전송 계층 (10장) |
| AIConfigurator | SLO를 주면 병렬화·배치 구성을 탐색해 준다 |
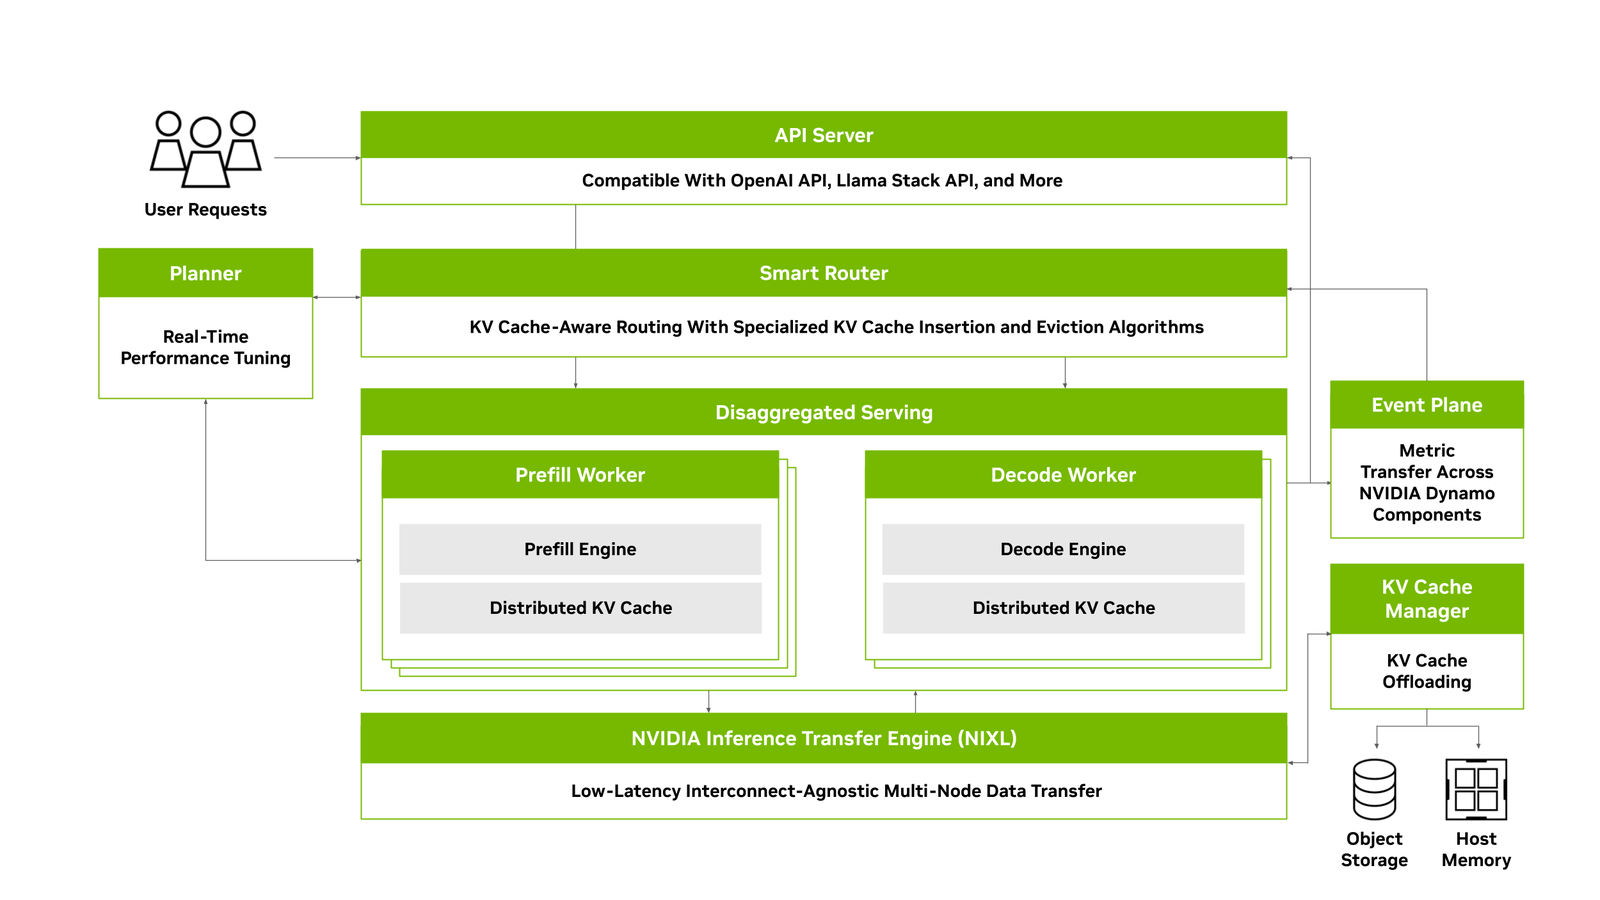
NVIDIA Dynamo의 구조. 라우터·플래너·전송 계층이 분리된 풀들을 묶는다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)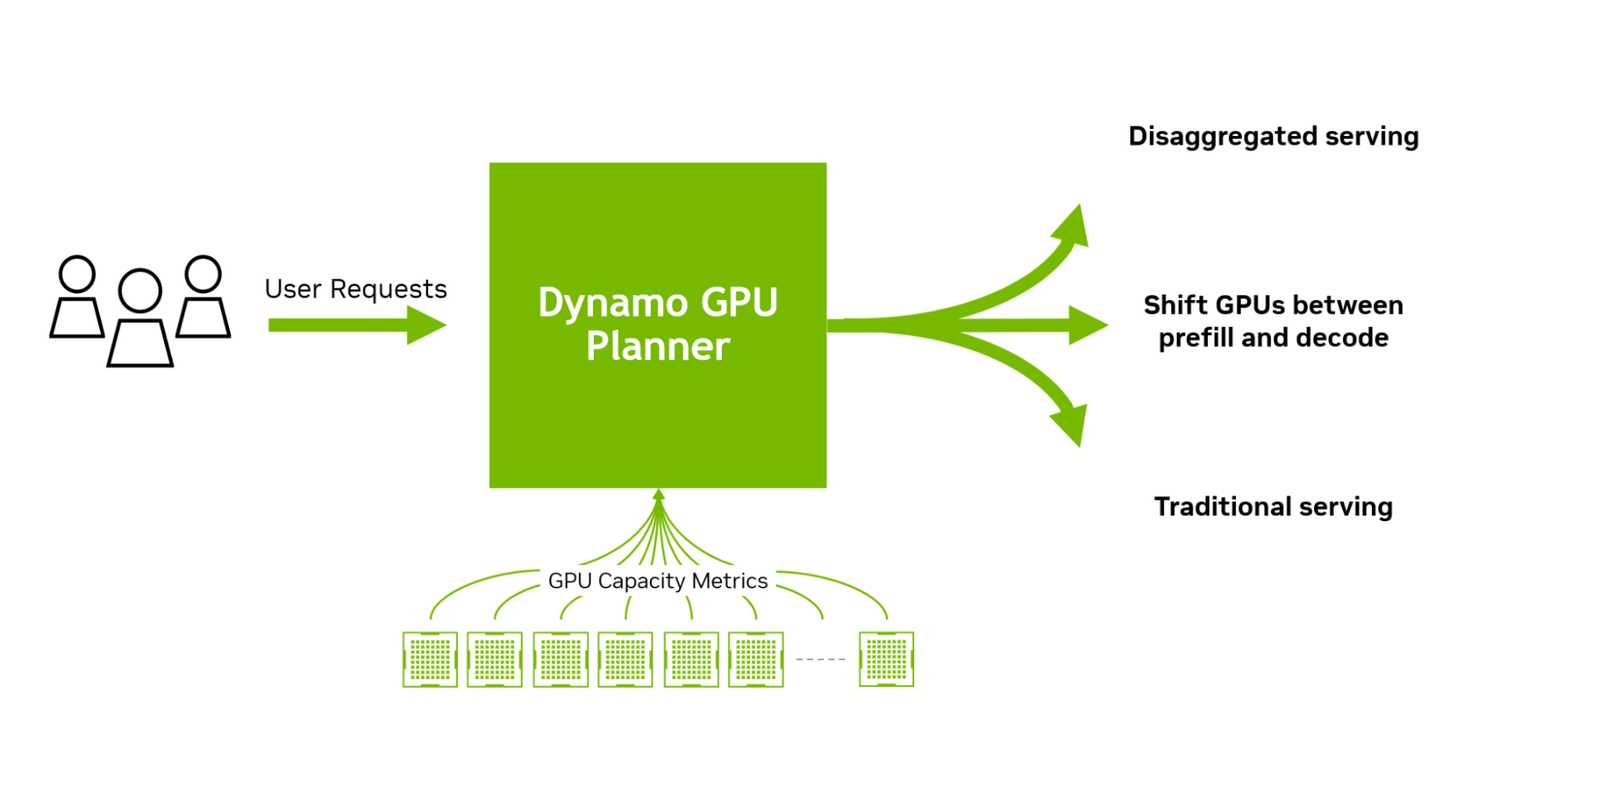
플래너가 부하에 따라 풀 크기를 조정하는 개념. 낮에는 디코드가, 배치 작업 시간대에는 프리필이 더 필요할 수 있다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)- llm-d — CNCF로 이관된 Kubernetes 네이티브 분산 추론 스택.
- Grove · KAI Scheduler — 추론 워크로드를 위한 스케줄링 계층. 12장의 토폴로지 인식이 추론에서도 필요하다 — P/D 분리에서는 프리필 풀과 디코드 풀이 KV 전송에 유리한 거리에 있어야 한다.
처리량을 끌어올리는 기법들
각 기법이 어느 병목을 노리는지 대응시켜 보면 정리가 된다.
| 기법 | 노리는 병목 | 원리 | 대가 |
|---|---|---|---|
| 배치 키우기 | 디코드의 대역폭 한계 | 가중치를 한 번 읽어 여러 요청에 재사용 (1장) | 지연 증가 · KV 캐시 증가 |
| 양자화 (NVFP4) | 디코드의 대역폭 한계 | 읽어야 할 바이트를 줄인다 (2장) | 정확도 손실 가능 |
| KV 캐시 재사용 | 프리필 연산 | 이미 계산한 프리픽스를 다시 안 쓴다 (10장) | 저장 공간 · 관리 복잡도 |
| 투기적 디코딩 | 디코드의 순차성 | 작은 모델이 여러 토큰을 미리 제안하고 큰 모델이 한 번에 검증 | 제안이 틀리면 낭비 |
| P/D 분리 | 두 단계의 상호 간섭 | 각 풀을 자기 최적점에 | KV 전송 · 라우팅 복잡도 |
| 병렬화 조합 | 모델이 한 GPU에 안 들어감 | TP·PP·EP를 조합 (12장) | 통신 비용 |
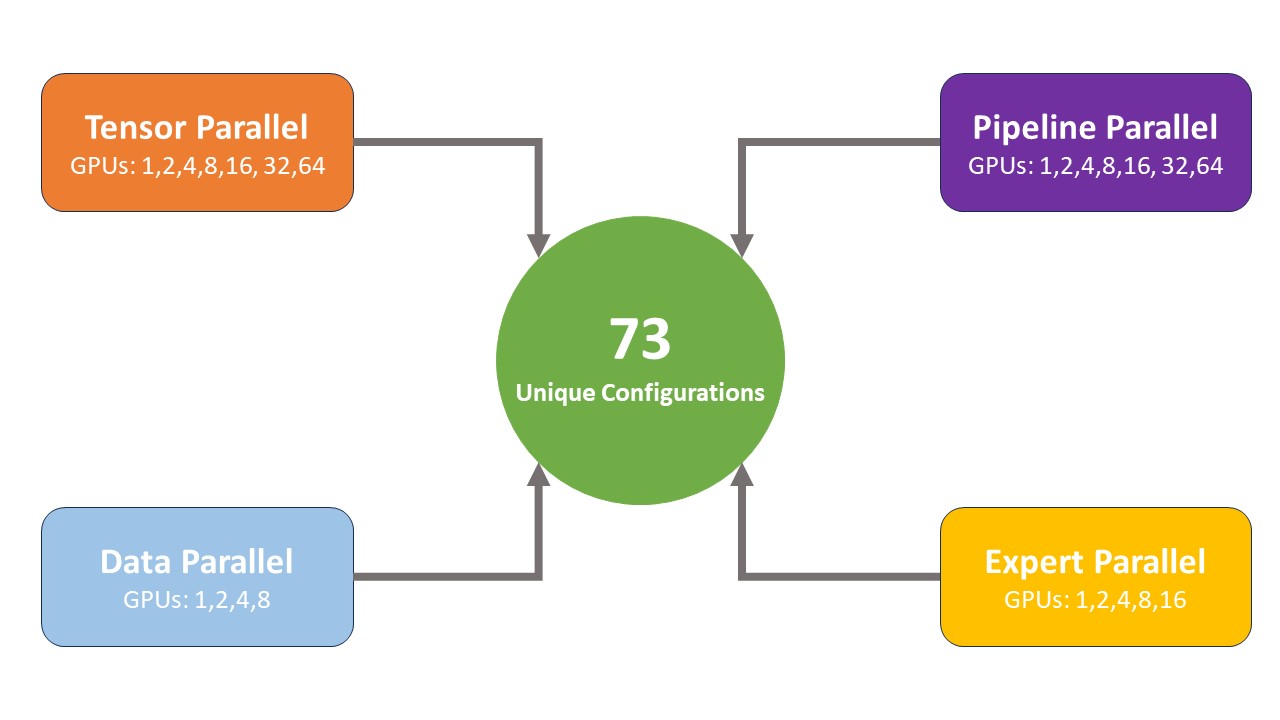
병렬화 조합의 수 — 네 가지를 곱하면 73가지
「최적 구성」을 손으로 찾을 수 없는 이유를 보여준다. 아래 「병렬화 조합」 절에서 이 조합들을 실제로 측정한 결과를 본다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)부하에 따라 프리필·디코드 풀 비율을 조정하는 플래너
사용자 요청이 들어오면 플래너가 GPU를 프리필 쪽과 디코드 쪽 사이에서 옮긴다. 낮에는 대화형 요청이, 밤에는 배치 작업이 많다면 같은 하드웨어로 두 프로파일을 오갈 수 있다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)「처리량을 최대로」와 「지연을 최소로」는 동시에 만족할 수 없다. TTFT 몇 ms 이하, TPOT 몇 ms 이하를 지키면서 처리량을 최대로 — 이렇게 조건을 걸어야 최적화 문제가 성립한다.
SLO 없이 벤치마크 숫자를 비교하는 것은 의미가 없다. 15장에서 벤더 주장을 읽을 때 가장 먼저 확인할 것이 이 조건이다.
병렬화 조합 — 추론에서는 학습과 다른 답이 나온다
12장에서 병렬화를 배웠지만, 그것은 학습 기준이었다. 추론에서는 목적이 다르다. 학습은 「전체 처리량 최대」가 목표지만, 추론은 「SLO를 지키면서 처리량 최대」가 목표다. 제약이 하나 더 붙으면 최적해가 달라진다.
LLM → 최적화 → 배포 — 세 단계로 표현한 개념 일러스트
벤더 자료에 흔히 쓰이는 단순화된 3단계 도식이다. 실제로는 이 세 단계가 순서대로 한 번씩 일어나지 않는다. 모델 최적화(양자화·증류), 엔진 선택, 병렬화 구성, 배치 정책, 라우팅이 서로 영향을 주면서 동시에 작동하므로, 하나만 바꿔서는 답이 안 나오고 조합을 탐색해야 한다. 그래서 AIConfigurator 같은 자동 탐색 도구가 나왔다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)각 병렬화를 늘리면 무슨 일이 일어나는가
추론에서 병렬화 차수를 하나씩 올려 보면 효과가 명확히 갈린다. 아래 세 그림을 같은 축으로 놓고 비교하는 것이 이 절의 핵심이다.
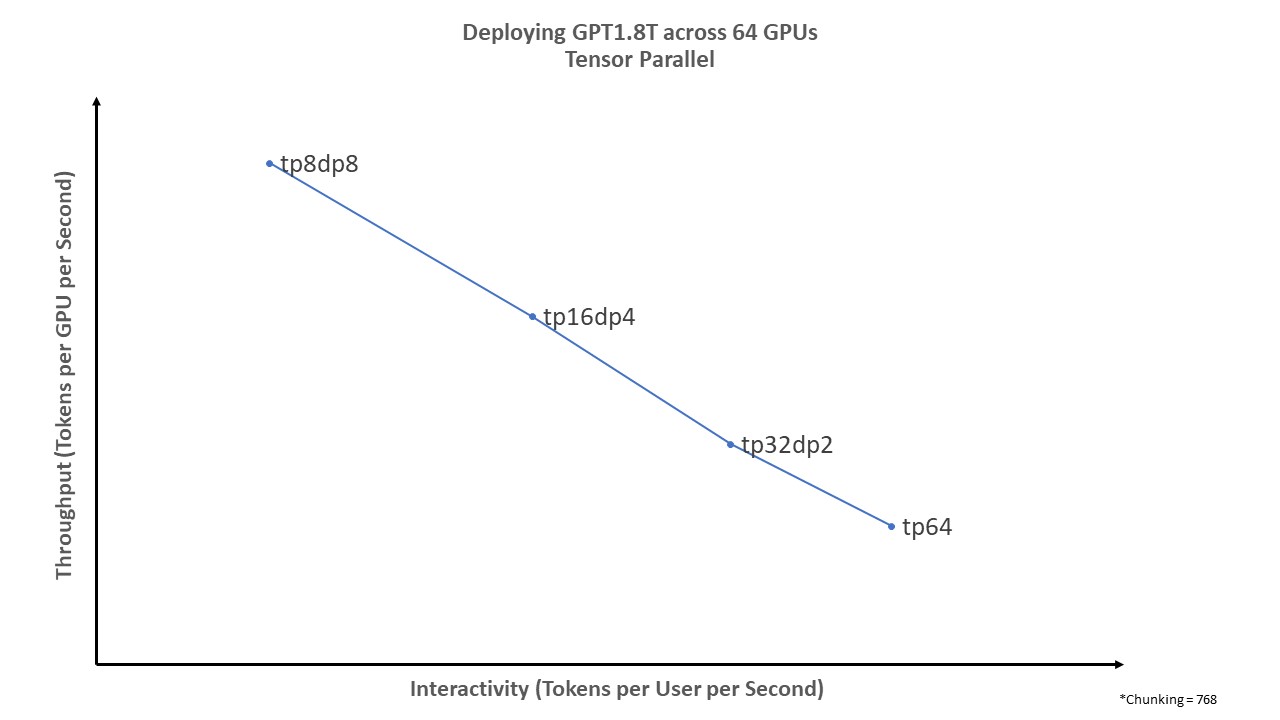
텐서 병렬(TP)을 늘리면
한 요청의 계산을 여러 GPU가 나눠 하므로 개별 응답이 빨라진다(TPOT 개선). 대신 레이어마다 통신이 붙어 GPU를 늘린 만큼 처리량이 늘지는 않는다. 지연을 사고 효율을 내주는 거래이며, 8장에서 봤듯 반드시 scale-up 도메인 안이어야 한다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)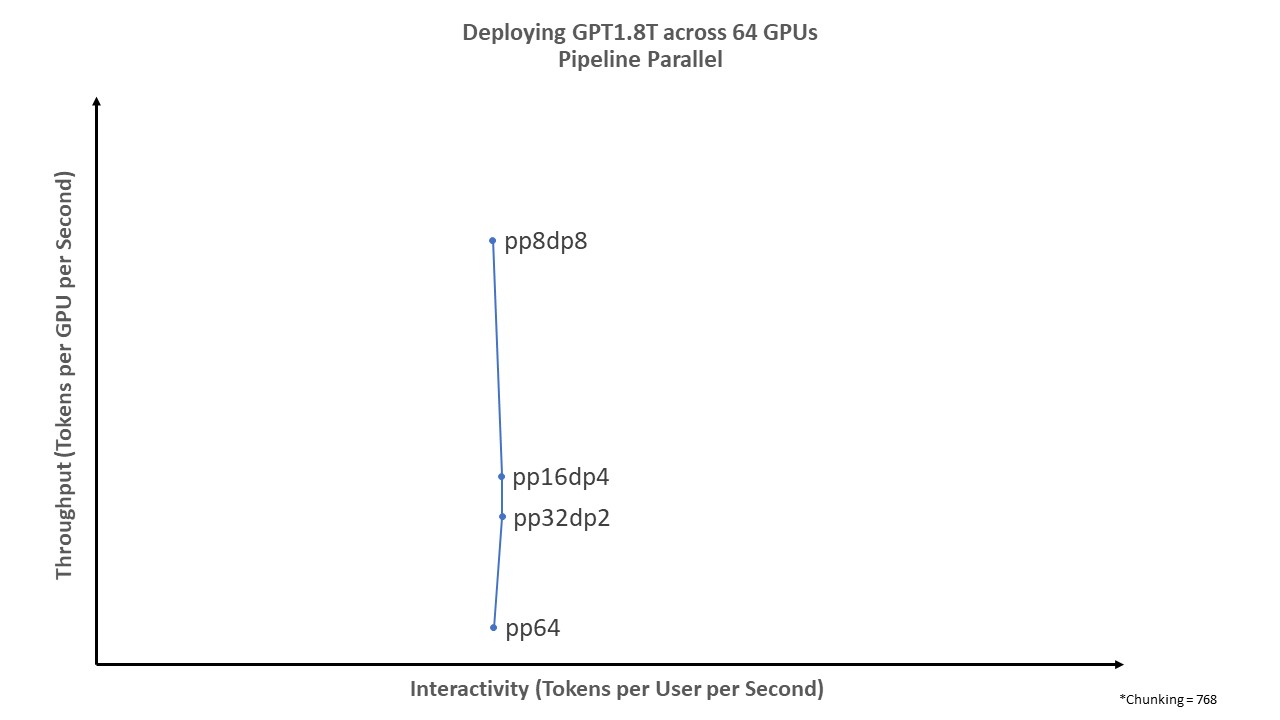
파이프라인 병렬(PP)을 늘리면
레이어를 나눠 맡으므로 큰 모델을 올릴 수 있게 되지만 개별 응답은 빨라지지 않는다. 오히려 단계를 거치는 만큼 지연이 늘어난다. 「메모리에 안 들어가서」 쓰는 병렬화이지 성능을 위한 것이 아니다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)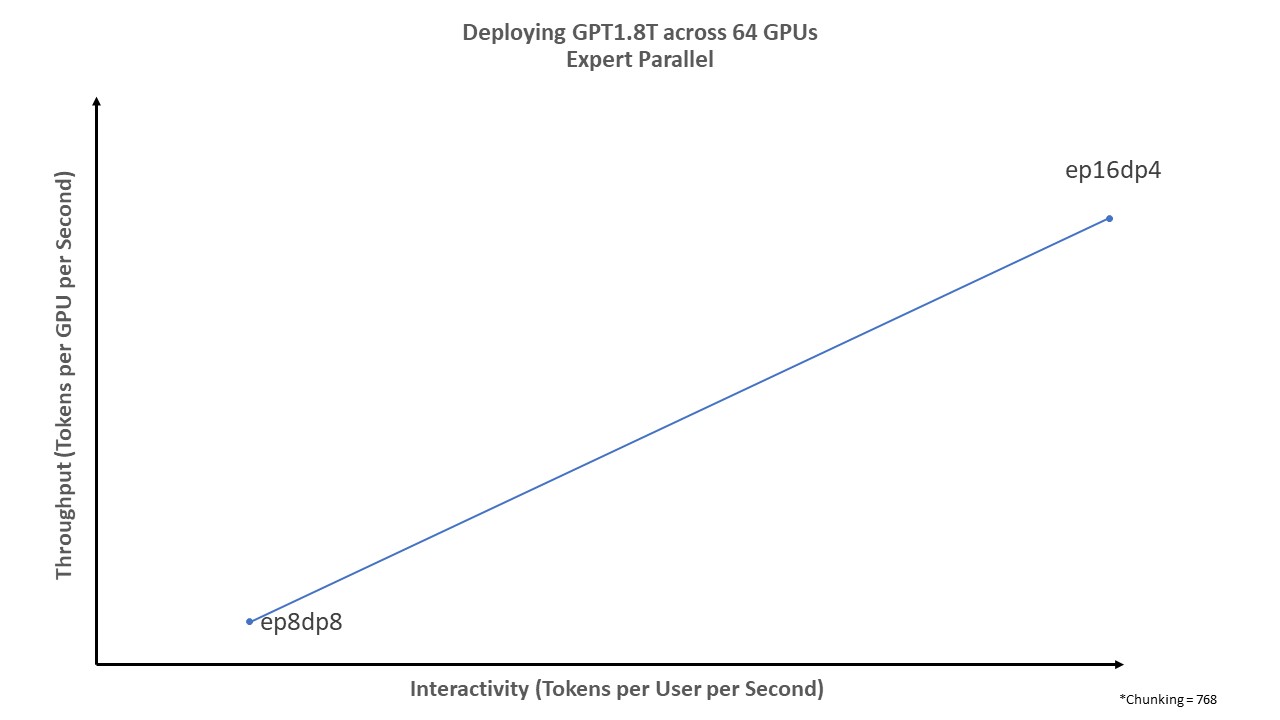
전문가 병렬(EP)을 늘리면
MoE 모델에서 전문가를 여러 GPU에 흩뿌린다. 메모리가 나뉘고 각 GPU의 계산량도 줄지만, 토큰마다 어느 전문가로 갈지 몰라 불규칙한 all-to-all 통신이 생긴다. 통신 패턴이 예측 불가능하다는 점이 TP·PP와 다른 어려움이다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)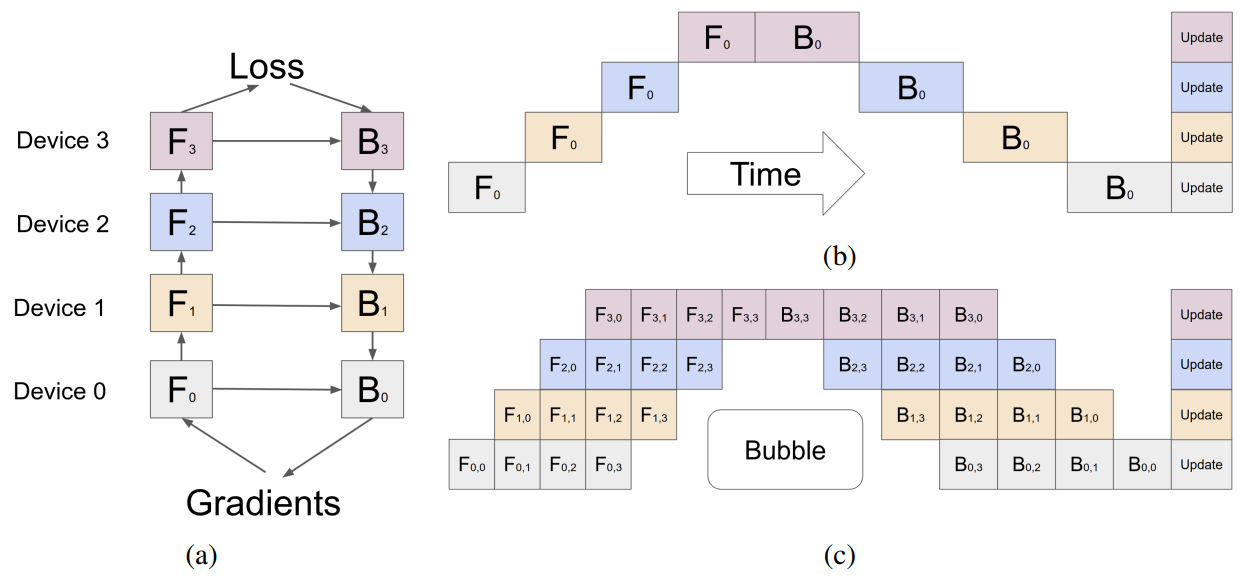
4단 파이프라인 병렬의 구조
레이어를 네 덩어리로 나눠 GPU 네 장에 순서대로 얹는다. 요청은 1번 → 2번 → 3번 → 4번 GPU를 거쳐 나온다. 한 요청만 있으면 항상 세 장이 놀고 있다 — 그래서 여러 요청을 겹쳐 흘려야 하고, 그것이 12장에서 본 마이크로배치다. 추론에서는 요청이 계속 들어오므로 이 부분은 학습보다 쉽다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)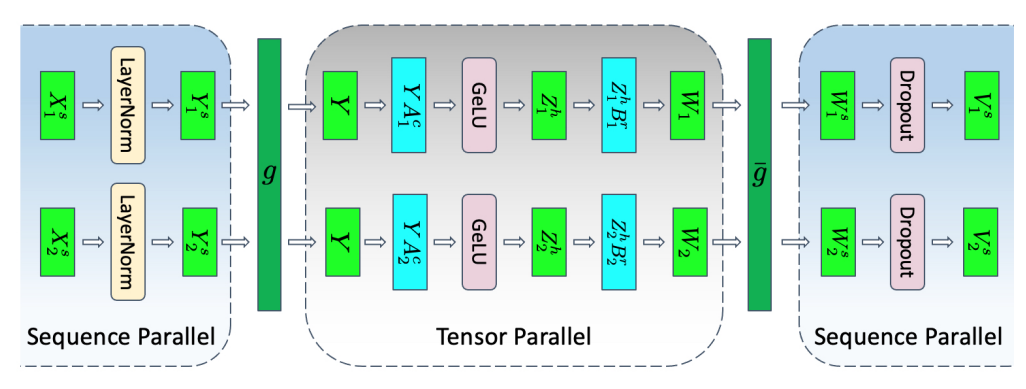
한 레이어 안에서 텐서 병렬과 시퀀스 병렬이 함께 적용된 모습
어텐션과 MLP 부분은 텐서 병렬로 나누고, 정규화 같은 부분은 시퀀스 방향으로 나눈다. 한 레이어 안에서도 부분마다 다른 병렬화를 쓴다는 것이 요점이다. 이 정도로 세밀하게 나누는 이유는 활성화 메모리를 줄이기 위해서이며, 14장의 메모리 예산에서 「활성화」 몫이 여기서 결정된다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)TP · PP · EP · 배치 크기 · KV 정밀도 · 청킹 정책을 각각 몇 가지씩만 놓아도 조합이 수십~수백 가지가 된다. 그리고 최적 조합은 모델과 SLO에 따라 매번 다르다.
TP · PP · DP · EP 각각의 선택지를 곱하면 73가지 조합이 나온다
네 가지 병렬화가 각각 몇 가지 차수를 가질 수 있는지(TP는 1~64, DP는 1~8 등) 적혀 있고, 그 조합이 73개라는 것이 가운데 원의 숫자다. 여기에 배치 크기·KV 정밀도·청킹 정책까지 곱하면 수백 가지가 된다. 「최적 구성」을 손으로 찾을 수 없는 이유가 이 그림 한 장에 있다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)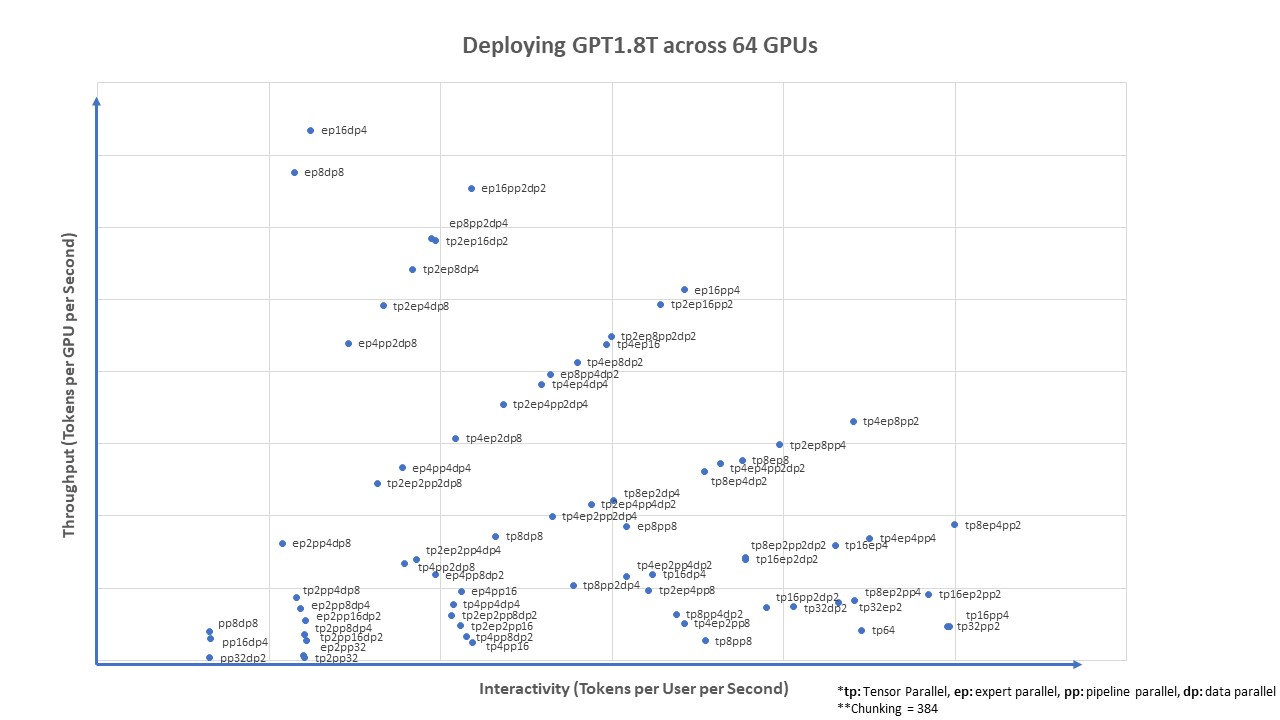
73개 조합을 전부 측정해 처리량–응답성 평면에 뿌린 결과 (GPT 1.8T · 64 GPU)
점 하나가 하나의 구성이고, 라벨은 tp8ep4dp2 처럼 병렬화 차수를 나타낸다. 가로축이 사용자 체감 속도(사용자당 초당 토큰), 세로축이 GPU당 처리량이다. 오른쪽 위로 갈수록 좋지만 그런 점은 없다 — 대체로 대각선을 이룬다. 바깥쪽 경계에 있는 점들만 의미가 있고, 안쪽 점은 다른 구성에 모든 면에서 지므로 고를 이유가 없다.
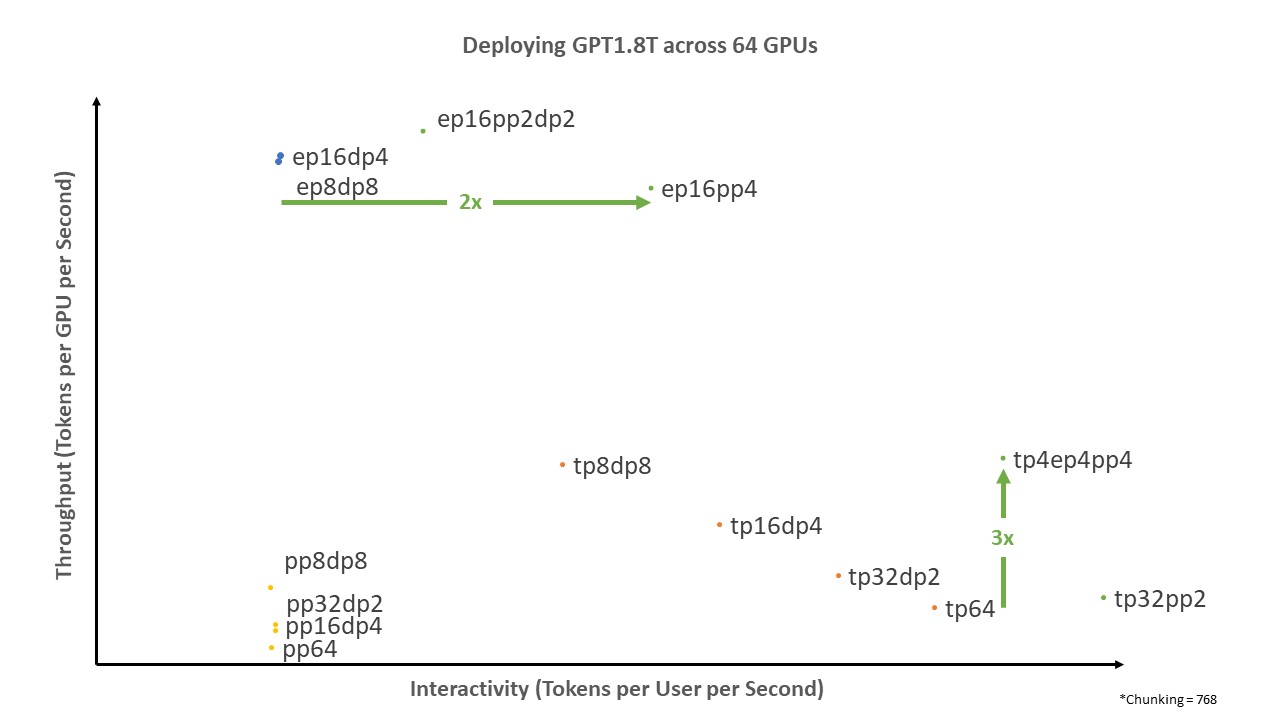
같은 평면에서 눈여겨볼 구성만 남기고 개선 배수를 표기한 것
ep8dp8 → ep16pp4 로 바꾸면 응답성이 2배, tp32dp2 → tp4ep4pp4 로 바꾸면 처리량이 3배가 된다는 식이다. 어느 점을 고를지는 순전히 SLO가 정한다. TTFT 1초·TPOT 50 ms를 지켜야 한다면 그 조건을 만족하는 구간에서 처리량이 가장 높은 점을, 배치 작업이라 지연을 신경 안 써도 된다면 왼쪽 위 끝을 고르면 된다. 「최적 구성」이라는 것은 SLO 없이는 존재하지 않는다 — 이 절의 결론이자 14장 용량 산정의 출발점이다.
이 탐색을 손으로 하면 며칠이 걸린다. Dynamo의 AIConfigurator 같은 도구가 SLO를 입력하면 구성 후보를 추려 주는 것도 그 때문이다. 다만 도구가 추천한 구성도 자기 요청 분포로 반드시 재검증해야 한다 — 도구는 대개 균일한 합성 부하를 가정한다.
실습 — 서빙하고, 재고, 나눠 보기
목표: DGX Spark에서 서빙 엔진을 띄워 TTFT·TPOT·동시성을 측정하고, 2대로 P/D 분리를 구성해 그 차이를 확인한다. 이 과목 실습의 종착점이다.
1단계 — 단일 장비 서빙과 SLO 곡선 그리기
vllm serve <model> --max-model-len 8192

# 동시 요청 수를 바꿔 가며 부하를 건다
python -m vllm.entrypoints.openai.api_server ...   # 또는 벤치마크 스크립트
#   동시성: 1, 2, 4, 8, 16, 32, 64
#   기록: TTFT(p50/p99), TPOT(p50/p99), 처리량(tok/s), GPU 사용률
가로축을 처리량, 세로축을 p99 TTFT로 그래프를 그려라. 위 도해에서 본 상충 곡선이 여러분의 장비에서도 나타나는지 확인한다.
2단계 — 엔진 비교
같은 조건에서 SGLang으로 바꿔 측정한다. 같은 프리픽스를 공유하는 요청을 많이 섞은 부하를 따로 만들어, RadixAttention의 효과가 드러나는지 본다.
| 부하 유형 | vLLM — 처리량 / p99 TTFT | SGLang — 처리량 / p99 TTFT |
|---|---|---|
| 프리픽스 공유 없음 | ||
| 프리픽스 80% 공유 |
3단계 — P/D 분리 데모 (2대)
1번 장비를 프리필 전용, 2번 장비를 디코드 전용으로 구성한다. 엔진과 버전에 따라 방법이 다르므로 사용한 옵션과 버전을 반드시 기록할 것.
- 긴 프롬프트(4K 이상) 요청과 짧은 프롬프트 요청을 섞어 부하를 건다.
- 통합 구성(2대에 각각 통합 서빙)과 분리 구성을 비교한다.
- 특히 긴 프롬프트가 도착했을 때 진행 중이던 요청의 TPOT이 튀는지를 본다. 이것이 P/D 분리가 해결하려는 바로 그 현상이다.
| 통합 서빙 (2대) | P/D 분리 (2대) | |
|---|---|---|
| 처리량 (tok/s) | ||
| p99 TTFT (ms) | ||
| p99 TPOT (ms) | ||
| 긴 프롬프트 도착 시 TPOT 변동폭 |
4단계 — 해석
- 여러분의 규모(2대)에서 P/D 분리는 이득인가, 손해인가? KV 전송 비용이 어느 정도로 나타났는가?
- 어느 규모부터 분리가 이길 것 같은가? 근거를 대라.
- 1장에서 계산한 이론 상한과 지금 측정한 처리량의 격차는 얼마인가? 그 격차를 어느 항목들이 설명하는가?
- 우리 학교가 교내 LLM 서비스를 연다면 어떤 구성을 고르겠는가? SLO를 먼저 정하고 답하라.
제출물
SLO 곡선 그래프 + 세 개의 비교표 + 4단계 해석 (A4 4장 이내). 환경(모델, 엔진 버전, 옵션, 하드웨어)을 재현 가능하게 기록할 것.
참고 자료
- Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention (SOSP 2023) — vLLM 원논문
- vLLM 블로그 — PagedAttention · SGLang 문서
- NVIDIA Technical Blog — 대규모 추론 배포 : 이 페이지 도해 출처
- NVIDIA Dynamo 문서 — Disaggregated Serving · llm-d (CNCF)