Scale-out / Scale-across 네트워크와 광 인터커넥트
랙을 수천 대 묶는 네트워크는 설계 계산으로 규모가 결정된다. 포트를 나누면 스위치 수가 나오고, 스위치 수를 곱하면 광모듈 수가 나오고, 광모듈 수에 30W를 곱하면 왜 CPO가 필연이었는지가 나온다.
이 장을 마치면
- 4계층 네트워크를 구분하고 각 계층의 역할과 기술을 말할 수 있다.
- 1,024 GPU 클러스터의 리프–스파인 구성과 광모듈 수를 계산할 수 있다.
- 오버서브스크립션과 rail-optimized 설계의 트레이드오프를 설명할 수 있다.
- CPO가 해결하는 문제를 전력·신뢰성 관점에서 정량적으로 설명할 수 있다.
네 개의 네트워크가 동시에 돈다
AI 팩토리에는 성격이 다른 네트워크가 최소 넷 있다. 하나로 뭉뚱그리면 설계가 안 된다.
| 계층 | 무엇을 잇는가 | 기술 | 이 과목 |
|---|---|---|---|
| Scale-up | 랙 안 가속기끼리 | NVLink · UALink | 8장 |
| Scale-out | 랙과 랙 | InfiniBand Quantum-X · Spectrum-X 이더넷 | 이 장 |
| Scale-across | 데이터센터와 데이터센터 | Spectrum-XGS 등 장거리 광 | 이 장 |
| 스토리지 | 연산 노드와 스토리지 | BlueField-4 STX 계열 | 10장 |
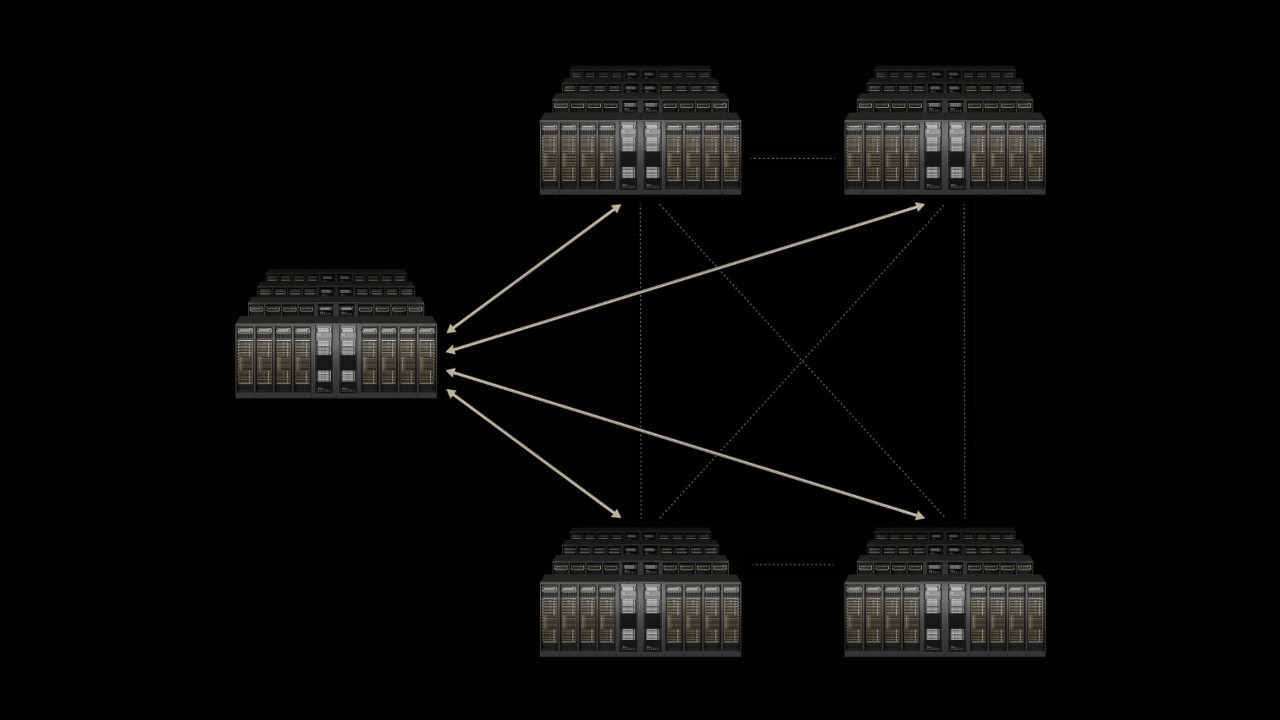
Scale-across — 여러 사이트를 한 학습 잡으로 묶는 계층. 5장에서 본 GW 단위 계약이 한 부지의 전력 한계를 넘어서면서 필요해졌다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)
이더넷 패브릭으로 묶인 랙 열 — 제품 렌더
렌더 이미지이며 구조를 보여주는 도해는 아니다. 다만 이 장에서 계산할 대상이 무엇인지는 보여준다 — 이만한 랙 열 전체를 하나의 네트워크로 묶는 것이 scale-out 설계다. 아래 절에서 1,024 GPU 기준으로 그 링크 수를 직접 세어 본다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)한 부지에서 끌어올 수 있는 전력에는 한계가 있다. 5장의 GW 단위 계약이 현실이 되면 한 건물에 다 넣을 수 없다. 그러면 여러 사이트를 묶어 하나의 학습 잡을 돌려야 한다.
문제는 지연이다. 사이트 간 거리가 수십~수백 km면 ms 단위 지연이 생긴다. 8장의 규칙을 적용하면 — TP는 절대 여기 태울 수 없고, DP나 PP처럼 지연을 감출 수 있는 병렬화만 가능하다. 12장와 이어진다.
설계 계산 — 포트를 나누면 규모가 나온다
scale-out 네트워크 설계는 의외로 산수다. 아래가 이 장 실습의 기본형이다.
1,024 GPU 클러스터의 리프–스파인 설계. 스위치 포트 수를 나누면 필요한 장비 수가 그대로 나온다.
직접 제작 도해 · 자유 사용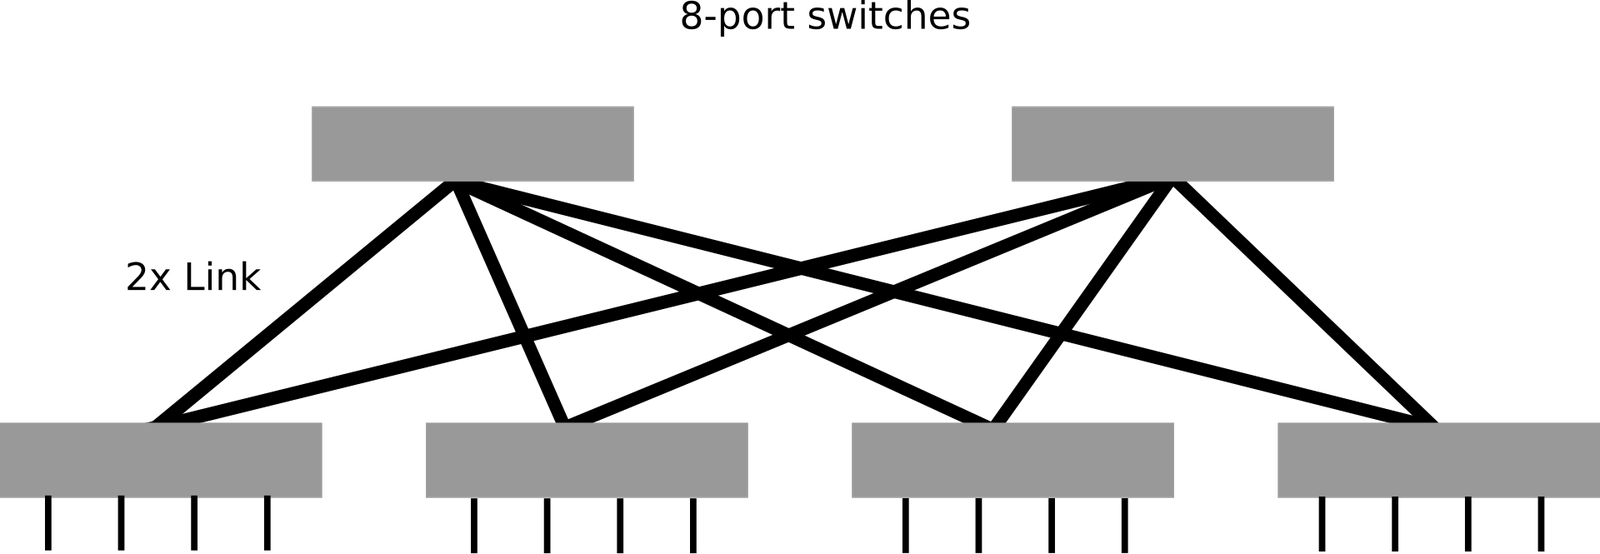
fat-tree의 원리. 위로 갈수록 링크를 굵게 해 어느 노드 쌍이든 같은 대역폭을 보장하려 한다.
출처: Konstantinos AgiannisCC BY-SA 4.0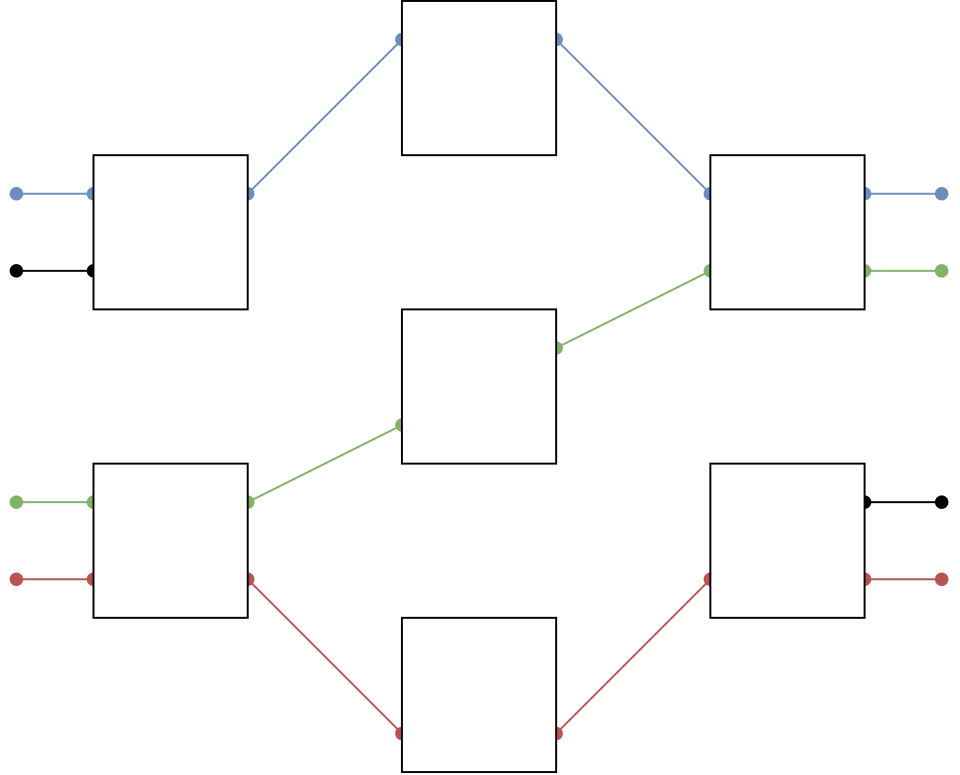
Clos 네트워크. 리프–스파인 구조의 이론적 뿌리다. 「어떤 입출력 조합이든 막히지 않게」가 설계 목표다.
출처: en.wikipedia.org© en.wikipedia.org (교육 목적 인용)실무에서 조정하는 두 가지 손잡이
| 무엇인가 | 얻는 것 | 잃는 것 | |
|---|---|---|---|
| 오버서브스크립션 | 리프의 업링크를 다운링크보다 적게 (예: 2:1) | 스위치·광모듈 수가 크게 준다 | 랙 간 통신이 몰리면 병목. 학습 잡에는 위험 |
| Rail-optimized | 각 노드의 n번째 NIC를 n번째 리프에만 연결 | 집합 통신이 리프 한 대 안에서 끝나는 경우가 늘어난다 | 배선·배치 규칙이 까다로워진다 |
추론 클러스터는 노드 간 통신이 적어 오버서브스크립션을 걸어도 되는 경우가 많다. 학습 클러스터는 all-reduce가 전체를 가로지르므로 1:1(non-blocking)이 기본이다. 워크로드를 모르면 네트워크를 설계할 수 없다는 말이 여기서도 성립한다.
이더넷의 부상
오랫동안 HPC 클러스터의 기본은 InfiniBand였다. 지금은 이더넷이 빠르게 자리를 넓히고 있다.
| InfiniBand | 이더넷 (Spectrum-X · UEC) | |
|---|---|---|
| 강점 | 지연 · 무손실 전송이 규격에 내장 | 물량 · 공급자 다양성 · 운영 인력 |
| 혼잡 제어 | 크레딧 기반 흐름 제어 | RoCE + 개선된 혼잡 제어 |
| 표준화 | 단일 벤더 색채가 강함 | Ultra Ethernet Consortium(UEC) |
| NIC | HCA | SuperNIC (ConnectX-9 등) |
| 속도 | NDR → 차세대 | 800G → 1.6T |
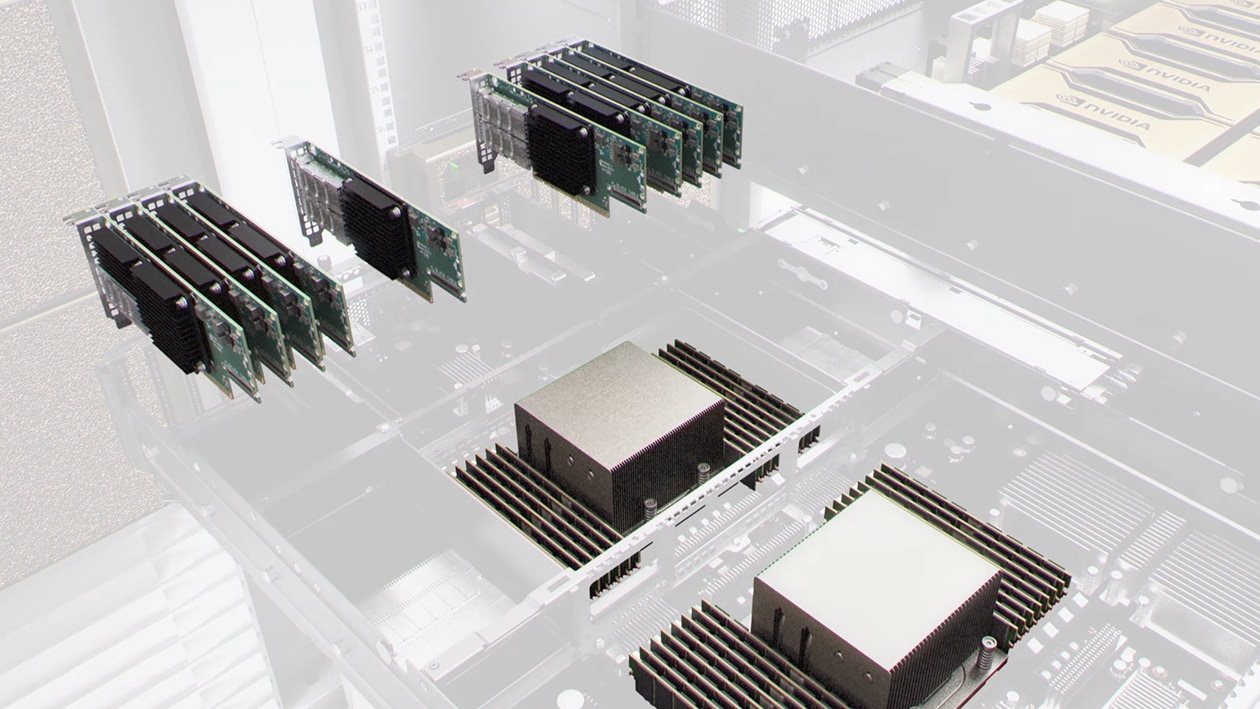
InfiniBand 어댑터 카드. 노드가 scale-out 패브릭에 붙는 지점이다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)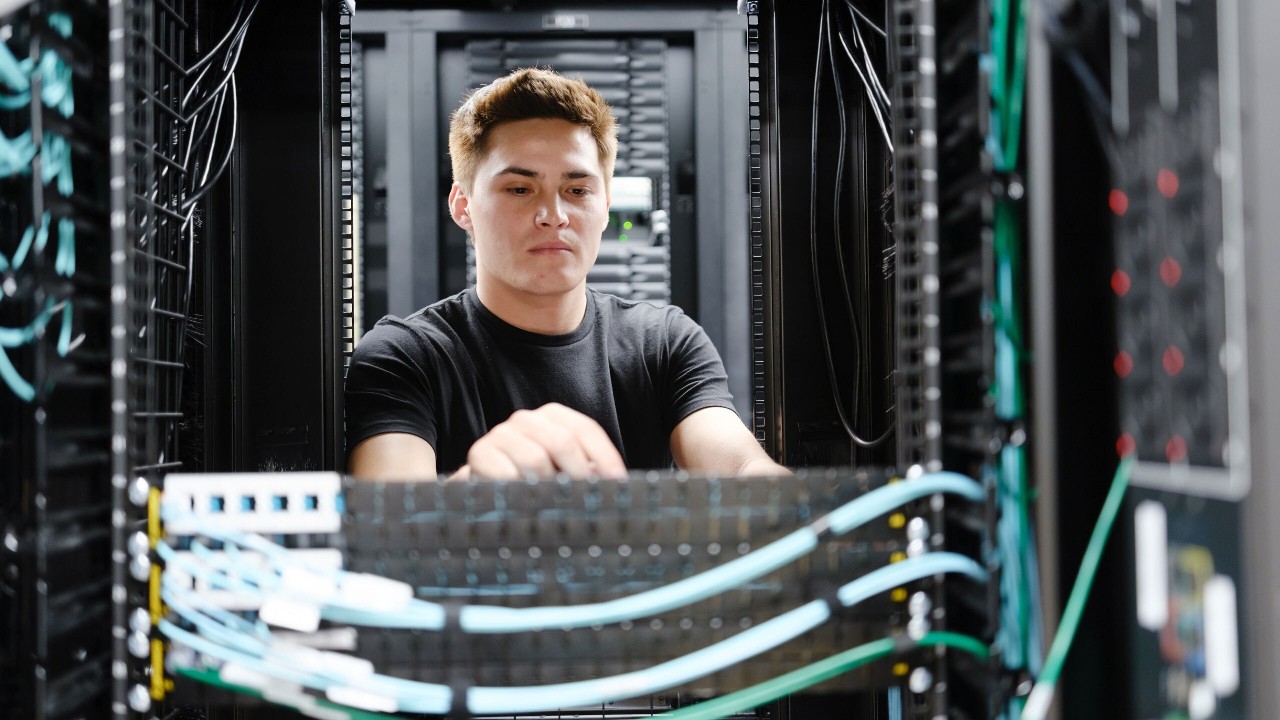
현실의 배선 작업. 앞 절의 계산에서 나온 「링크 2,048개」는 이렇게 사람이 하나씩 꽂아야 하는 물리적 작업이다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)이더넷이 밀고 들어오는 이유는 5장의 개방형 논리와 같다 — 계층마다 공급자가 여럿이면 가격이 내려간다. 기술적 격차(무손실 전송, 혼잡 제어)를 UEC가 표준으로 메우려는 것이 현재 국면이다.
혼잡 제어 — 이더넷이 어려웠던 진짜 이유
이더넷은 원래 패킷을 버려도 되는 네트워크로 설계됐다. 혼잡하면 버리고, 상위 계층(TCP)이 재전송한다. 웹 트래픽에는 훌륭한 설계다.
그런데 AI 학습의 집합 통신에서는 이 방식이 재앙이다. all-reduce는 참여자 전원이 끝나야 끝난다. 한 패킷이 버려져 재전송되면 그 시간만큼 수천 개 GPU가 전부 기다린다.
| InfiniBand | 이더넷 (RoCE) — 개선 전 | 이더넷 — 개선 후 | |
|---|---|---|---|
| 기본 철학 | 무손실(lossless)이 규격에 내장 | 손실 허용 · 재전송 | PFC·ECN으로 무손실에 근접 |
| 혼잡 신호 | 크레딧 기반 흐름 제어 | 패킷 폐기 후 감지 (늦다) | ECN 표시 · 빠른 되먹임 |
| 문제 | — | 폐기 → 재전송 → 전체 정지 | PFC 자체의 부작용(head-of-line 블로킹, 데드락) |
| 현재 | 성숙 | — | Ultra Ethernet이 표준으로 정리 중 |
고성능 컴퓨팅용 이더넷 확장은 오랫동안 벤더마다 제각각이었다. Spectrum-X 같은 제품이 잘 도는 것은 NIC와 스위치가 같은 회사 것이라 혼잡 제어를 끝에서 끝까지 맞출 수 있기 때문이다. 5장의 수직 통합 논리가 여기서도 반복된다.
Ultra Ethernet Consortium(UEC)이 하려는 일이 정확히 이 부분의 표준화다. 여러 벤더의 NIC와 스위치를 섞어도 혼잡 제어가 제대로 동작하게 만들면, 개방형 진영이 InfiniBand의 마지막 기술적 우위를 지우게 된다.
네트워크 문제가 학습에 나타나는 방식
네트워크 장애는 대개 「끊김」이 아니라 「느려짐」으로 나타난다. 그래서 찾기 어렵다.
| 증상 | 가능한 원인 | 확인 방법 |
|---|---|---|
| 특정 노드만 스텝이 느리다 | 링크 오류율 상승 → 재전송 | 포트별 오류 카운터 추적 |
| 전체가 균일하게 느리다 | 혼잡 제어 설정 문제 · 오버서브스크립션 | 링크 이용률과 큐 깊이 확인 |
| 가끔씩만 느리다 | 다른 잡과의 간섭 | 잡 배치와 시간대 상관 분석 |
| 스케일을 키우면 효율이 급락 | 토폴로지와 병렬화 배치 불일치 | 12장의 통신 프로파일링 |
「느려지는 고장」을 잡으려면 평소 값을 알고 있어야 한다. 정상일 때의 링크 이용률, 오류율, 스텝 시간 분포를 기록해 두지 않으면 「지금 이상한가」를 판단할 기준이 없다. 15장 관측의 실제 목적이 이것이다.
CPO — 광모듈이 전력을 먹기 시작하면
앞의 계산에서 1,024 GPU에 광 트랜시버 4,096개가 나왔다. 개당 30W라면 그것만으로 123 kW다. GPU 랙 하나에 맞먹는다. GPU가 10만 대로 가면 이 항목이 감당 못 할 크기가 된다.
기존에는 스위치 칩에서 전기 신호가 기판을 지나 앞면의 플러그형 트랜시버까지 가야 했다. 그 거리를 전기로 밀어내는 데 전력이 든다.
CPO는 광 엔진을 스위치 칩 옆에 같은 패키지 안에 붙인다. 전기 신호가 이동하는 거리가 줄어드니 전력이 줄고, 부품 수가 줄어드니 고장 지점도 준다.
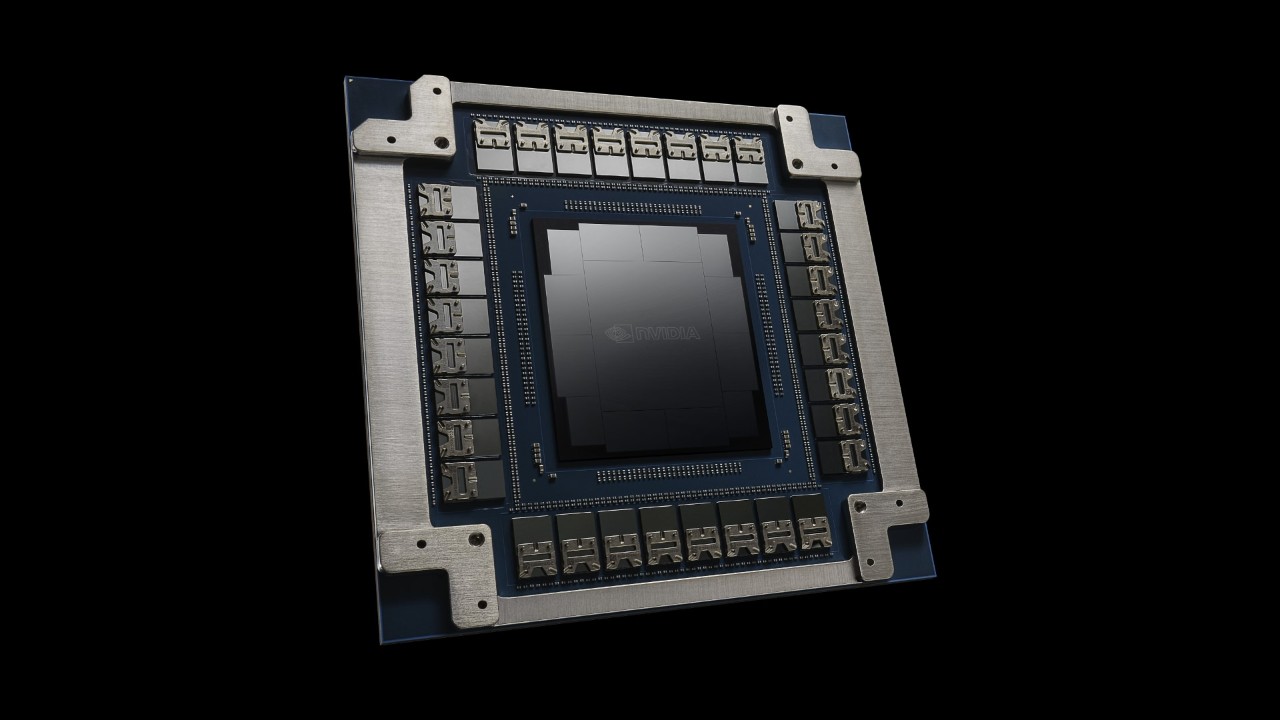
CPO 패키지. 스위치 칩 주변에 광 엔진이 함께 실려 있다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)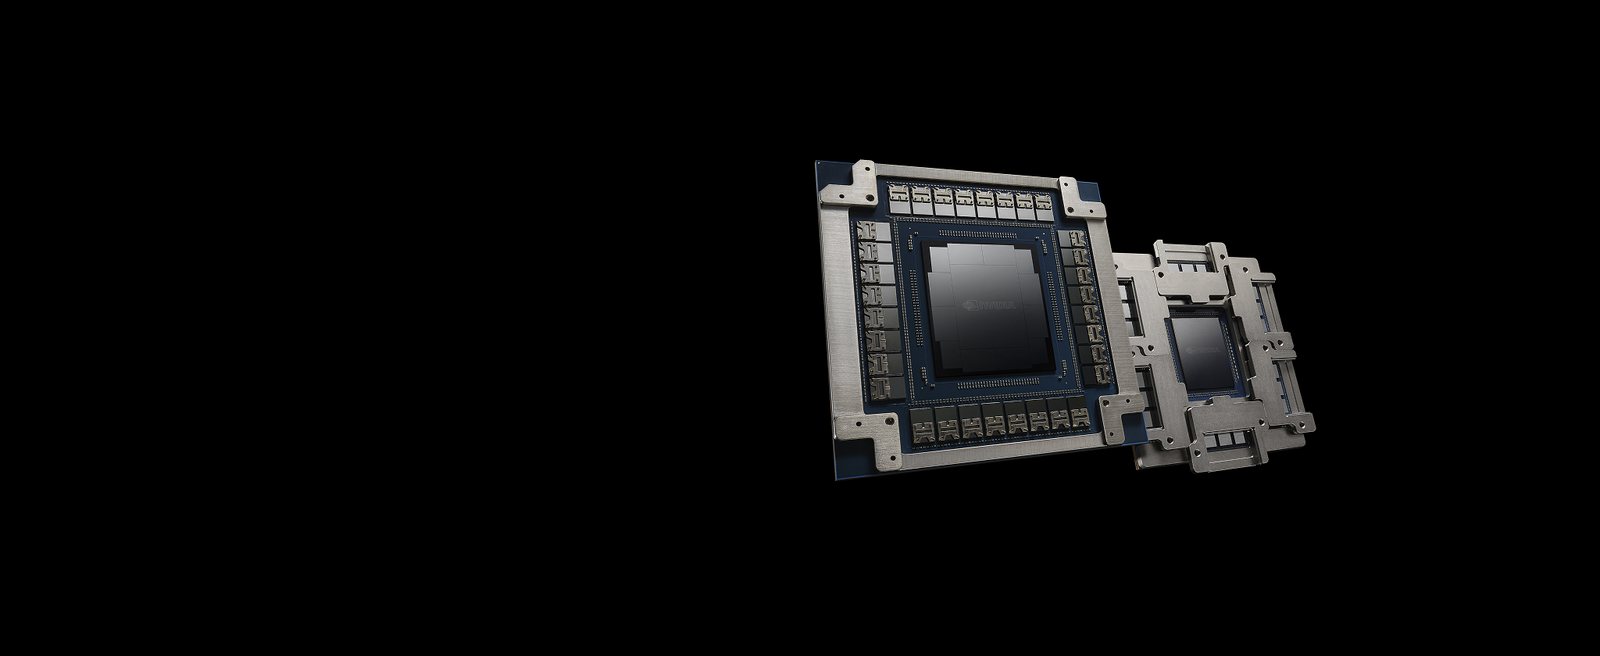
같은 계열의 다른 구성. Spectrum-X Photonics·Quantum-X Photonics가 양산에 들어갔다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)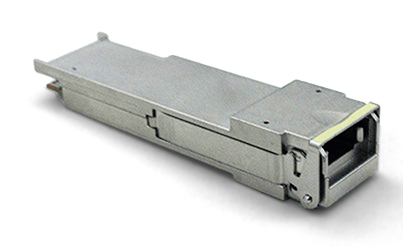
기존의 플러그형 QSFP 트랜시버 — 스위치 앞면에 하나씩 꽂는다
교체가 쉽고 규격이 표준화되어 있어 오래 쓰인 방식이다. 그런데 수천 개가 되면 개당 30 W가 전체 전력의 큰 몫이 되고, 고장 확률도 개수에 비례해 올라간다. 위 계산에서 나온 4,096개는 「하루에 몇 개가 고장 나는가」로 환산해 볼 만하다.
출처: JesseschulmanCC BY-SA 3.0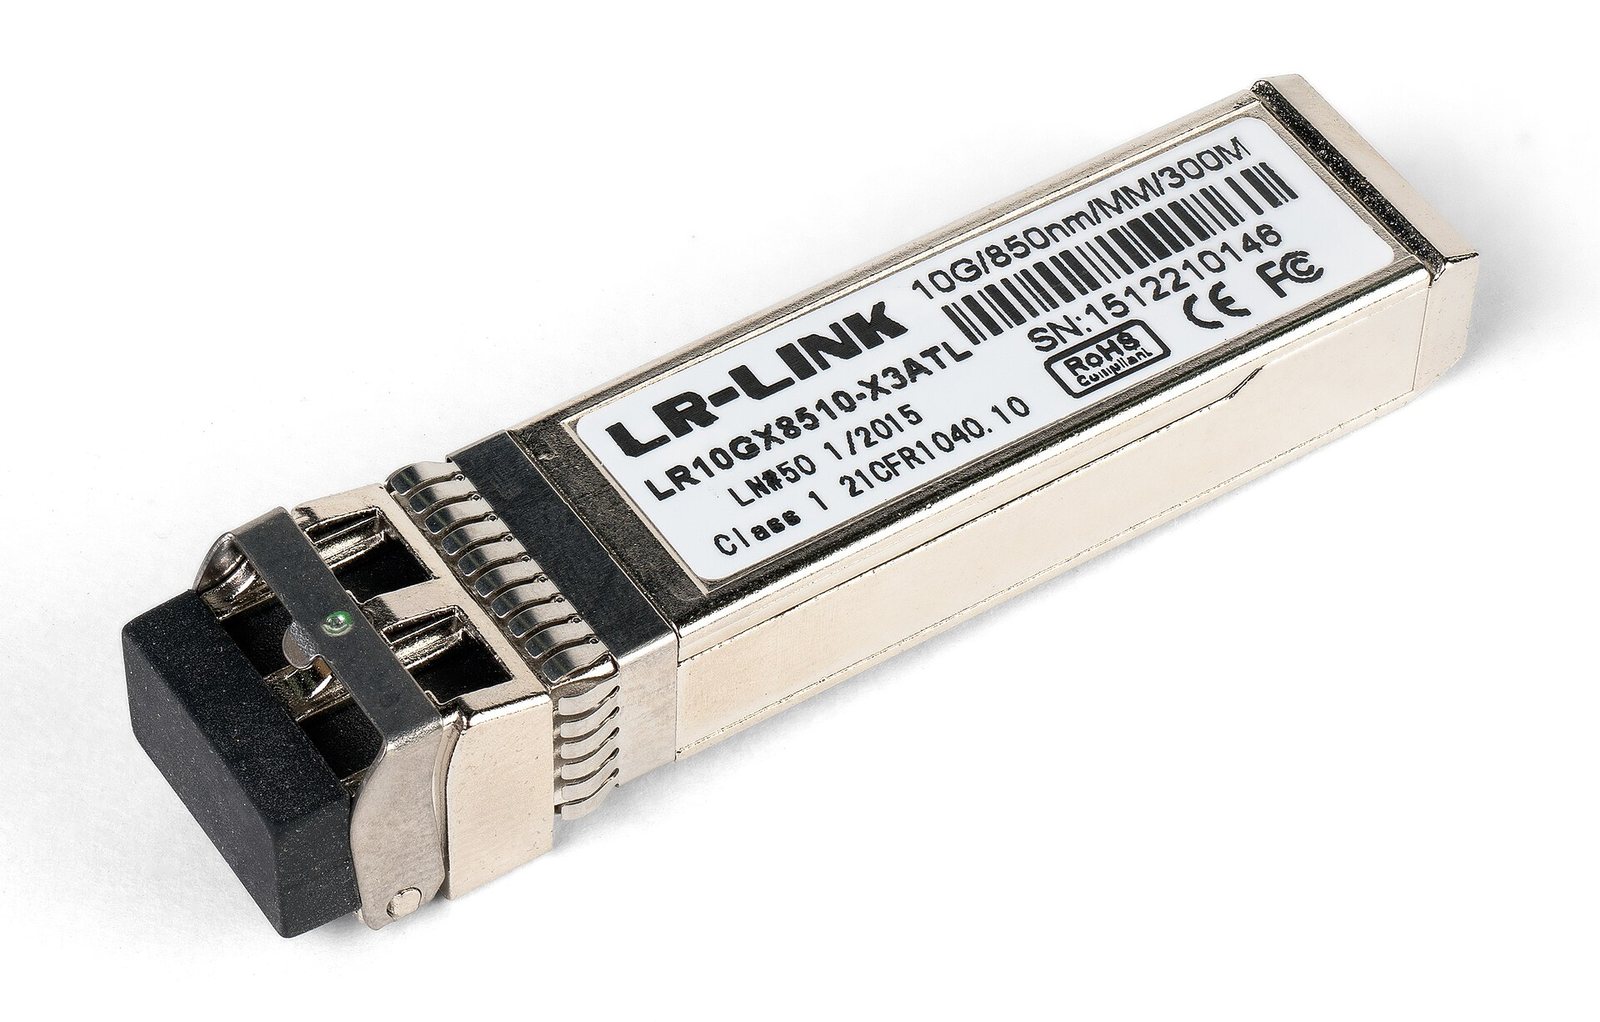
SFP 트랜시버 단품 — 안에 무엇이 들어 있나
레이저(또는 VCSEL), 수광 소자, 그리고 전기 신호와 광 신호를 변환하는 회로가 들어 있다. 전기 신호를 기판 위로 수십 cm 밀어내는 데 드는 전력이 CPO가 없애려는 부분이다. 광 자체를 없애는 것이 아니라, 전기로 달리는 거리를 줄이는 것이 요점이다.
출처: Dmitry NosachevCC BY-SA 4.0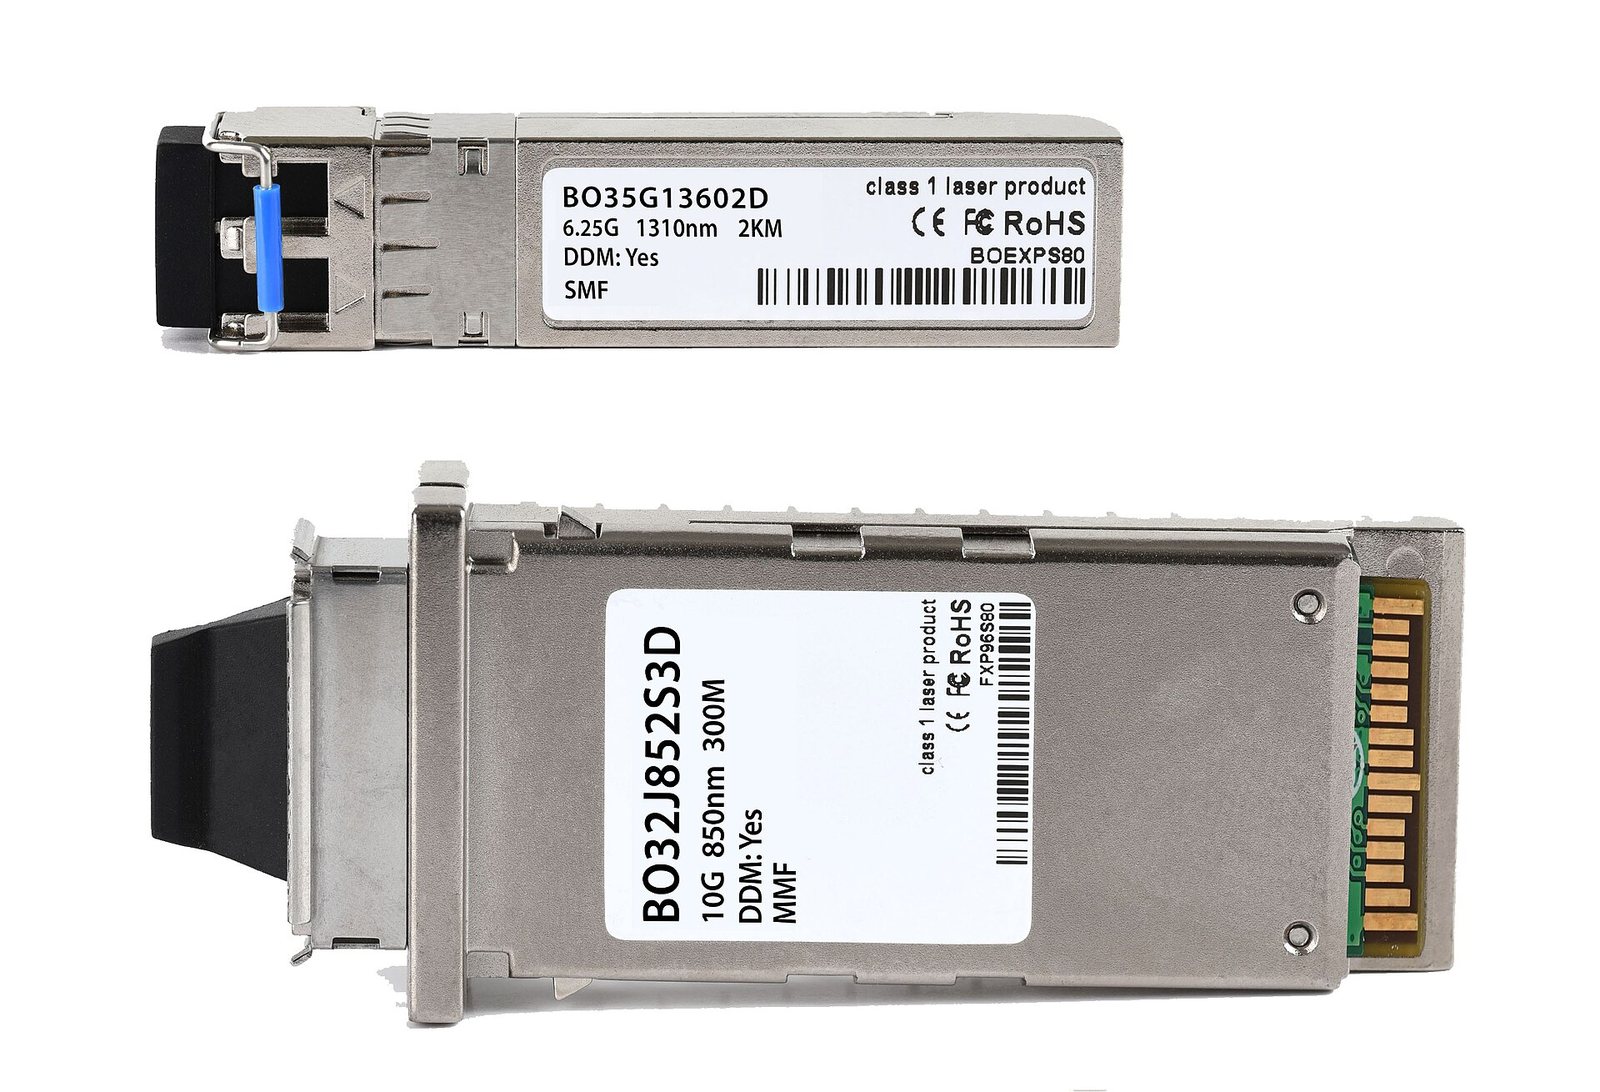
트랜시버 폼팩터의 변천 — 작아지고 빨라져 왔다
왼쪽의 큰 구형 규격에서 오른쪽의 작은 SFP로 오면서 밀도와 속도가 계속 올라갔다. 하지만 「플러그로 꽂는다」는 구조 자체의 한계에 다다른 것이 CPO 전환의 배경이다. 기술 전환은 대개 이렇게 기존 방식의 개선이 한계에 부딪힐 때 일어난다.
출처: Martijn BoerPublic domain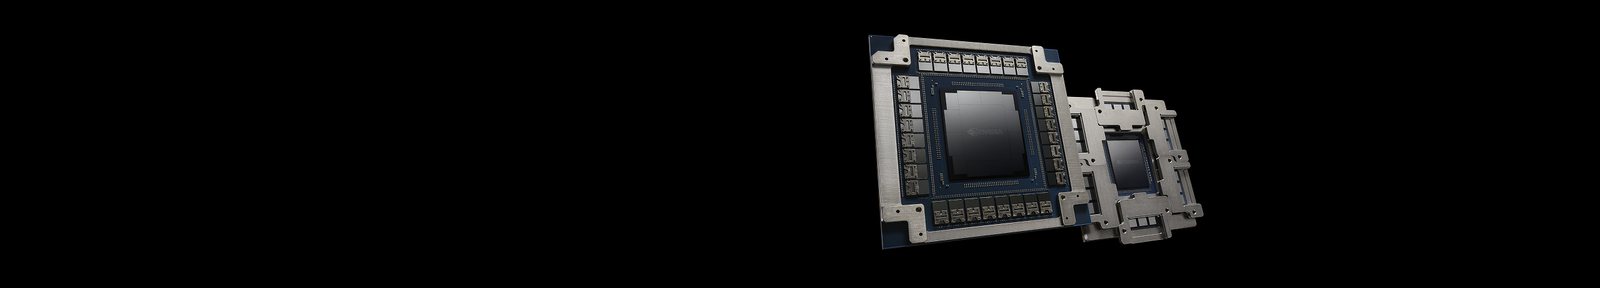
CPO 패키지를 멀리서 본 것 — 크기 감각을 위해
앞의 확대 사진과 같은 부품이다. 가운데 큰 사각형이 스위치 ASIC이고 그 둘레를 광 엔진 모듈이 감싼다. 이 구조의 대가는 유지보수다 — 광 엔진이 고장 나면 그 부분만 뽑아 갈 수 없고, 보드 단위 또는 스위치 단위로 다뤄야 한다. 기존 플러그형 트랜시버는 한 개만 갈면 됐다는 점과 대비된다. 15장의 RAS 설계와 이어진다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)CPO에는 대가도 있다. 광 엔진이 스위치에 붙박이가 되므로 고장 났을 때 그 부분만 갈아 끼울 수 없다. 신뢰성 설계와 유지보수 방식이 함께 바뀌어야 한다 — 15장 RAS와 이어진다.
실습 — 1,024 GPU 클러스터를 설계 계산하기
목표: scale-out 네트워크를 직접 설계하고, 장비 수·전력·비용을 산출한다.
1단계 — 기본형 (앞 도해와 같은 조건)
| 항목 | 값 | 계산식 |
|---|---|---|
| GPU 수 | 1,024 | 주어짐 |
| GPU당 포트 | 1 × 400G | 주어짐 |
| 스위치 포트 수 | 64 | 주어짐 |
| 리프 수 | ||
| 스파인 수 | ||
| 총 링크 수 | ||
| 광 트랜시버 수 | ||
| 트랜시버 전력 합 (30W 가정) |
2단계 — 변형 설계
- 오버서브스크립션 2:1 로 바꾸면 스위치와 트랜시버가 각각 몇 개로 줄어드는가? 절감되는 전력과 비용은? 대신 무엇을 잃는가?
- GPU 8,192대 로 늘리면 어떻게 되는가? 2계층으로 가능한가, 3계층이 필요한가? 필요하다면 그 경계는 어디에서 생기는가?
- GPU당 포트를 2개 로 늘리면(rail 2개) 무엇이 어떻게 달라지는가?
3단계 — CPO 효과 추정
기본형에서 CPO를 적용해 트랜시버 전력이 40% 줄어든다고 가정하면, 연간 전력 절감량은 얼마인가? 국내 산업용 전기요금을 적용해 금액으로 환산하라. 그 금액이 CPO 도입 프리미엄을 몇 년 만에 회수하는가?
제출물
계산 시트(수식이 살아 있을 것) + 세 가지 변형 설계의 비교표 + 「우리 학교가 1,024 GPU 클러스터를 짓는다면 어느 설계를 고를 것인가」 결론 반 장.
참고 자료
- Ultra Ethernet Consortium 규격 문서
- NVIDIA InfiniBand · Quantum-2
- Al-Fares et al., A Scalable, Commodity Data Center Network Architecture (SIGCOMM 2008) — fat-tree의 고전
- 650 Group — 네트워크 시장 자료