스토리지와 데이터 파이프라인
학습에서는 체크포인트 쓰기가, 추론에서는 KV 캐시가 스토리지를 규정한다. 둘 다 「GPU가 기다리게 만드는 일」이라는 점에서 같다. 왜 스토리지 전용 랙이 따로 서게 됐는지 여기서 답이 나온다.
이 장을 마치면
- 학습 파이프라인에서 GPU가 노는 구간을 지목하고 각각의 해법을 말할 수 있다.
- 체크포인트 쓰기 요구량을 정량적으로 계산할 수 있다.
- KV 캐시 계층화를 대역폭·용량 관점에서 설계할 수 있다.
- GPUDirect Storage와 DPU 오프로드가 해결하는 문제를 설명할 수 있다.
학습 측 — 데이터를 대는 일과 상태를 남기는 일
학습 한 스텝의 시간 분해. 겹치기가 안 되면 기다림이 그대로 스텝 시간이 된다.
직접 제작 도해 · 자유 사용① 데이터 로딩
GPU가 초당 처리할 수 있는 샘플 수를 스토리지가 못 따라오면 GPU는 굶는다. 특히 이미지·비디오가 섞인 멀티모달 학습에서는 디코딩 부하까지 겹쳐 CPU가 먼저 막힌다(3장).
- 미리 읽기(prefetch) — 다음 배치를 현재 스텝 계산 중에 미리 가져온다. 가장 기본이고 효과가 크다.
- 병렬 파일시스템 — Lustre, VAST, WEKA 등. 수천 노드가 동시에 읽어도 버티게 한다.
- GPUDirect Storage — 스토리지에서 CPU 메모리를 거치지 않고 GPU 메모리로 직접 DMA. 3장에서 본 PCIe 왕복을 한 번 없앤다.
- DPU 오프로드 — 파일시스템 클라이언트와 네트워크 처리를 DPU가 대신한다. 호스트 CPU가 데이터 준비에 집중할 수 있게 된다.
② 체크포인트 — 주기적으로 찾아오는 폭주
1조 파라미터 모델을 BF16으로 학습한다고 하자. 가중치만 2 TB이고, 옵티마이저 상태(Adam이면 모멘텀·분산)까지 합치면 체크포인트 한 번에 수 TB를 써야 한다.
이것을 1분 안에 끝내려면 수 TB/분의 쓰기 대역폭이 필요하다. 그동안 학습을 멈추면 그 시간이 통째로 손실이다. 그래서 비동기 체크포인트(GPU 메모리에서 스냅샷을 뜬 뒤 백그라운드로 쓰기)가 필수가 된다.
체크포인트가 중요한 진짜 이유는 장애 때문이다. 수만 GPU가 몇 주 도는 잡에서는 어딘가 반드시 고장 난다. 체크포인트 간격이 길면 장애 시 되돌아가는 시간이 길어지고, 짧으면 쓰기 오버헤드가 커진다. 이 균형이 12장 Goodput의 큰 몫이다.
추론 측 — KV 캐시라는 새로운 스토리지 문제
추론에서 스토리지는 전통적인 「파일을 읽고 쓰는」 문제가 아니다. KV 캐시를 어디에 둘 것인가의 문제다.
2장에서 본 메모리 계층. 추론에서는 KV 캐시가 이 계단을 오르내린다.
직접 제작 도해 · 자유 사용KV 캐시가 커지는 속도
컨텍스트가 길어질수록 KV 캐시는 선형으로 커진다. 동시 사용자가 많으면 사용자 수만큼 또 곱해진다. 그래서 긴 컨텍스트 · 다수 동시접속 서비스에서는 모델 가중치보다 KV 캐시가 HBM을 더 많이 잡아먹는 상황이 흔하다.
| 둘 곳 | 언제 쓰는가 | 대가 |
|---|---|---|
| HBM | 지금 생성 중인 요청 | 가장 비싸고 좁다 |
| 호스트 DRAM | 잠시 쉬는 대화 세션 | 대역폭이 한 자릿수 떨어진다 |
| 로컬 NVMe | 재방문 가능성이 있는 프리픽스 | 지연이 크게 늘어난다 |
| 네트워크 오브젝트 | 공용 시스템 프롬프트 등 장기 재사용 | 가장 느리지만 무제한 |
여러 요청이 같은 시작 부분(시스템 프롬프트, 문서, 대화 이력)을 공유한다면, 그 부분의 KV 캐시를 다시 계산할 필요가 없다. 저장해 두고 재사용하면 된다.
이것은 스토리지 문제로 보이지만 실은 프리필 연산을 없애는 일이다. 1장에서 프리필이 연산 집약이라고 했으니, 프리픽스 재사용은 연산을 스토리지 읽기로 바꾸는 거래인 셈이다. 얼마나 이득인지는 「다시 계산하는 비용 vs 읽어오는 비용」으로 판단한다.
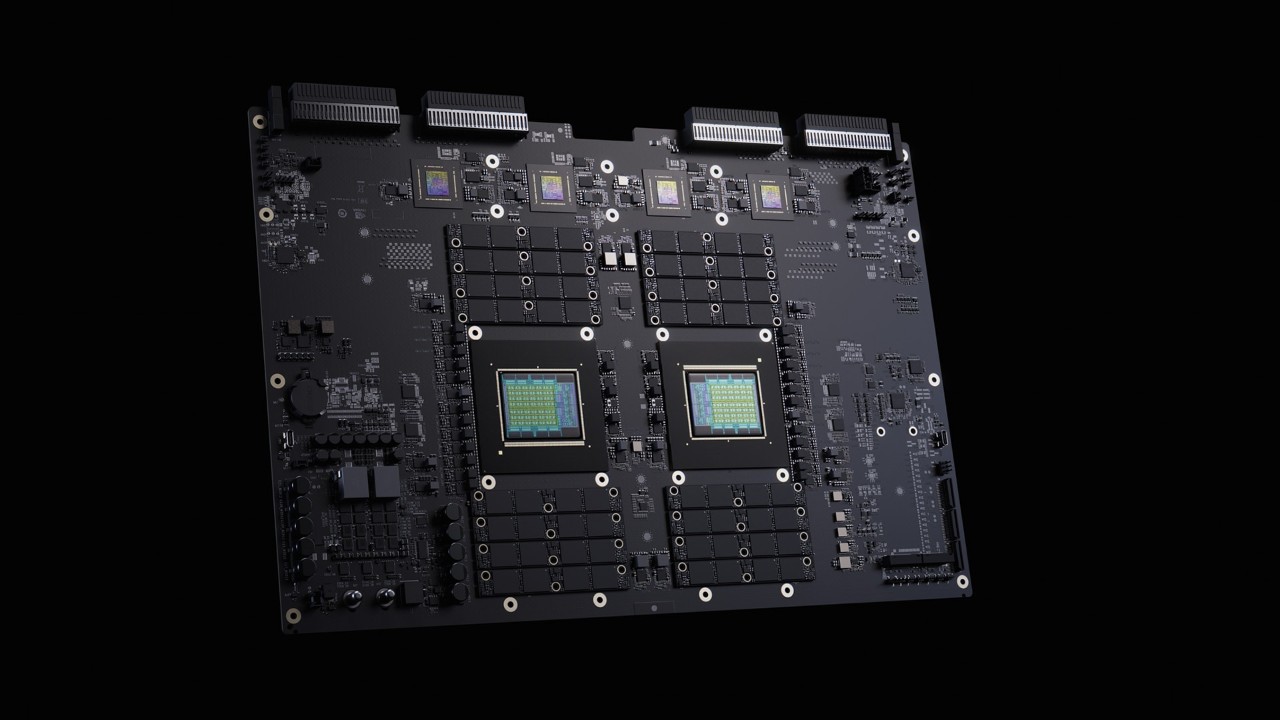
BlueField-4 STX 스토리지 프로세서. 4장의 5종 랙 중 스토리지 랙의 심장이다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)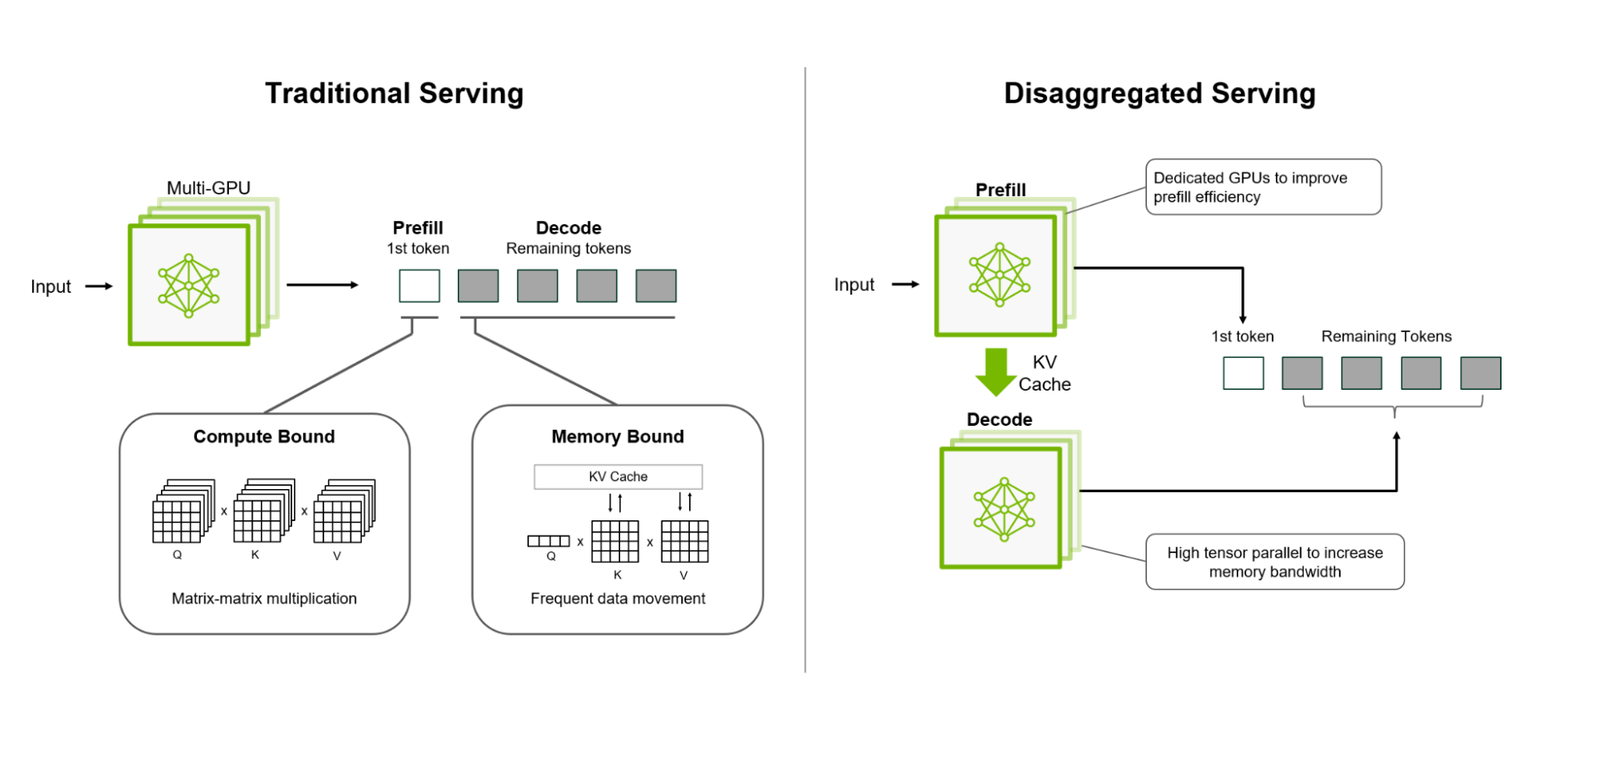
프리필과 디코드를 분리하면 KV 캐시를 랙 사이로 전송해야 한다. 이 전송 계층이 NIXL(NVIDIA)·MORI-IO(AMD)이며, 13장에서 자세히 다룬다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)여기서 4장의 질문으로 돌아가 보자. 왜 스토리지 랙이 따로 서는가? 체크포인트 폭주와 KV 캐시 계층화는 둘 다 「대량의 데이터를 빠르게 옮기는 일」이고, GPU 노드에 맡기면 GPU가 그 일에 발목을 잡힌다. 떼어내는 것이 이득이다.
스토리지 계층을 실제로 어떻게 구성하는가
「병렬 파일시스템을 쓴다」는 한 줄로 끝나지 않는다. 학습 데이터, 체크포인트, 로그, 모델 산출물은 요구가 전부 다르고, 각각을 어느 계층에 둘지가 설계다.
| 데이터 | 접근 패턴 | 요구 | 두는 곳 |
|---|---|---|---|
| 학습 데이터셋 | 매 에폭 전체를 읽는다 · 순차에 가깝다 | 높은 읽기 대역폭 · 큰 용량 | 병렬 FS + 노드 로컬 캐시 |
| 체크포인트 | 주기적으로 몰아서 쓴다 · 거의 안 읽는다 | 폭발적 쓰기 대역폭 | 병렬 FS (쓰기 최적화 영역) |
| 모델 산출물 | 가끔 읽는다 | 안정성 · 버전 관리 | 오브젝트 스토리지 |
| 로그 · 메트릭 | 계속 조금씩 쓴다 | 낮은 대역폭 · 긴 보존 | 별도 시계열 저장소 |
| KV 캐시 (추론) | 빠르게 쓰고 빠르게 읽는다 | 지연이 전부 | HBM → DRAM → 로컬 NVMe |
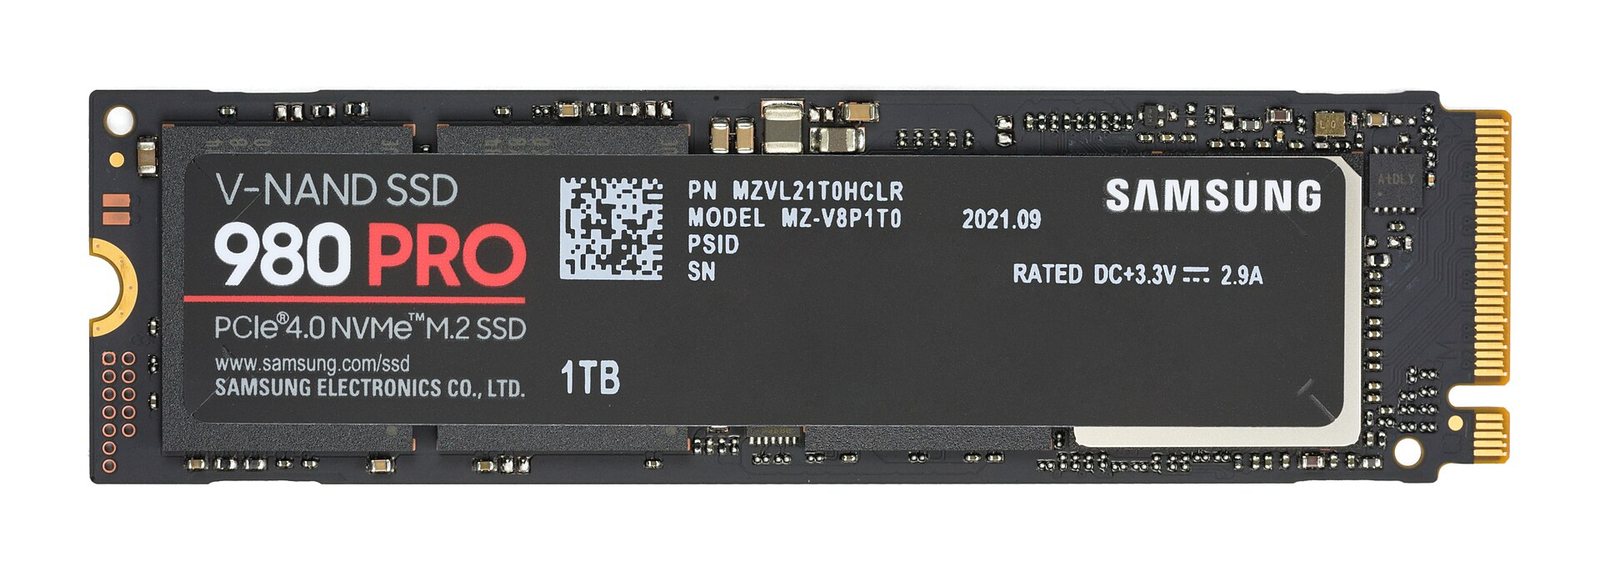
NVMe SSD — 노드 로컬 계층의 실체
PCIe로 직접 붙는 SSD다. SATA 시절의 수백 MB/s에서 수 GB/s로 올라오면서 「노드에 로컬 캐시를 두자」는 설계가 현실적이 됐다. 10장의 KV 캐시 오프로딩에서 마지막 계층으로 쓰이는 것도 이것이다.
출처: D-KuruCC BY-SA 4.0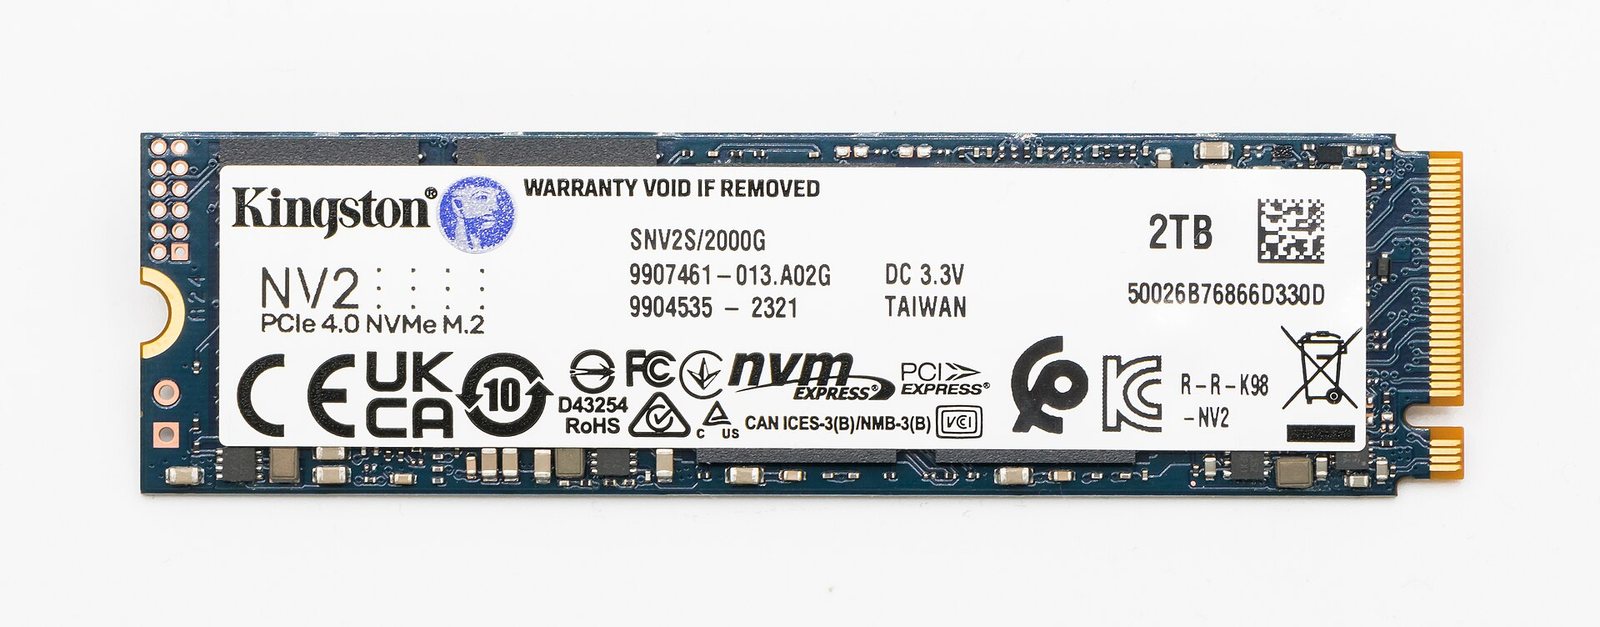
M.2 폼팩터 — 서버 보드에 직접 꽂는다
작아서 노드마다 여러 장을 넣을 수 있다. 용량보다 「몇 장을 병렬로 붙일 수 있는가」가 대역폭을 결정하므로, 노드 설계에서 M.2 슬롯 수가 중요한 사양이 된다.
출처: Jacek HalickiCC BY-SA 4.0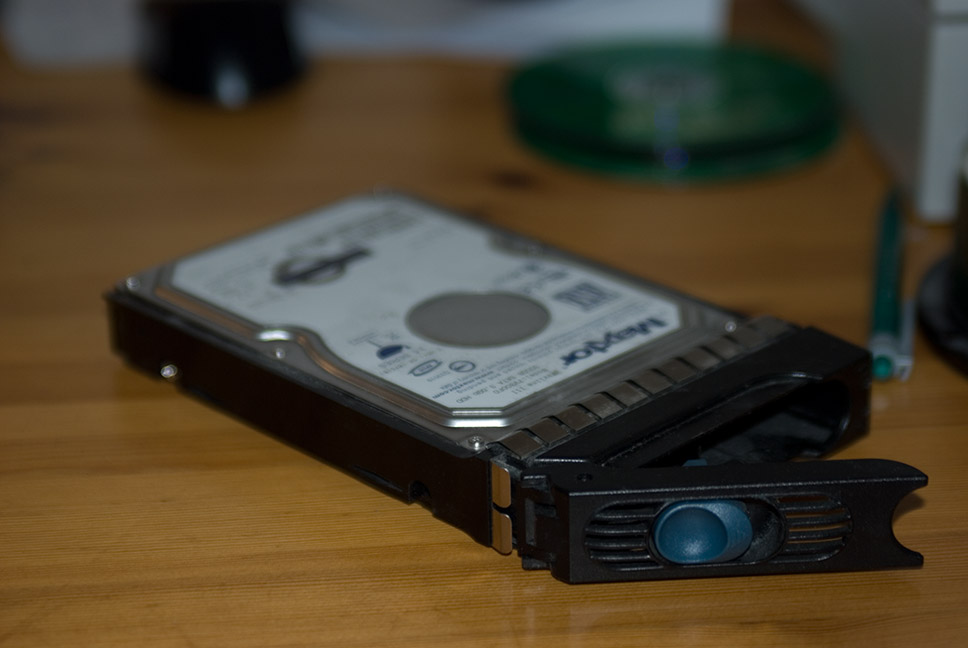
RAID — 여러 장을 묶어 대역폭과 내구성을 얻는 오래된 방법
병렬 파일시스템도 근본 발상은 같다 — 여러 장치에 나눠 써서 대역폭을 곱한다. 7장의 SRAM 기반 추론에서 「나눠 담으면 대역폭도 곱해진다」고 한 것과 정확히 같은 원리가 스토리지에서도 성립한다.
출처: EptalonCC BY-SA 3.0그리고 가장 아래 계층 — 테이프는 아직 살아 있다
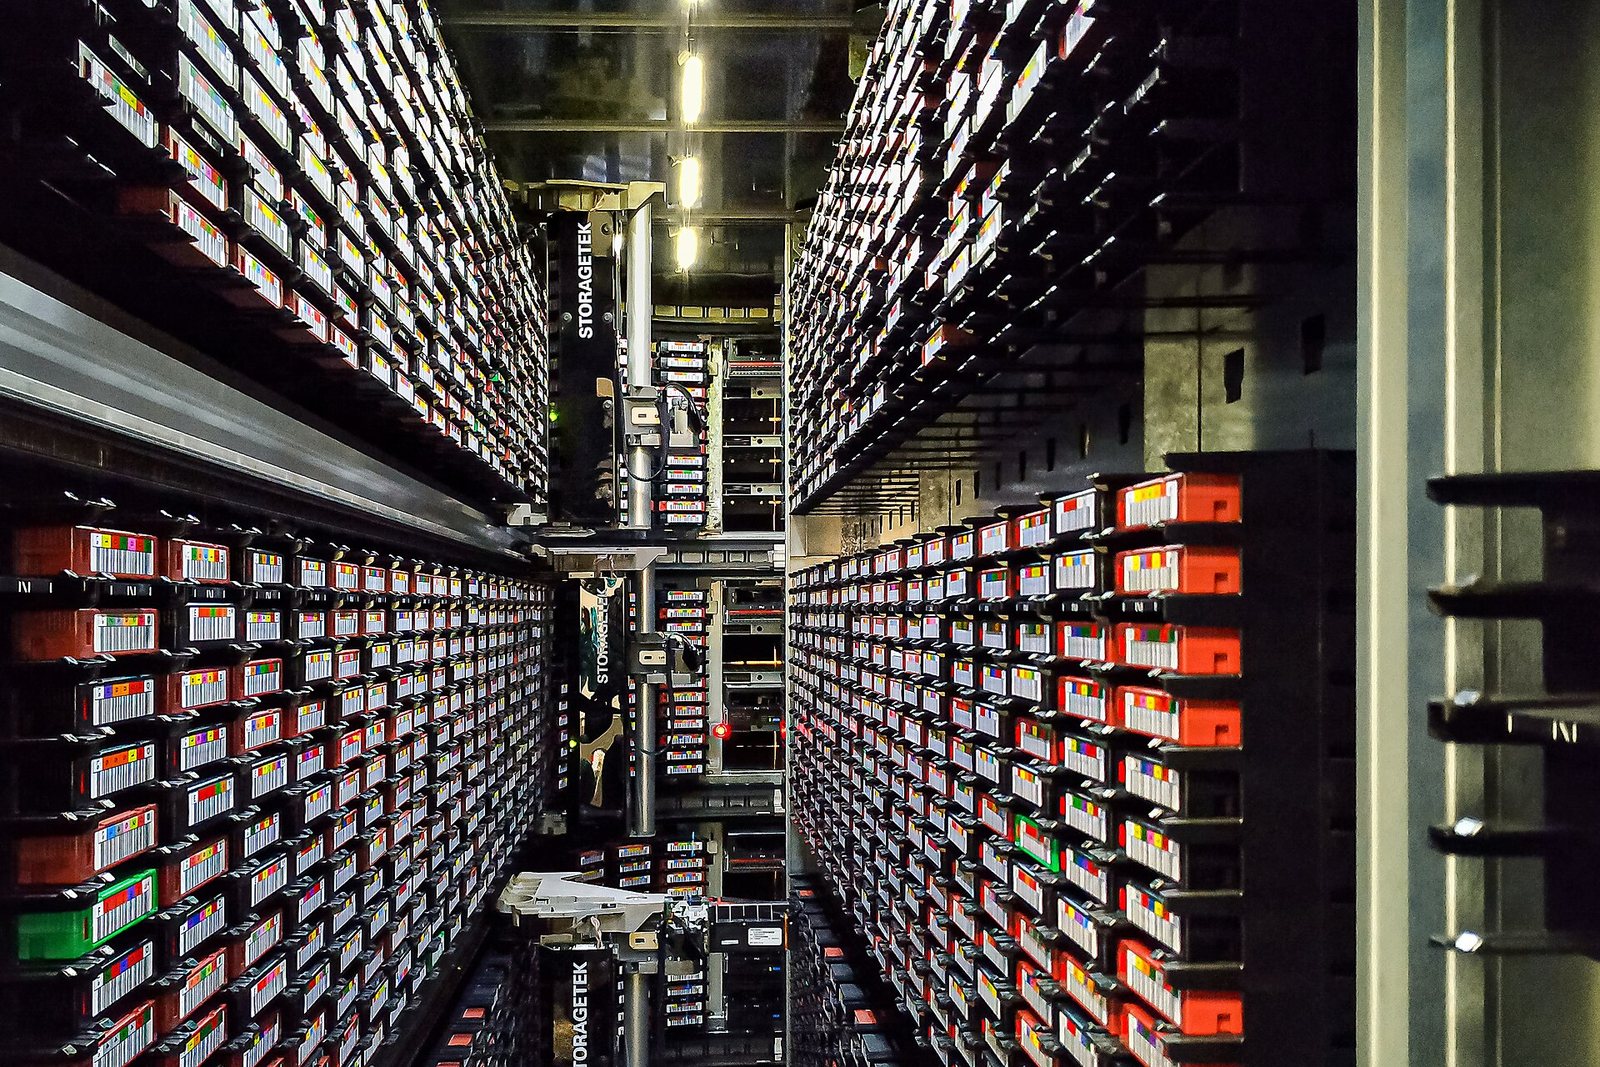
학습 데이터 원본과 오래된 체크포인트는 자주 읽지 않지만 버릴 수도 없다. 이런 데이터는 여전히 테이프에 보관하는 것이 압도적으로 싸다.
테이프 라이브러리 — 로봇이 카트리지를 꺼내 온다
용량당 비용이 디스크의 몇 분의 일이고 전력을 거의 안 쓴다(꽂혀 있지 않으므로). 대신 읽으려면 로봇이 카트리지를 찾아 드라이브에 넣고 되감아야 해서 지연이 분 단위다. 2장의 메모리 계층도를 아래로 한 칸 더 늘린 셈이다.
출처: Jorge FranganilloCC BY 2.0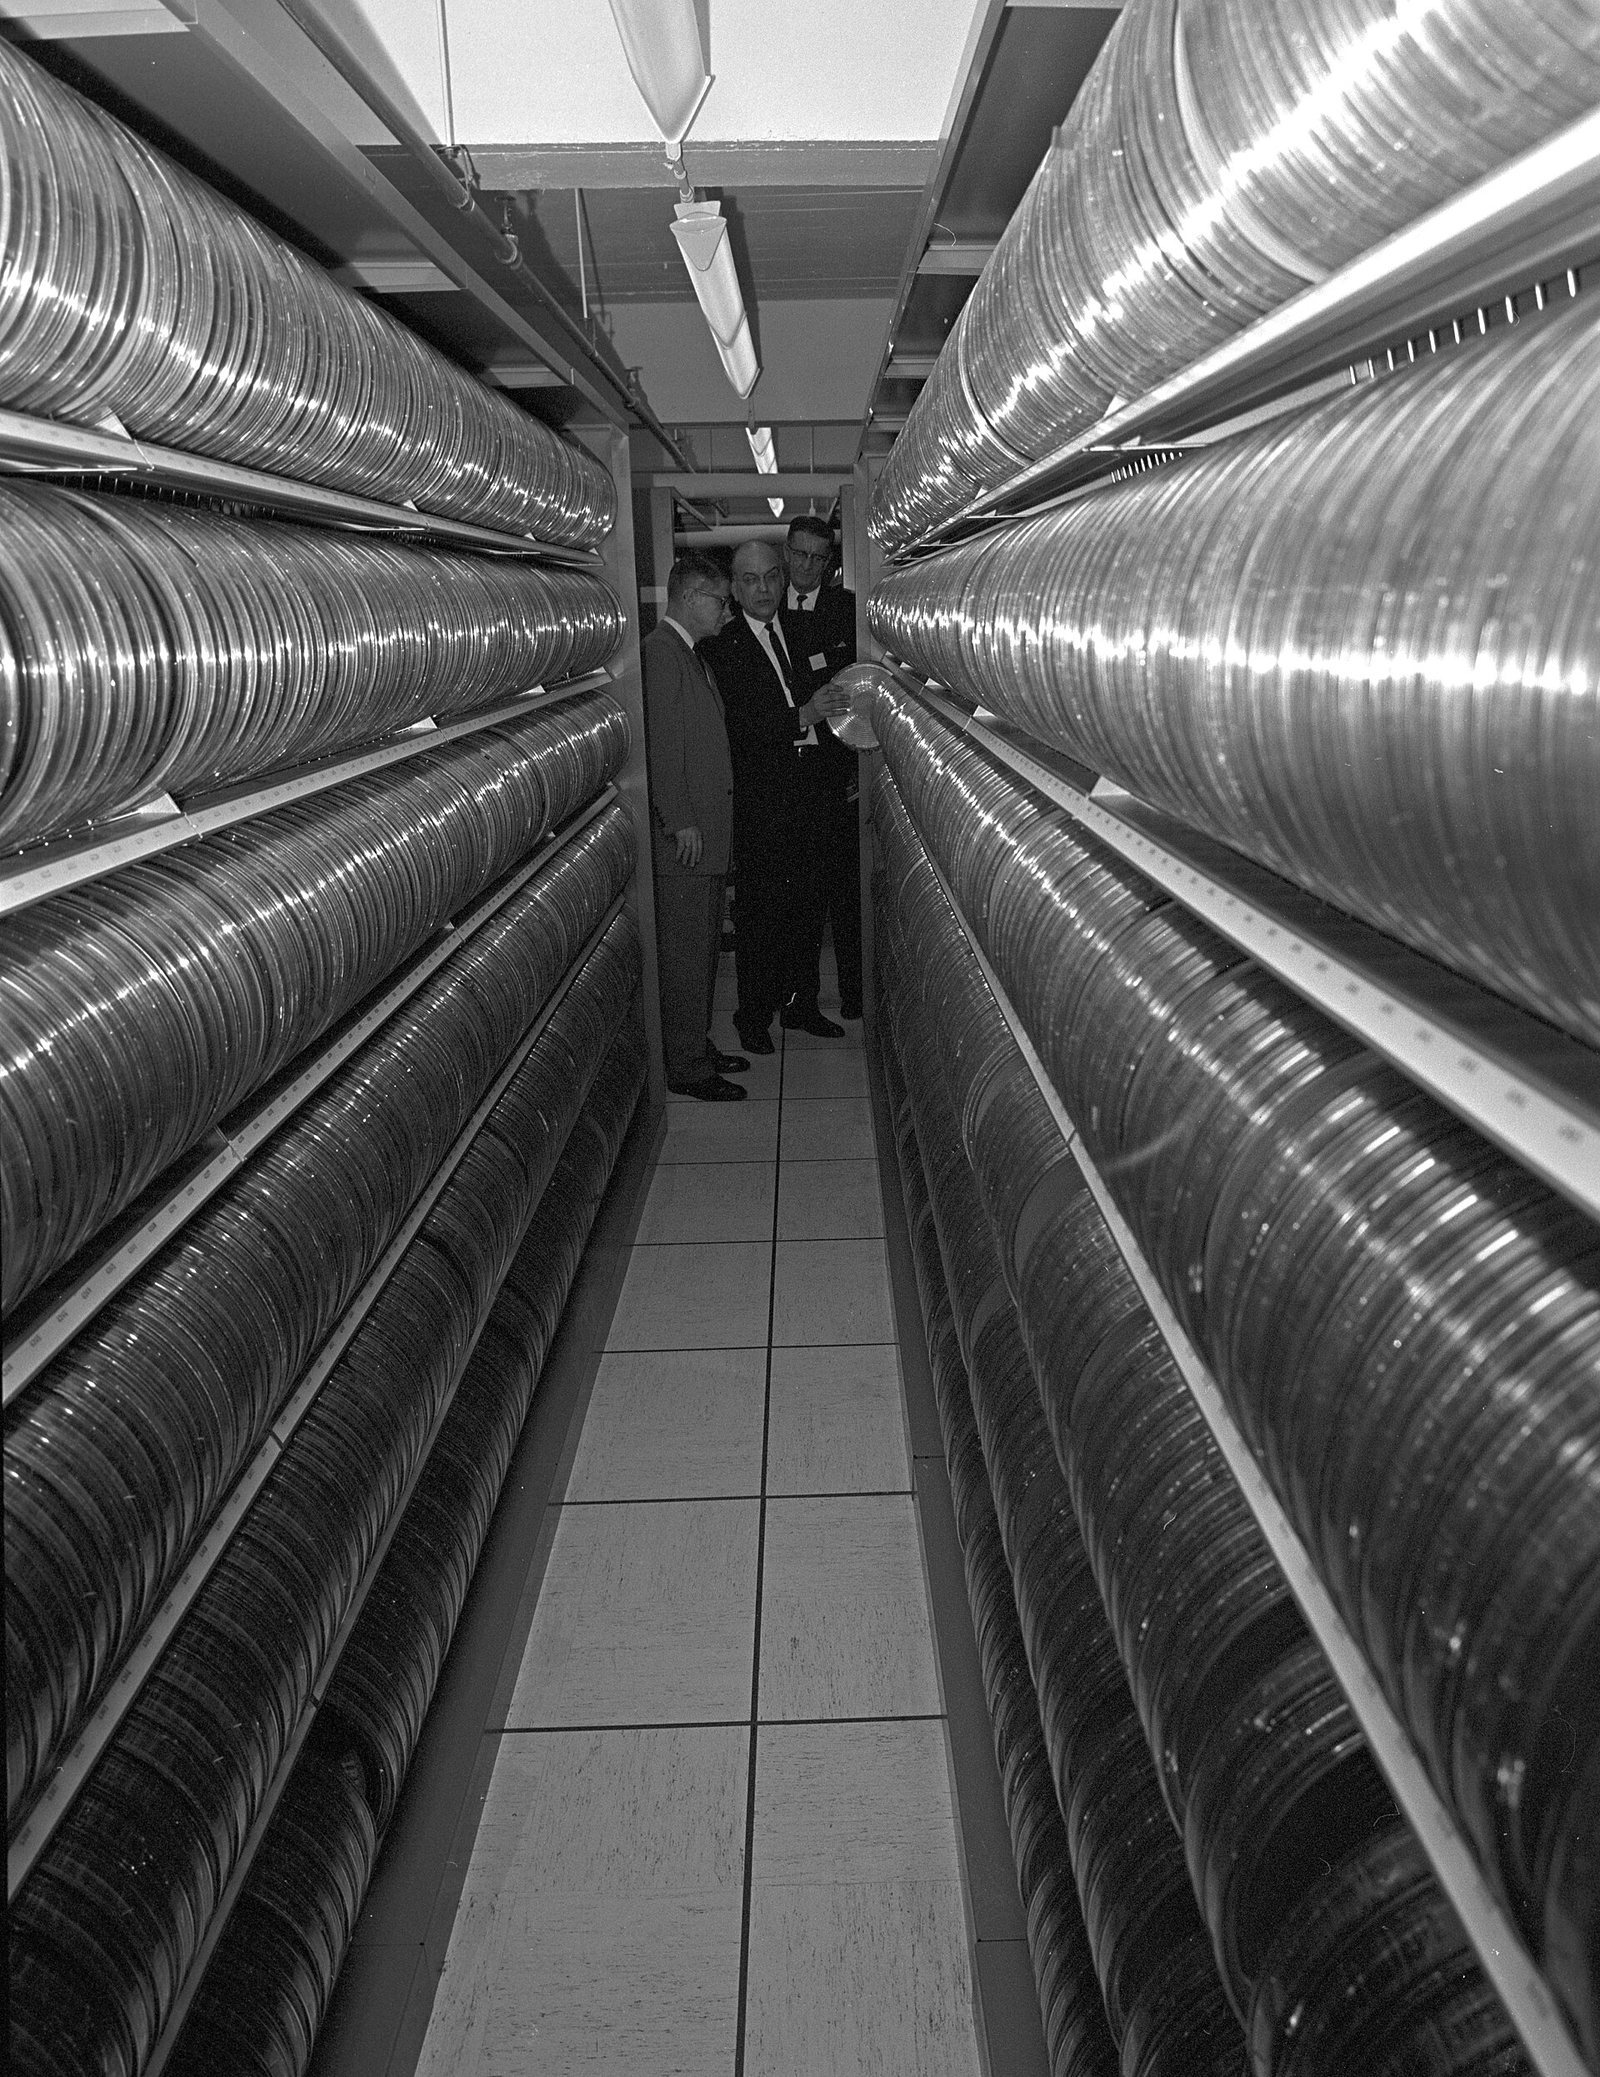
대형 테이프 라이브러리의 규모
선반 하나가 페타바이트급이다. AI 학습 데이터셋이 커질수록 이 계층의 중요성이 커진다 — 수십 PB의 원본 데이터를 전부 디스크에 두는 것은 비용이 감당되지 않기 때문이다.
출처: U.S. Department of AgriculturePublic domain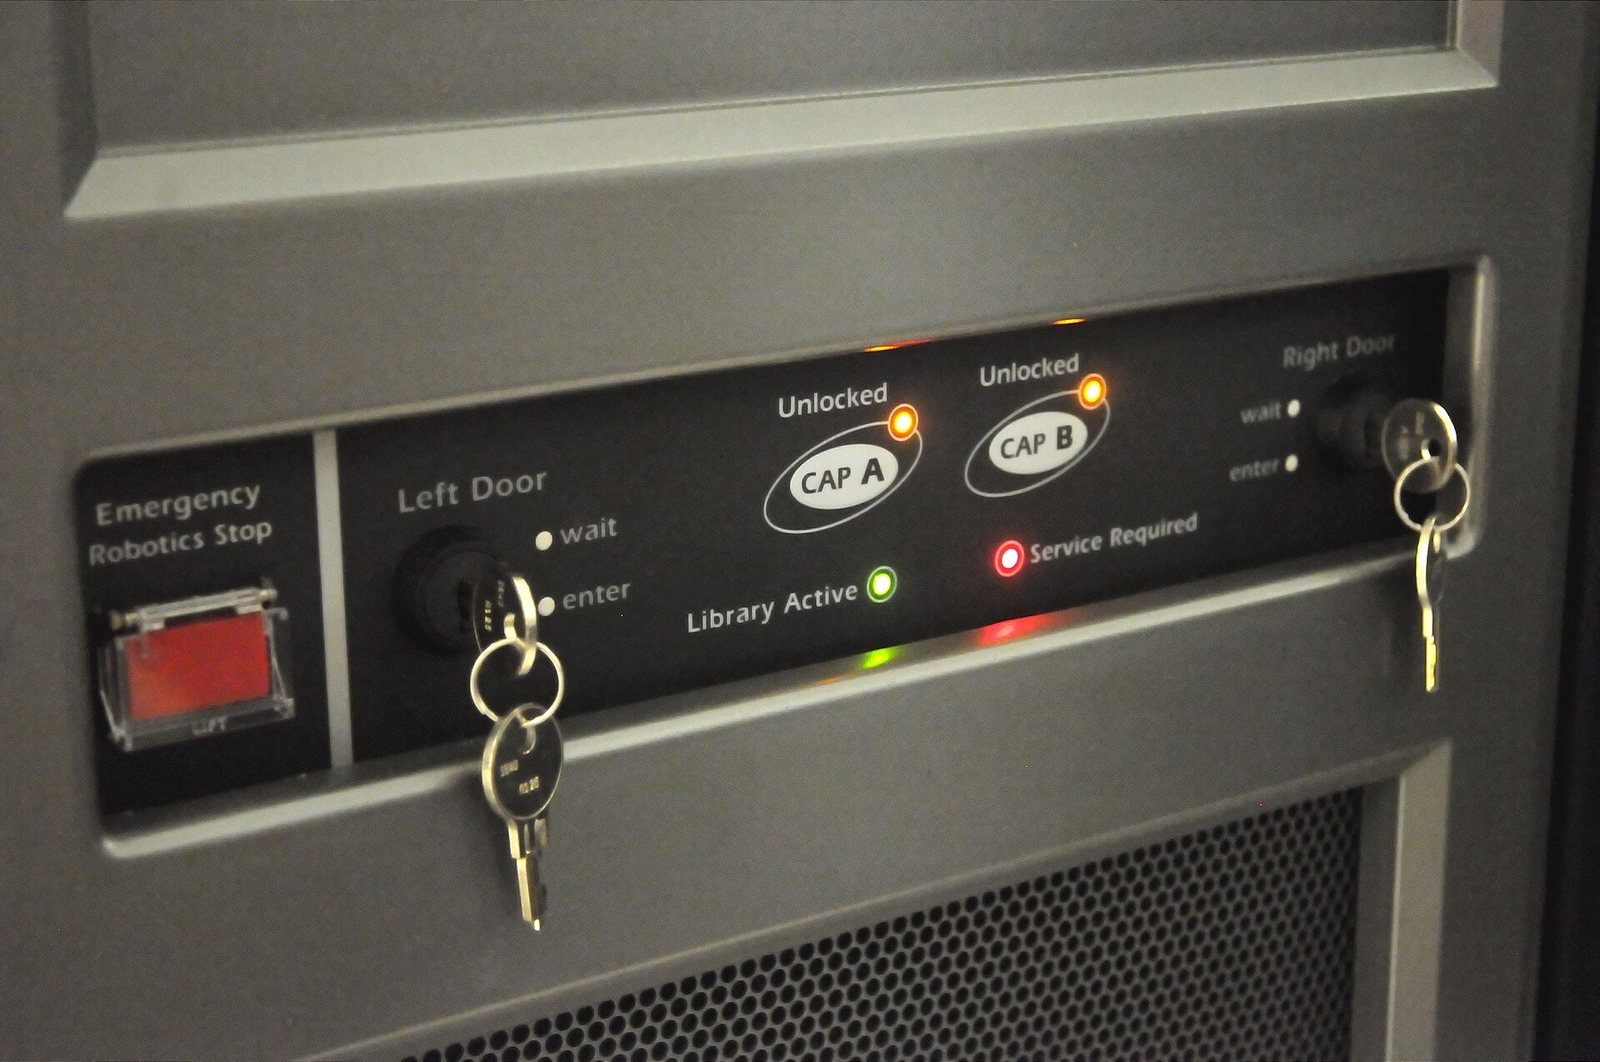
정비 패널 — 로봇과 드라이브의 상태
기계 부품이 있으므로 고장도 기계적이다. 로봇 팔, 그리퍼, 드라이브 헤드. 15장에서 「장애를 전제로 한 운영」을 이야기할 때, 스토리지 계층마다 고장 양상이 다르다는 점을 기억해 두자.
출처: Derrick Coetzee from Berkeley, CA, USACC0학습 데이터셋이 노드 로컬 NVMe에 들어갈 크기라면, 한 번만 복사해 두고 그 뒤로는 로컬에서 읽으면 된다. 네트워크와 병렬 FS 부하가 통째로 사라진다.
들어가지 않는 크기라도 자주 쓰는 부분만 캐시하는 방식이 효과가 크다. 「병렬 FS를 더 크게 사는 것」보다 「노드에 NVMe를 넣는 것」이 훨씬 싼 경우가 많다 — 17장 설계에서 검토할 만한 선택지다.
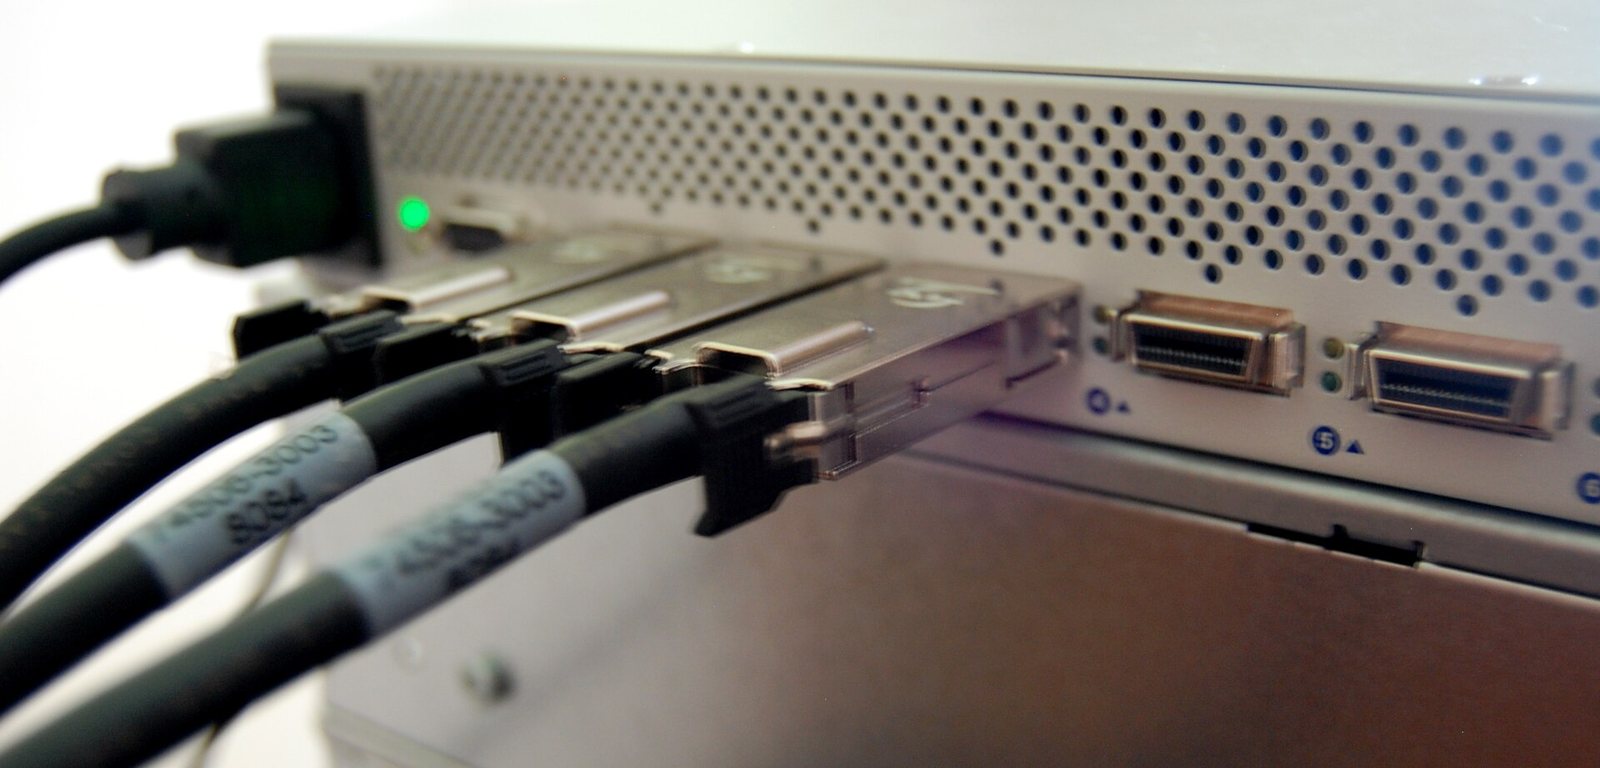
스토리지도 결국 같은 네트워크를 쓴다
연산 트래픽과 스토리지 트래픽이 같은 패브릭을 공유하면 서로를 방해한다. 체크포인트를 쓰는 순간 all-reduce가 느려지는 현상이 대표적이다. 그래서 9장의 4계층 구분에서 스토리지 네트워크를 따로 두거나, QoS로 대역폭을 나눠 주는 설계를 한다.
출처: ChrisDagCC BY 2.0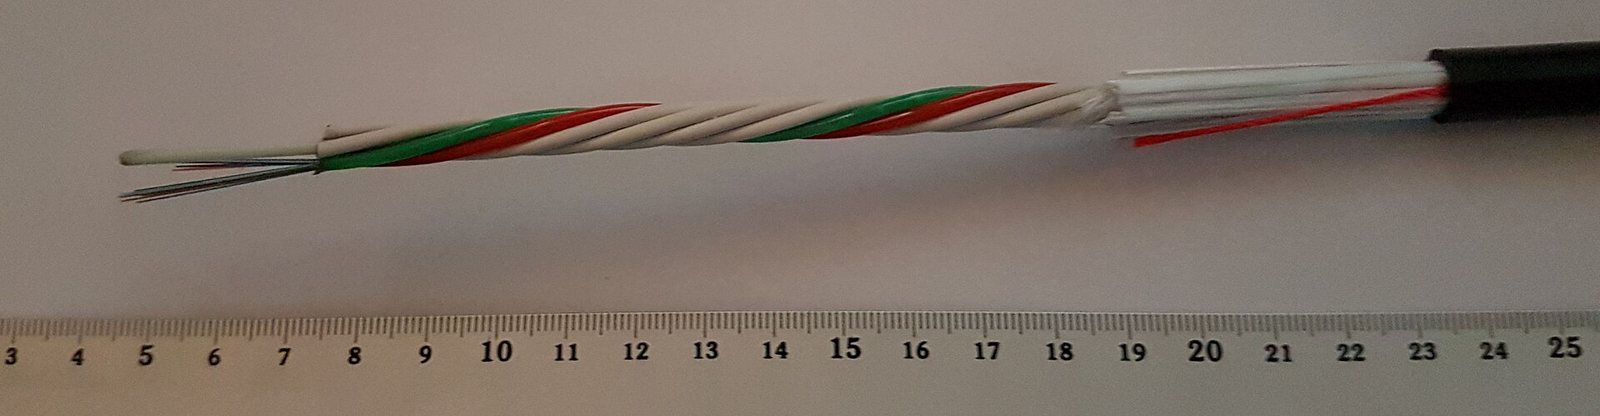
광케이블 다발 — 스토리지 트래픽도 이 위를 지난다
한 가닥 한 가닥이 링크다. 연산 트래픽과 스토리지 트래픽이 같은 다발을 공유하면 체크포인트를 쓰는 순간 학습 통신이 밀린다. 9장의 4계층 구분에서 스토리지 네트워크를 따로 세는 이유가 이것이다.
출처: AsurnipalCC BY-SA 4.0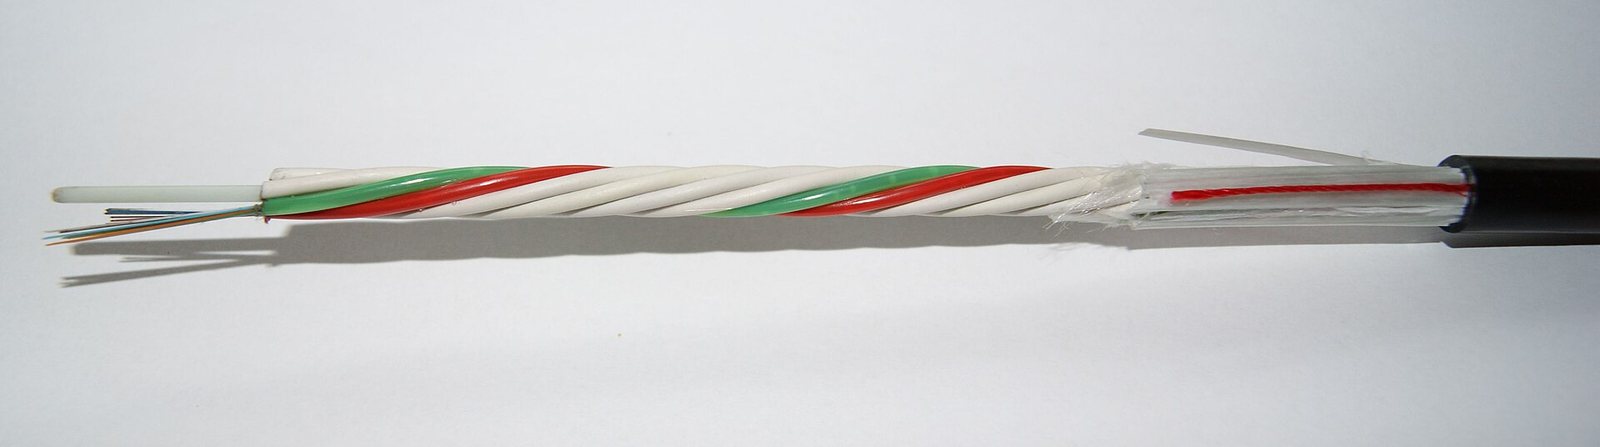
광케이블 단면 — 코어와 클래딩
가운데 유리 심(코어)으로 빛이 지나고, 주변 클래딩이 빛을 가둔다. 구리와 달리 거리가 멀어져도 신호가 크게 나빠지지 않는 것이 광의 강점이며, 그래서 랙 사이·건물 사이는 광이고 랙 안은 아직 구리다. 9장의 CPO는 이 경계를 칩 쪽으로 더 밀어붙이는 시도다.
출처: AsurnipalCC BY-SA 4.0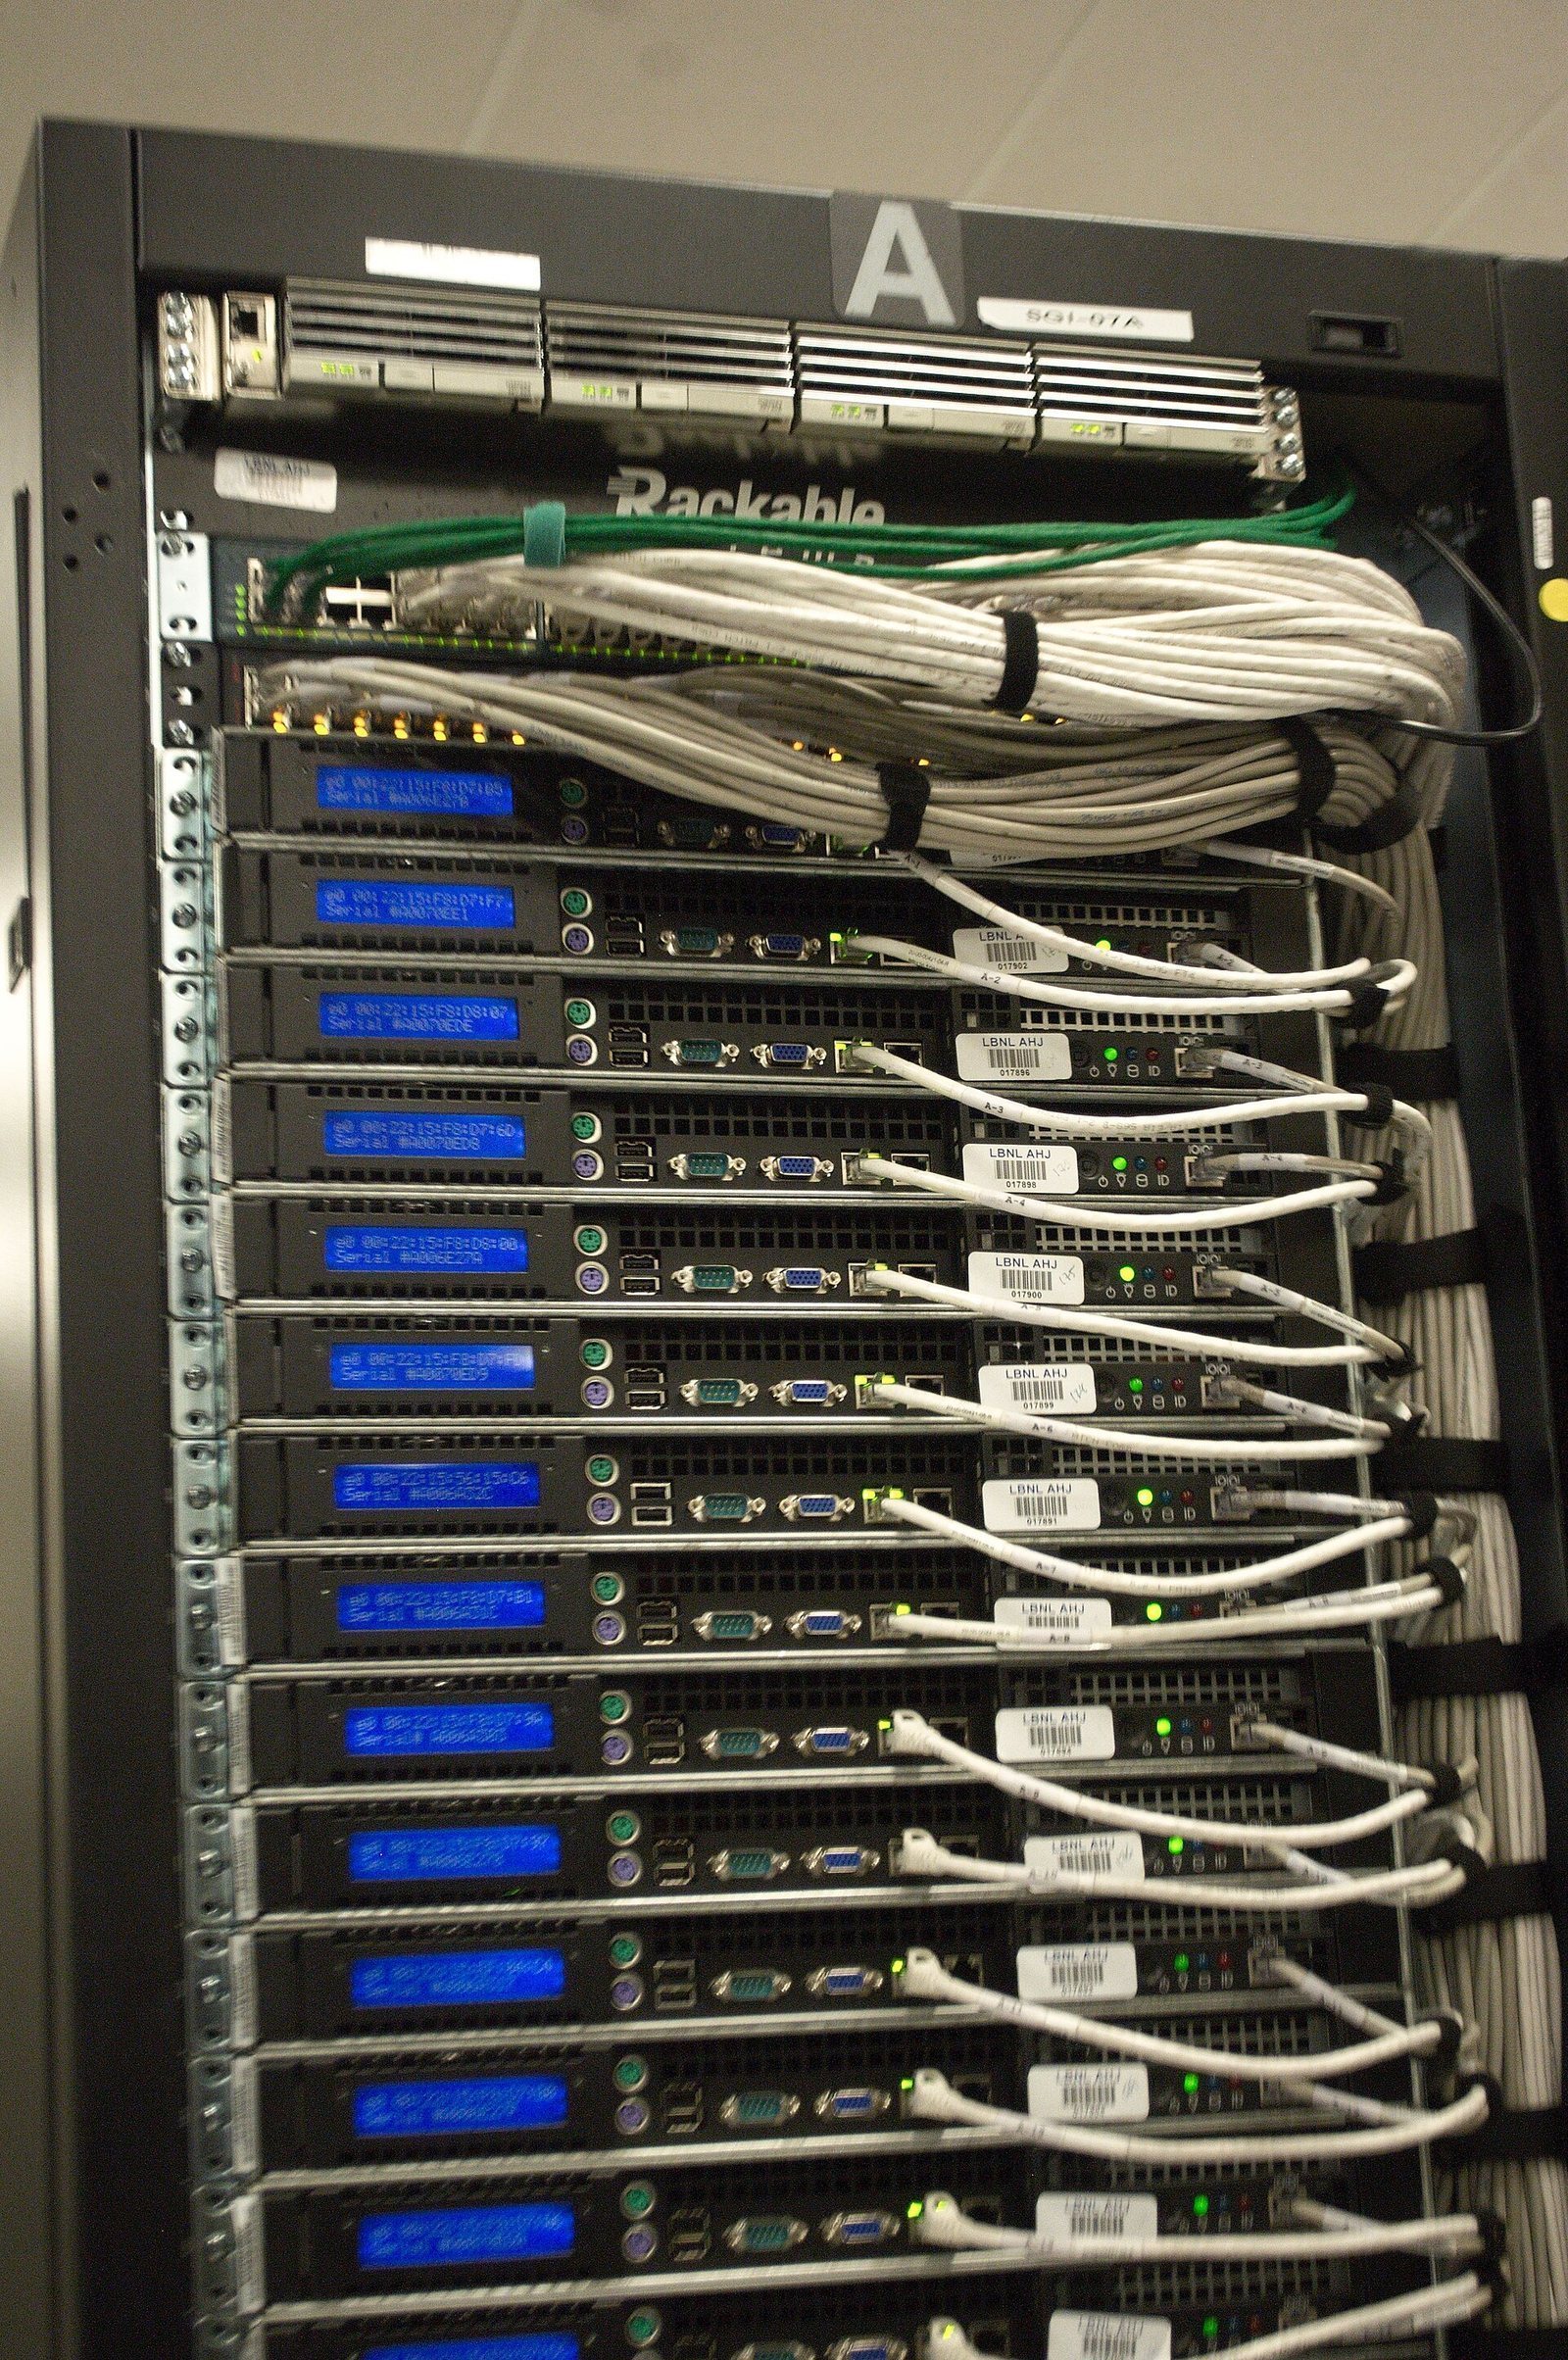
스토리지 노드도 랙에 들어간다
4장에서 본 「스토리지 전용 랙」이 이런 모습이다. 디스크·SSD를 빽빽하게 채운 서버들이 늘어서고, 그 앞단에 DPU나 파일시스템 서버가 붙는다. 연산 랙과 별도로 전력·냉각 예산을 잡아야 한다 — 11장 계산에서 빠뜨리기 쉬운 항목이다.
출처: Derrick Coetzee from Berkeley, CA, USACC0체크포인트 전략 — 얼마나 자주, 어떻게
체크포인트는 보험이다. 보험료(쓰기 오버헤드)와 보장 범위(장애 시 잃는 시간)의 균형을 잡는 일이다.
최적 간격을 구하는 방법
잃는 시간의 기댓값 = 체크포인트 쓰기 비용 + 장애 시 되감기 비용

  쓰기 비용     = (전체 시간 ÷ 간격) × 1회 쓰기 시간
  되감기 비용   = (전체 시간 ÷ 평균무고장시간) × (간격 ÷ 2)
                   ↑ 장애는 간격 중간쯤에서 난다고 보면 평균 절반을 잃는다

  → 두 항의 합을 최소로 하는 간격 ≈ √(2 × 1회쓰기시간 × 평균무고장시간)
예를 들어 1회 쓰기가 2분이고 클러스터의 평균 무고장 시간이 6시간이라면, 최적 간격은 대략 √(2×2×360) ≈ 38분 이 된다. 클러스터가 커질수록 평균 무고장 시간이 짧아지므로 체크포인트를 더 자주 해야 한다 — 수만 GPU 규모에서 이 항목이 Goodput의 큰 몫을 차지하는 이유다.
쓰기 비용을 줄이는 방법들
| 기법 | 원리 | 효과 | 주의 |
|---|---|---|---|
| 비동기 체크포인트 | GPU 메모리에서 스냅샷만 뜨고 쓰기는 백그라운드로 | 학습이 멈추는 시간이 거의 0 | 스냅샷 동안 메모리가 두 배 필요 |
| 샤딩 | 각 랭크가 자기 몫만 쓴다 | 쓰기가 병렬로 나뉘어 빨라짐 | 복원 시 랭크 수가 바뀌면 재분배 필요 |
| 계층적 체크포인트 | 자주는 로컬 NVMe에, 가끔은 병렬 FS에 | 대부분의 장애는 로컬에서 복구 | 노드가 통째로 죽으면 로컬본도 잃는다 |
| 증분 저장 | 바뀐 부분만 | 쓰기량 감소 | 옵티마이저 상태는 매번 바뀌어 효과 제한적 |
체크포인트를 빨리 쓰는 것만 생각하기 쉽지만, 장애 후 다시 읽어 올리는 시간도 손실이다. 수 TB를 읽어 수천 노드에 뿌리는 데 수십 분이 걸릴 수 있다.
그리고 장애 노드를 교체하고 잡을 다시 띄우는 운영 시간이 그 위에 얹힌다. 실제 Goodput 계산에서는 이 전체 사이클을 봐야 한다 — 15장에서 다시 다룬다.
실습 — KV 캐시 오프로딩의 대가 재기
목표: KV 캐시 오프로딩을 켜고 끄면서 긴 컨텍스트 처리량이 어떻게 변하는지 측정하고, 「HBM이 모자랄 때 아래 계층으로 내려보내는 것」의 실제 비용을 확인한다.
1단계 — 기준 측정
# vLLM 예시 — 오프로딩 없이
vllm serve <model> --max-model-len 8192

# 컨텍스트 길이를 늘려 가며 측정
#   2K / 8K / 32K / 128K (장비가 허용하는 범위에서)
# 기록: TTFT, TPOT, 최대 동시 요청 수, GPU 메모리 사용량
2단계 — 오프로딩 켜고 재측정
KV 캐시를 CPU 메모리로 내려보내는 옵션(엔진과 버전에 따라 이름이 다르다)을 켜고 같은 측정을 반복한다. 옵션 이름과 버전을 보고서에 기록할 것.
3단계 — 기록표
| 컨텍스트 | 오프로딩 끔 — TTFT / TPOT / 동시요청 | 오프로딩 켬 — TTFT / TPOT / 동시요청 |
|---|---|---|
| 2K | ||
| 8K | ||
| 32K | ||
| 128K |
4단계 — 해석
- 오프로딩을 켜면 무엇이 좋아지고 무엇이 나빠지는가? 각각 몇 %인가?
- 컨텍스트가 길어질수록 그 교환비가 유리해지는가, 불리해지는가? 왜인가?
- 오프로딩 없이는 아예 처리 못 하던 컨텍스트 길이가 있는가? 「느리게라도 되는 것」과 「아예 안 되는 것」의 차이를 어떻게 평가하겠는가?
- 2장 메모리 계층 도해로 돌아가, 여러분이 측정한 성능 저하가 계층 간 대역폭 차이로 설명되는지 확인하라.
보너스 — 프리픽스 재사용
같은 시스템 프롬프트를 붙인 요청을 여러 번 보내 프리픽스 캐시가 켜졌을 때와 꺼졌을 때 TTFT가 어떻게 달라지는지 측정하라. 1장에서 계산한 프리필 비용과 비교하면 절감량이 설명되는가?
제출물
측정표 + 4단계 해석 (A4 3장 이내).
- 체크포인트 간격을 정하는 문제는 결국 무엇과 무엇의 균형인가? 어떻게 최적점을 찾겠는가?
- KV 캐시를 네트워크 너머 오브젝트 스토리지까지 내려보내는 것이 말이 되는 경우는 언제인가?
- 우리 학교 규모에서 병렬 파일시스템이 필요한가? 어느 규모부터 필요해지는가?
참고 자료
- NVIDIA GPUDirect Storage 문서
- NVIDIA Dynamo 문서 — NIXL 전송 계층
- vLLM · SGLang 문서 — prefix caching, CPU offloading
- Lustre · VAST · WEKA 기술 백서