AI 팩토리와 LLM 워크로드의 해부
이 과목의 모든 내용은 한 가지 관찰에서 출발한다. 「프리필은 연산이 모자라고, 디코드는 대역폭이 모자란다.」 이 한 줄이 왜 칩이 지금처럼 생겼는지, 왜 랙이 190kW를 먹게 됐는지, 왜 추론 전용 칩이 따로 나오는지를 전부 설명한다.
이 장을 마치면
- AI 팩토리를 「전력을 넣어 토큰을 뽑는 공장」으로 정의하고, 그 관점이 왜 유용한지 설명할 수 있다.
- 사전학습·사후학습·추론의 연산 프로파일이 어떻게 다른지 구분할 수 있다.
- 프리필이 연산 집약, 디코드가 메모리 대역폭 집약인 이유를 연산 강도로 설명할 수 있다.
- 칩 → 노드 → 랙 → 클러스터 → 사이트 간의 다섯 계층과 각 계층의 인터커넥트를 말할 수 있다.
- 토큰 1개를 만드는 데 드는 FLOPs와 메모리 이동량을 손으로 계산하고, 실측과 비교할 수 있다.
AI 팩토리 — 전력을 넣어 토큰을 뽑는다
NVIDIA가 데이터센터를 「AI 팩토리」라고 부르기 시작한 것은 마케팅 수사가 아니라 회계 단위의 변경이다. 전통적인 데이터센터의 산출물은 저장 용량이나 가상머신 시간이었다. AI 팩토리의 산출물은 토큰이고, 투입물은 전력이다.
입력 = 전력(MW) → 설비 = 칩·네트워크·냉각 → 출력 = 토큰(tokens/s)
그러면 모든 설계 결정을 하나의 지표로 환산할 수 있다: tokens / $, tokens / W. 15장에서 이 계산을 직접 한다.
이 관점이 실무에서 유용한 이유는, 서로 비교하기 어려운 선택지를 같은 저울에 올려주기 때문이다. HBM을 더 넣을 것인가 SRAM을 키울 것인가, NVLink를 살 것인가 이더넷으로 갈 것인가, 액체냉각 설비에 투자할 것인가 — 전부 「토큰당 비용이 얼마나 내려가는가」로 답이 나온다.
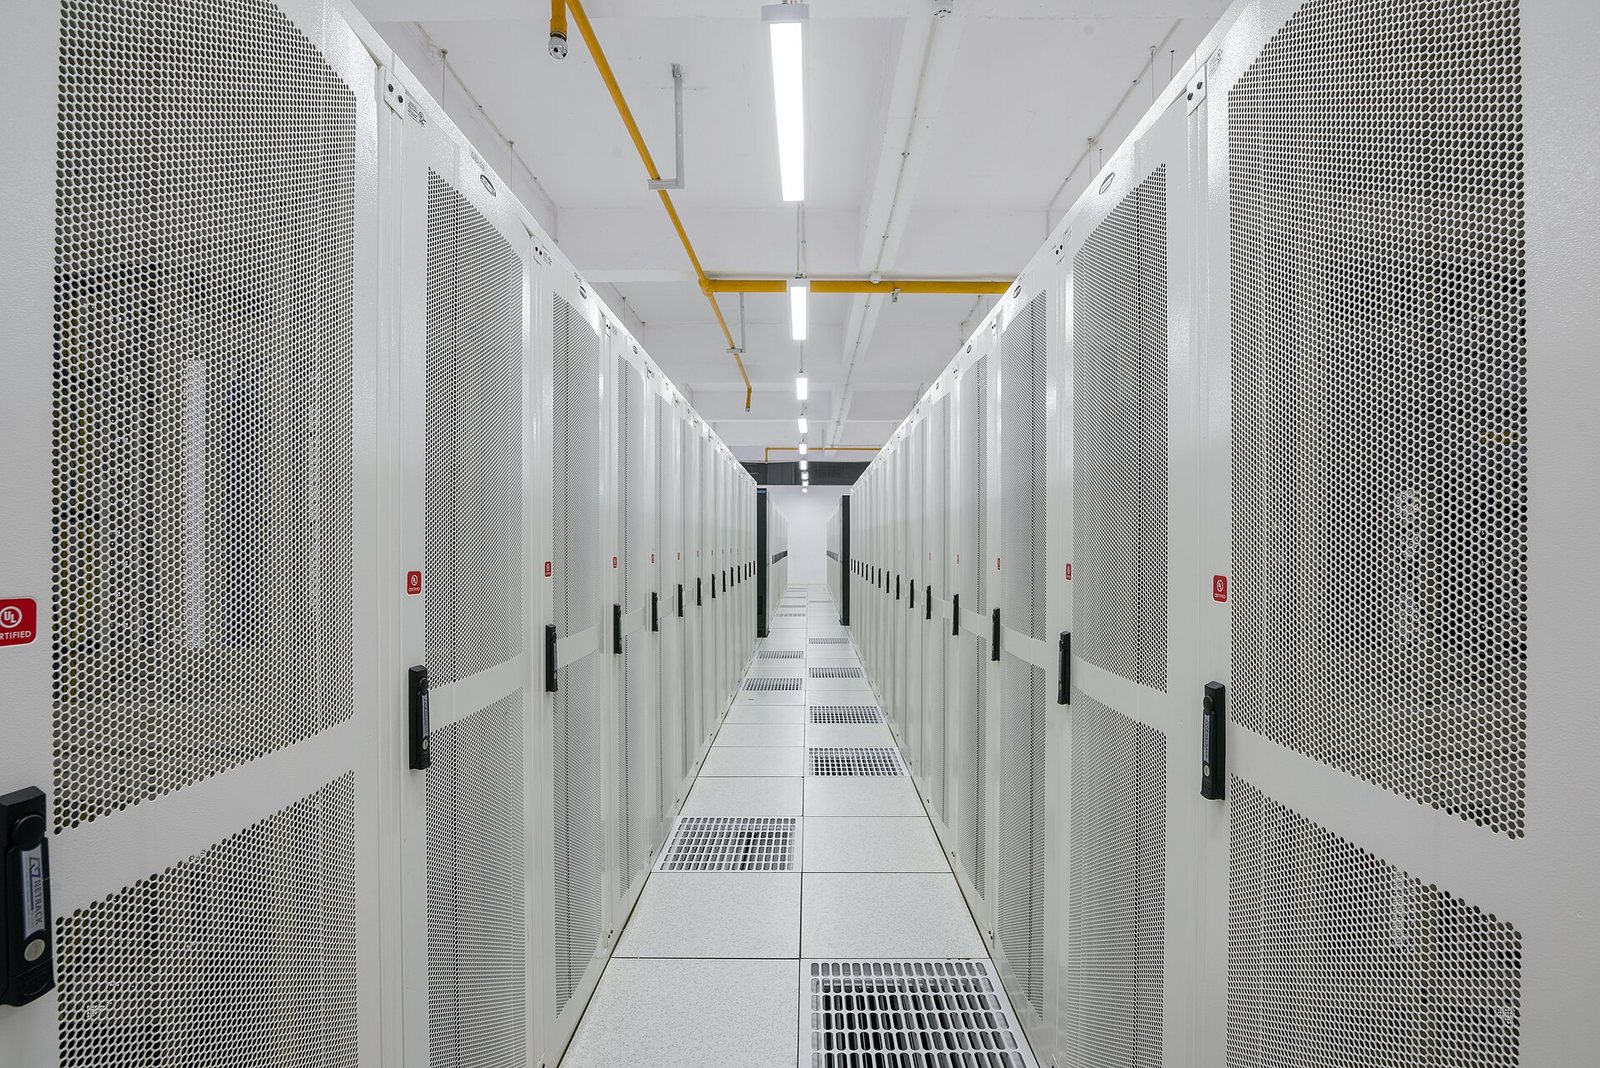
전통적인 데이터센터의 랙 열(row). 랙당 5~15kW 수준이며 공랭으로 충분했다.
출처: PiDatacentersCC BY-SA 4.0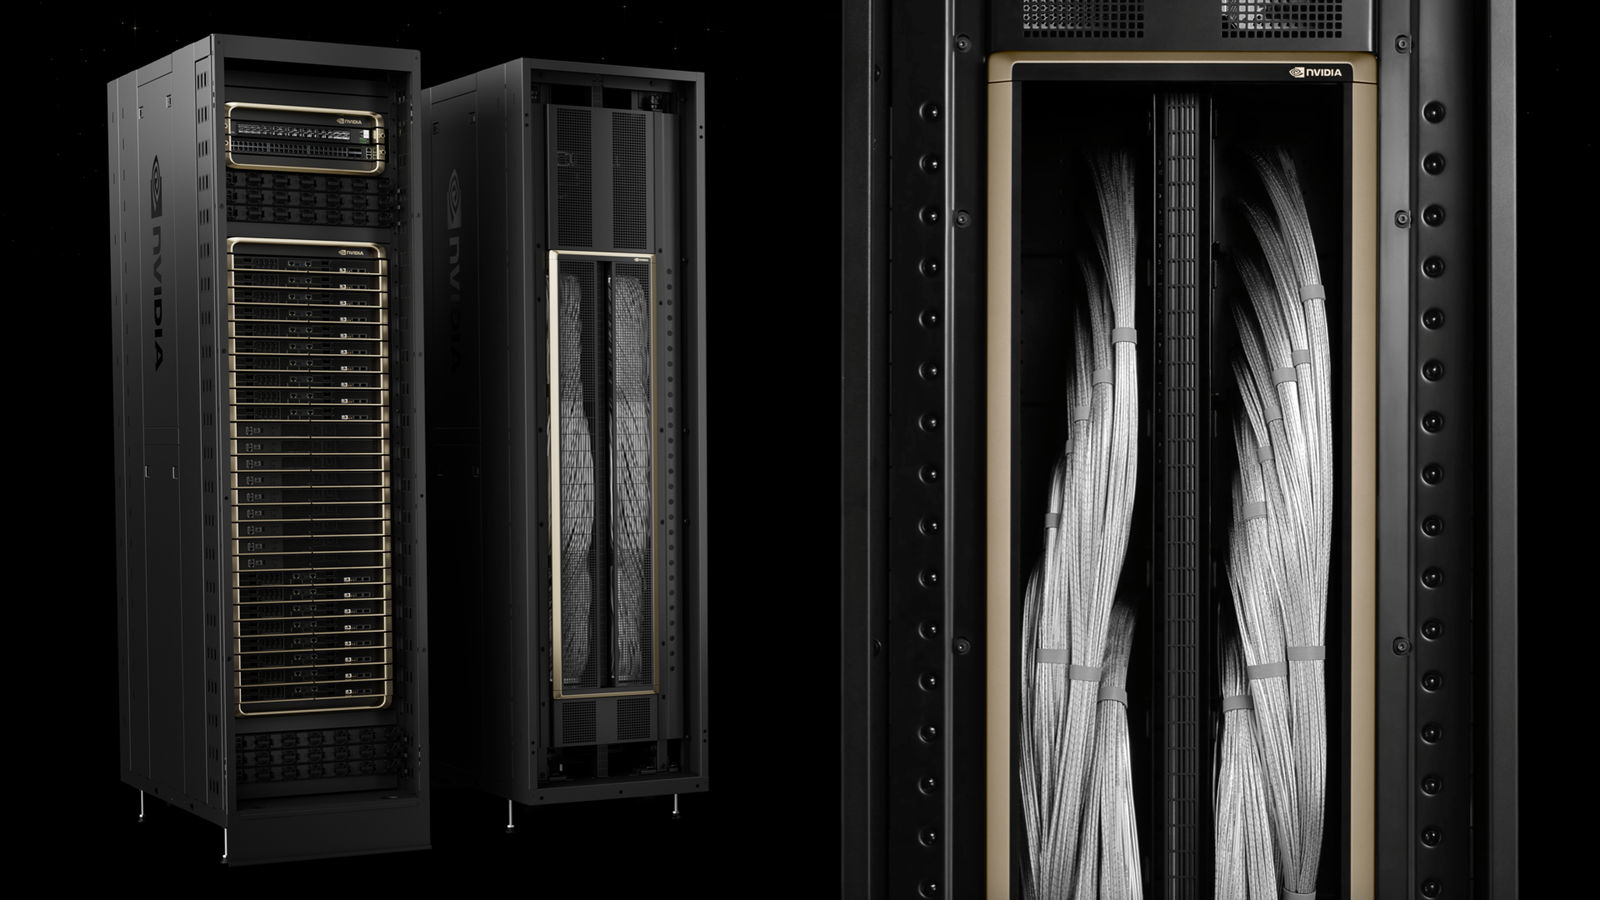
GB200 NVL72 랙. 같은 크기의 캐비닛 하나가 120kW 이상을 소비한다. 오른쪽 사진의 은색 케이블 다발이 72개 GPU를 하나로 묶는 NVLink 스파인이다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)두 사진의 격차가 이 과목의 실질적 주제다. 랙 하나가 먹는 전력이 10배 이상 늘어나면 건물의 배전, 냉각, 바닥 하중, 심지어 부지 선정 기준까지 전부 다시 설계해야 한다. 11장에서 이 연쇄를 추적한다.
계보 — AI 팩토리는 슈퍼컴퓨터에서 무엇을 물려받았나
AI 데이터센터는 갑자기 나타난 것이 아니다. 수천 대의 계산 노드를 빠른 네트워크로 묶고, 전력과 냉각을 통째로 설계하고, 장애를 전제로 운영하는 방식은 과학 계산용 슈퍼컴퓨터가 수십 년 동안 다듬어 온 것이다. 이 과목에서 배울 계층 구조도 상당 부분 거기서 왔다.
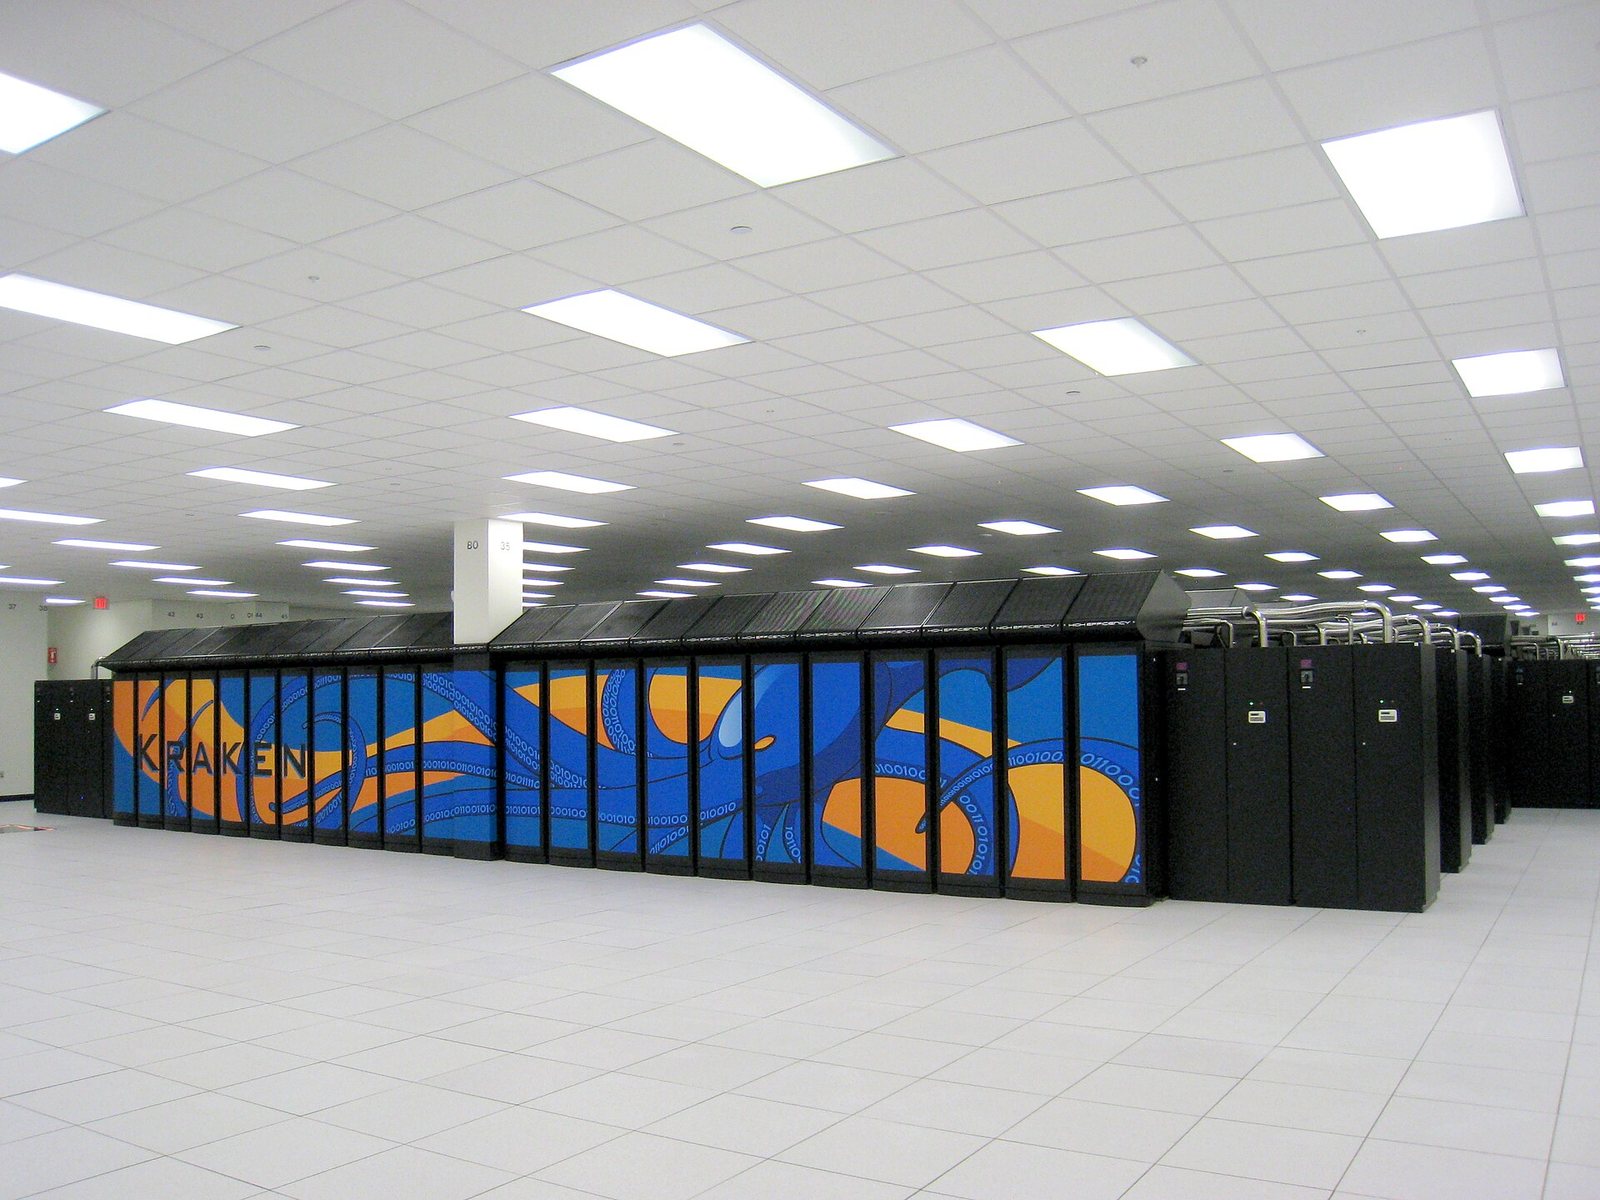
Cray XT5 기반 Kraken — 계산 캐비닛을 열 지어 세우는 방식의 원형
이 시기 시스템의 특징은 노드를 전용 인터커넥트로 묶어 하나의 기계처럼 쓰는 것이었다. 8장에서 볼 NVLink·NVSwitch가 하는 일과 목적이 같다. 다른 점은 그때는 CPU를, 지금은 GPU를 묶는다는 것뿐이다.
출처: DaderotPublic domain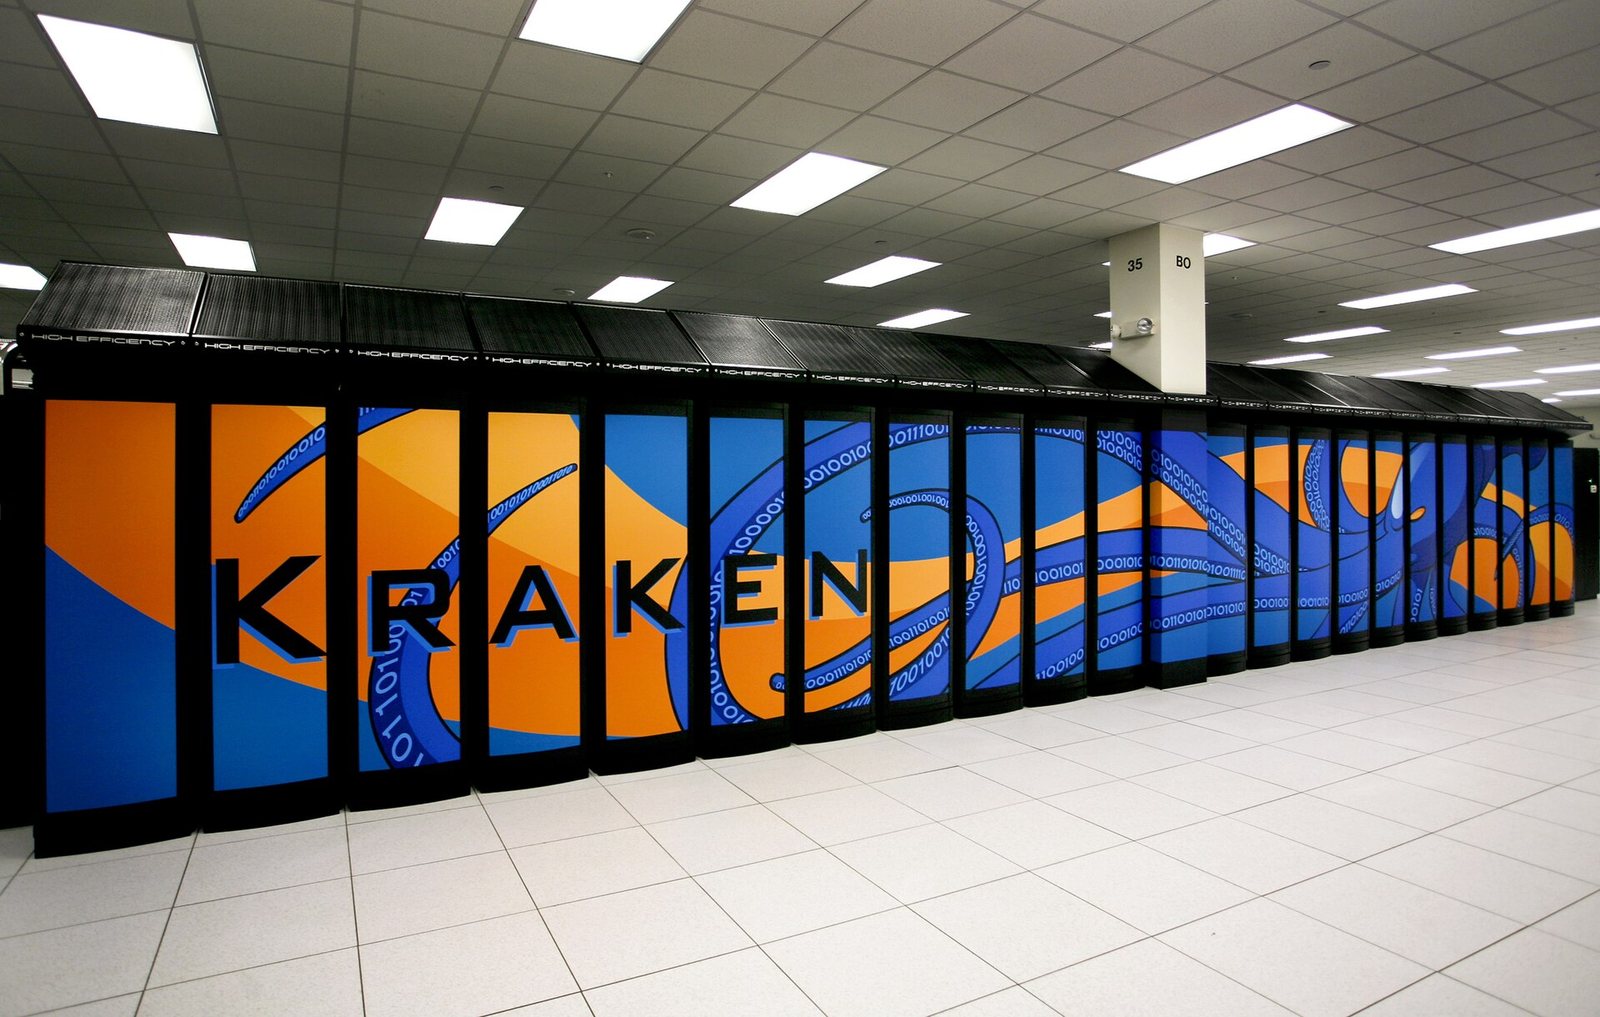
같은 Kraken 을 가까이서 — 캐비닛 문에 그려진 「KRAKEN」
주황·파랑 그림이 캐비닛 여러 대에 걸쳐 이어지고 그 위에 기계 이름이 적혀 있다. 바닥은 이중바닥 타일이고 그 앞뒤로 넓은 빈 공간이 남아 있다. 이 여백이 정비 통로다 — 사람이 캐비닛 문을 열고 들어가 부품을 뽑을 수 있어야 한다. 9장에서 「링크 2,048개」를 계산할 때, 그것이 결국 사람이 이 통로에 서서 하나씩 꽂아야 하는 작업이라는 점을 기억해 둘 만하다. 11장의 고밀도 랙은 이만한 여백을 더는 허용하지 않는다.
출처: Oak Ridge National LaboratoryCC BY 2.0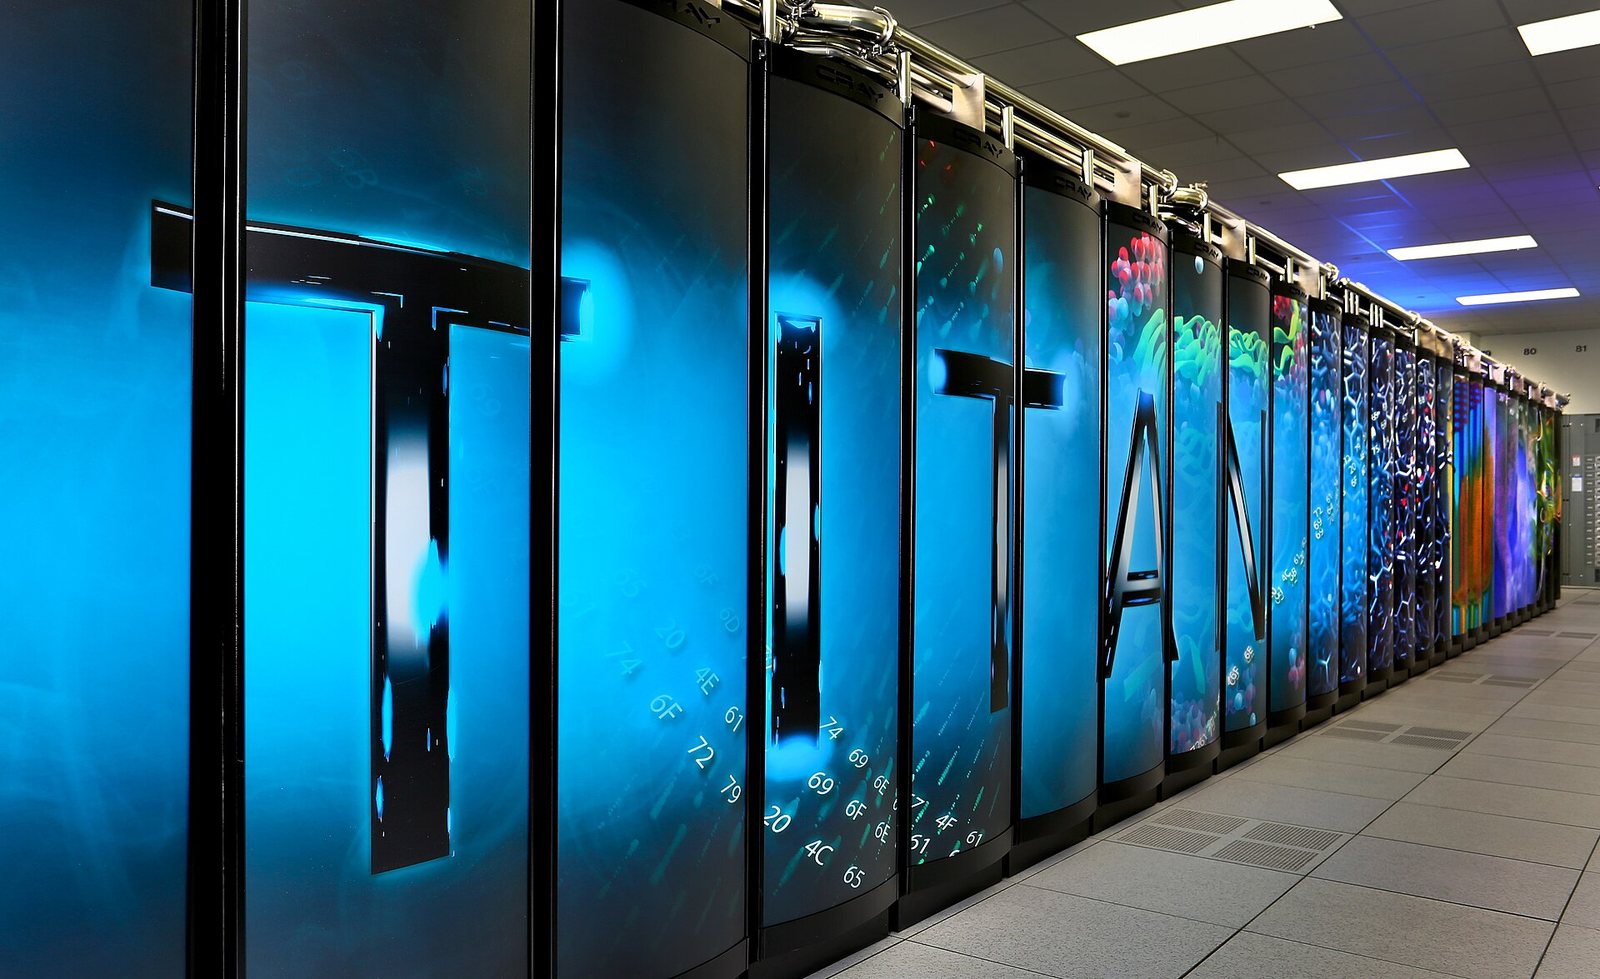
Titan 실물 — 캐비닛 문에 「TITAN」이 도색돼 있다
오크리지 국립연구소의 Titan 이다. 검은 캐비닛이 한 줄로 늘어서 있고 앞면에 파란 조명 무늬와 함께 T-I-T-A-N 글자가 한 캐비닛에 한 자씩 도색돼 있다. 안쪽으로 갈수록 무늬가 우주·분자 이미지로 바뀌고, 바닥은 이중바닥 타일이다. Titan 은 CPU 노드에 GPU 를 가속기로 붙인 구조였다 — 3장에서 볼 「PCIe 너머의 손님」 시절의 GPU 이며, 지금의 슈퍼칩 구조와 비교하면 가속기의 지위가 어떻게 바뀌었는지가 보인다.
출처: Oak Ridge National LaboratoryCC BY 2.0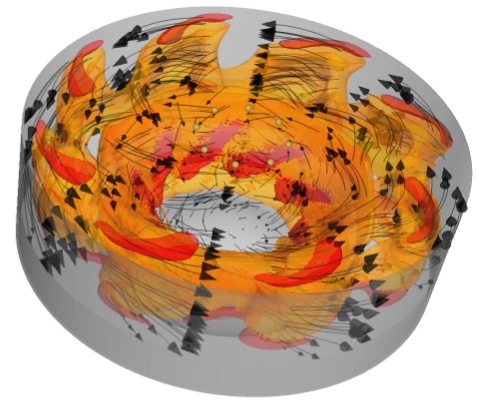
Titan 에서 돌린 디젤 연소 시뮬레이션의 결과 화면
원통(엔진 실린더)을 비스듬히 내려다본 그림이다. 주황·빨강 덩어리가 등가면(온도나 화학종 농도가 같은 면)이고, 검은 화살촉이 속도 벡터, 회색 반투명 껍질이 실린더 벽이다. 격자 위에서 물리 방정식을 반복해 푸는 일이라 이런 계산은 연산 집약이며, 아래 루프라인으로 보면 오른쪽(연산 한계)에 산다. LLM 학습도 여기에 가깝다 — 디코드만이 예외적으로 왼쪽 끝에 있다.
출처: OLCFCC BY 2.0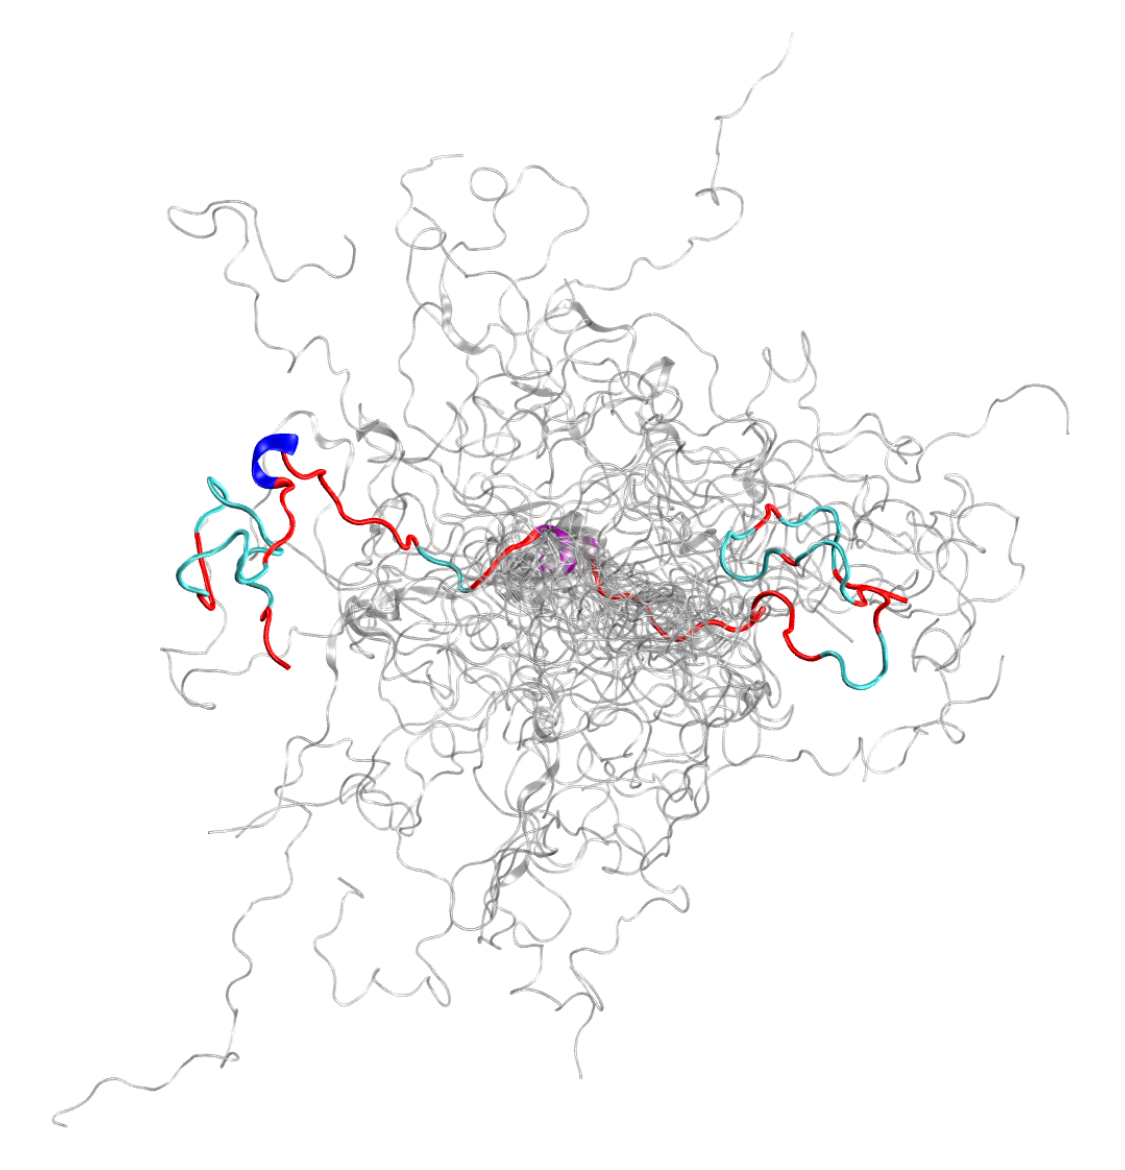
같은 기계에서 나온 다른 결과 — 단백질 하나의 분자동역학 궤적
기계 사진이 아니라 계산 결과다. 회색 실뭉치처럼 보이는 것은 c-Src 카이네이스라는 효소의 골격이 시간에 따라 움직인 자취를 겹쳐 그린 것이고, 빨강·청록·파랑으로 강조된 가닥이 관심 부위다. Titan 의 계산과 중성자 산란 실험 데이터를 맞춰 본 연구의 그림이다.
이 그림을 나란히 둔 이유가 있다. 「슈퍼컴퓨터 사진」이라고 검색해서 나오는 것의 상당수가 이런 결과 이미지다. 기계를 찍은 사진과 기계가 만든 그림은 다른 것이고, 자료를 인용할 때 그 둘을 구분하지 않으면 설명이 사진과 어긋난다. 16장 첫머리의 「이 장의 사진을 읽는 법」과 같은 주의다.
출처: OLCFCC BY 2.0규모의 다양성 — 모두가 세계 1등을 짓는 것은 아니다
뉴스에 나오는 것은 최상위 시스템이지만, 실제로 세계에서 돌아가는 계산 시설의 대부분은 중소 규모다. 우리 학교가 지을 만한 것도 이쪽에 가깝다. 규모가 다르면 설계 원칙도 달라진다 — 17장 설계 프로젝트에서 이 점이 평가 대상이 된다.
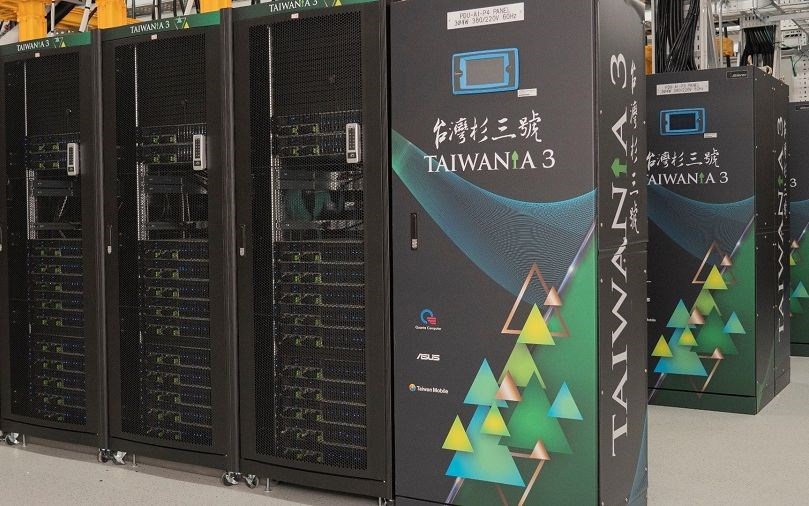
대만 Taiwania 3 — 국가 단위의 중규모 시스템
국가나 지역이 운영하는 이 정도 규모가 7장에서 볼 국가AI컴퓨팅센터의 참고 사례가 된다. 최상위 시스템처럼 극단적인 설계를 하지 않는 대신, 여러 사용자가 나눠 쓰는 운영과 조달·유지보수의 현실성이 설계 기준이 된다.
출처: Focus Taiwan newsletterOGDL-Taiwan-1.0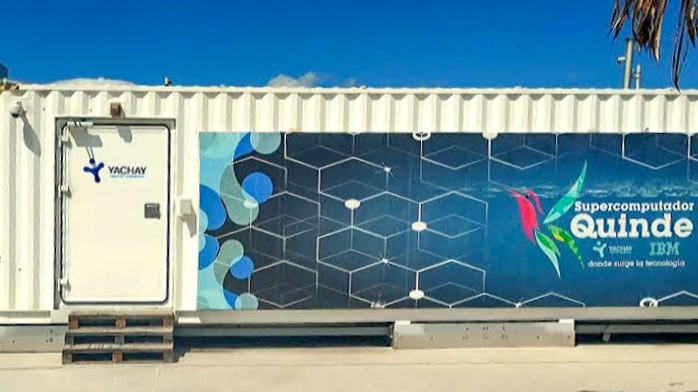
에콰도르 Quinde I — 기계가 아니라 그것이 든 건물의 바깥
컨테이너형 시설의 외벽 사진이다. 파란 육각 무늬 벽에 「Supercomputador Quinde I」와 IBM · YACHAY 로고가 그려져 있고, 왼쪽에 출입문이, 아래쪽에 설비 배관이 보인다. 이 정도 규모의 시설은 건물을 새로 짓지 않고 컨테이너에 담는 경우가 많다 — 전력·냉각·네트워크의 원리는 같지만 규모가 작으면 분해의 이득보다 오버헤드가 크기 때문이다. 4장에서 볼 「랙을 5종류로 나누는」 설계는 이 규모에서는 오히려 손해다.
출처: JeffCF03CC BY-SA 4.0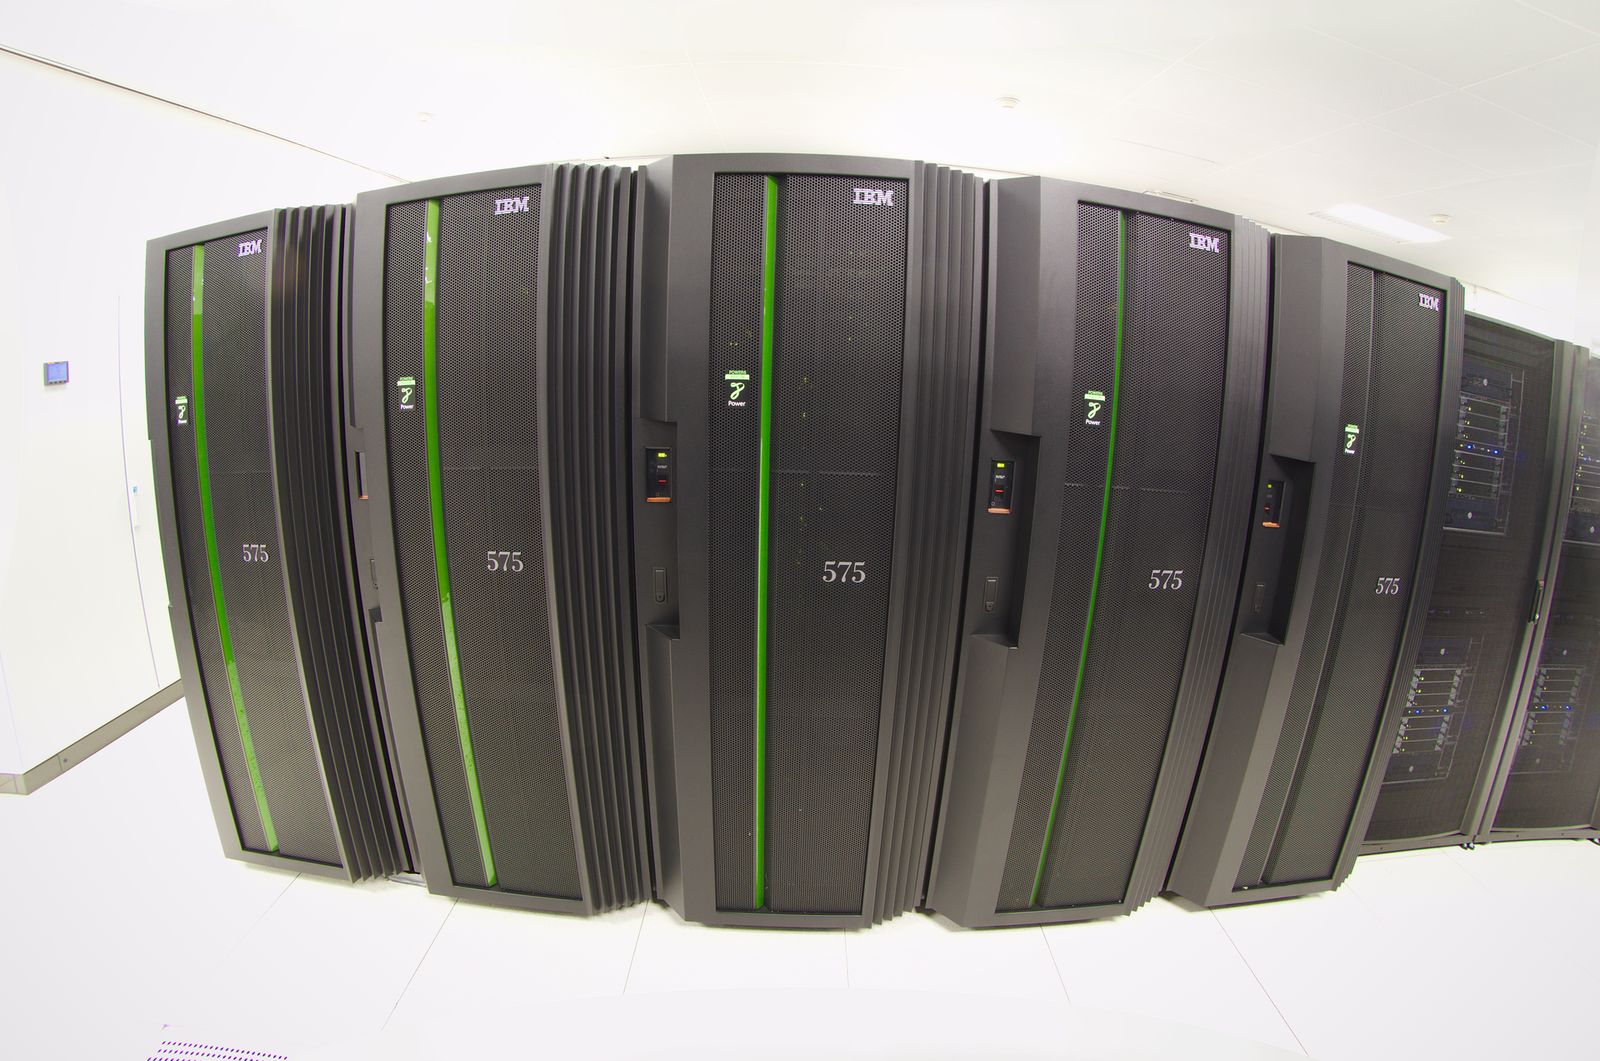
네덜란드 Huygens — 이전 세대의 국가 시스템
캐비닛 전면의 디자인과 배치가 시대를 보여준다. 당시에는 랙당 수 kW였으므로 공랭으로 충분했고, 통로도 넓게 잡을 수 있었다. 11장에서 볼 130kW·210kW 랙은 이 사진의 여유를 더는 허용하지 않는다.
출처: Dennis van ZuijlekomCC BY-SA 2.0그리고 물려받지 못한 것
계보가 있다고 해서 그대로인 것은 아니다. AI 팩토리가 슈퍼컴퓨터와 결정적으로 다른 점이 셋 있다.
| 전통적 슈퍼컴퓨터 | AI 팩토리 | |
|---|---|---|
| 주 워크로드 | 배치 잡 — 제출하고 기다린다 | 추론 서비스 — 사람이 실시간으로 기다린다 |
| 정밀도 | FP64가 기본 (과학 계산의 요구) | FP8·FP4 — 정확도를 조금 내주고 속도를 산다 |
| 성공 지표 | 실행 시간 · FLOPS | tokens/$ · tokens/W — 경제성이 직접 지표 |
| 랙 전력 | 수~수십 kW | 100~200 kW 이상 |
| 운영 주체 | 국가·연구기관 중심 | 민간 사업자가 압도적 다수 |
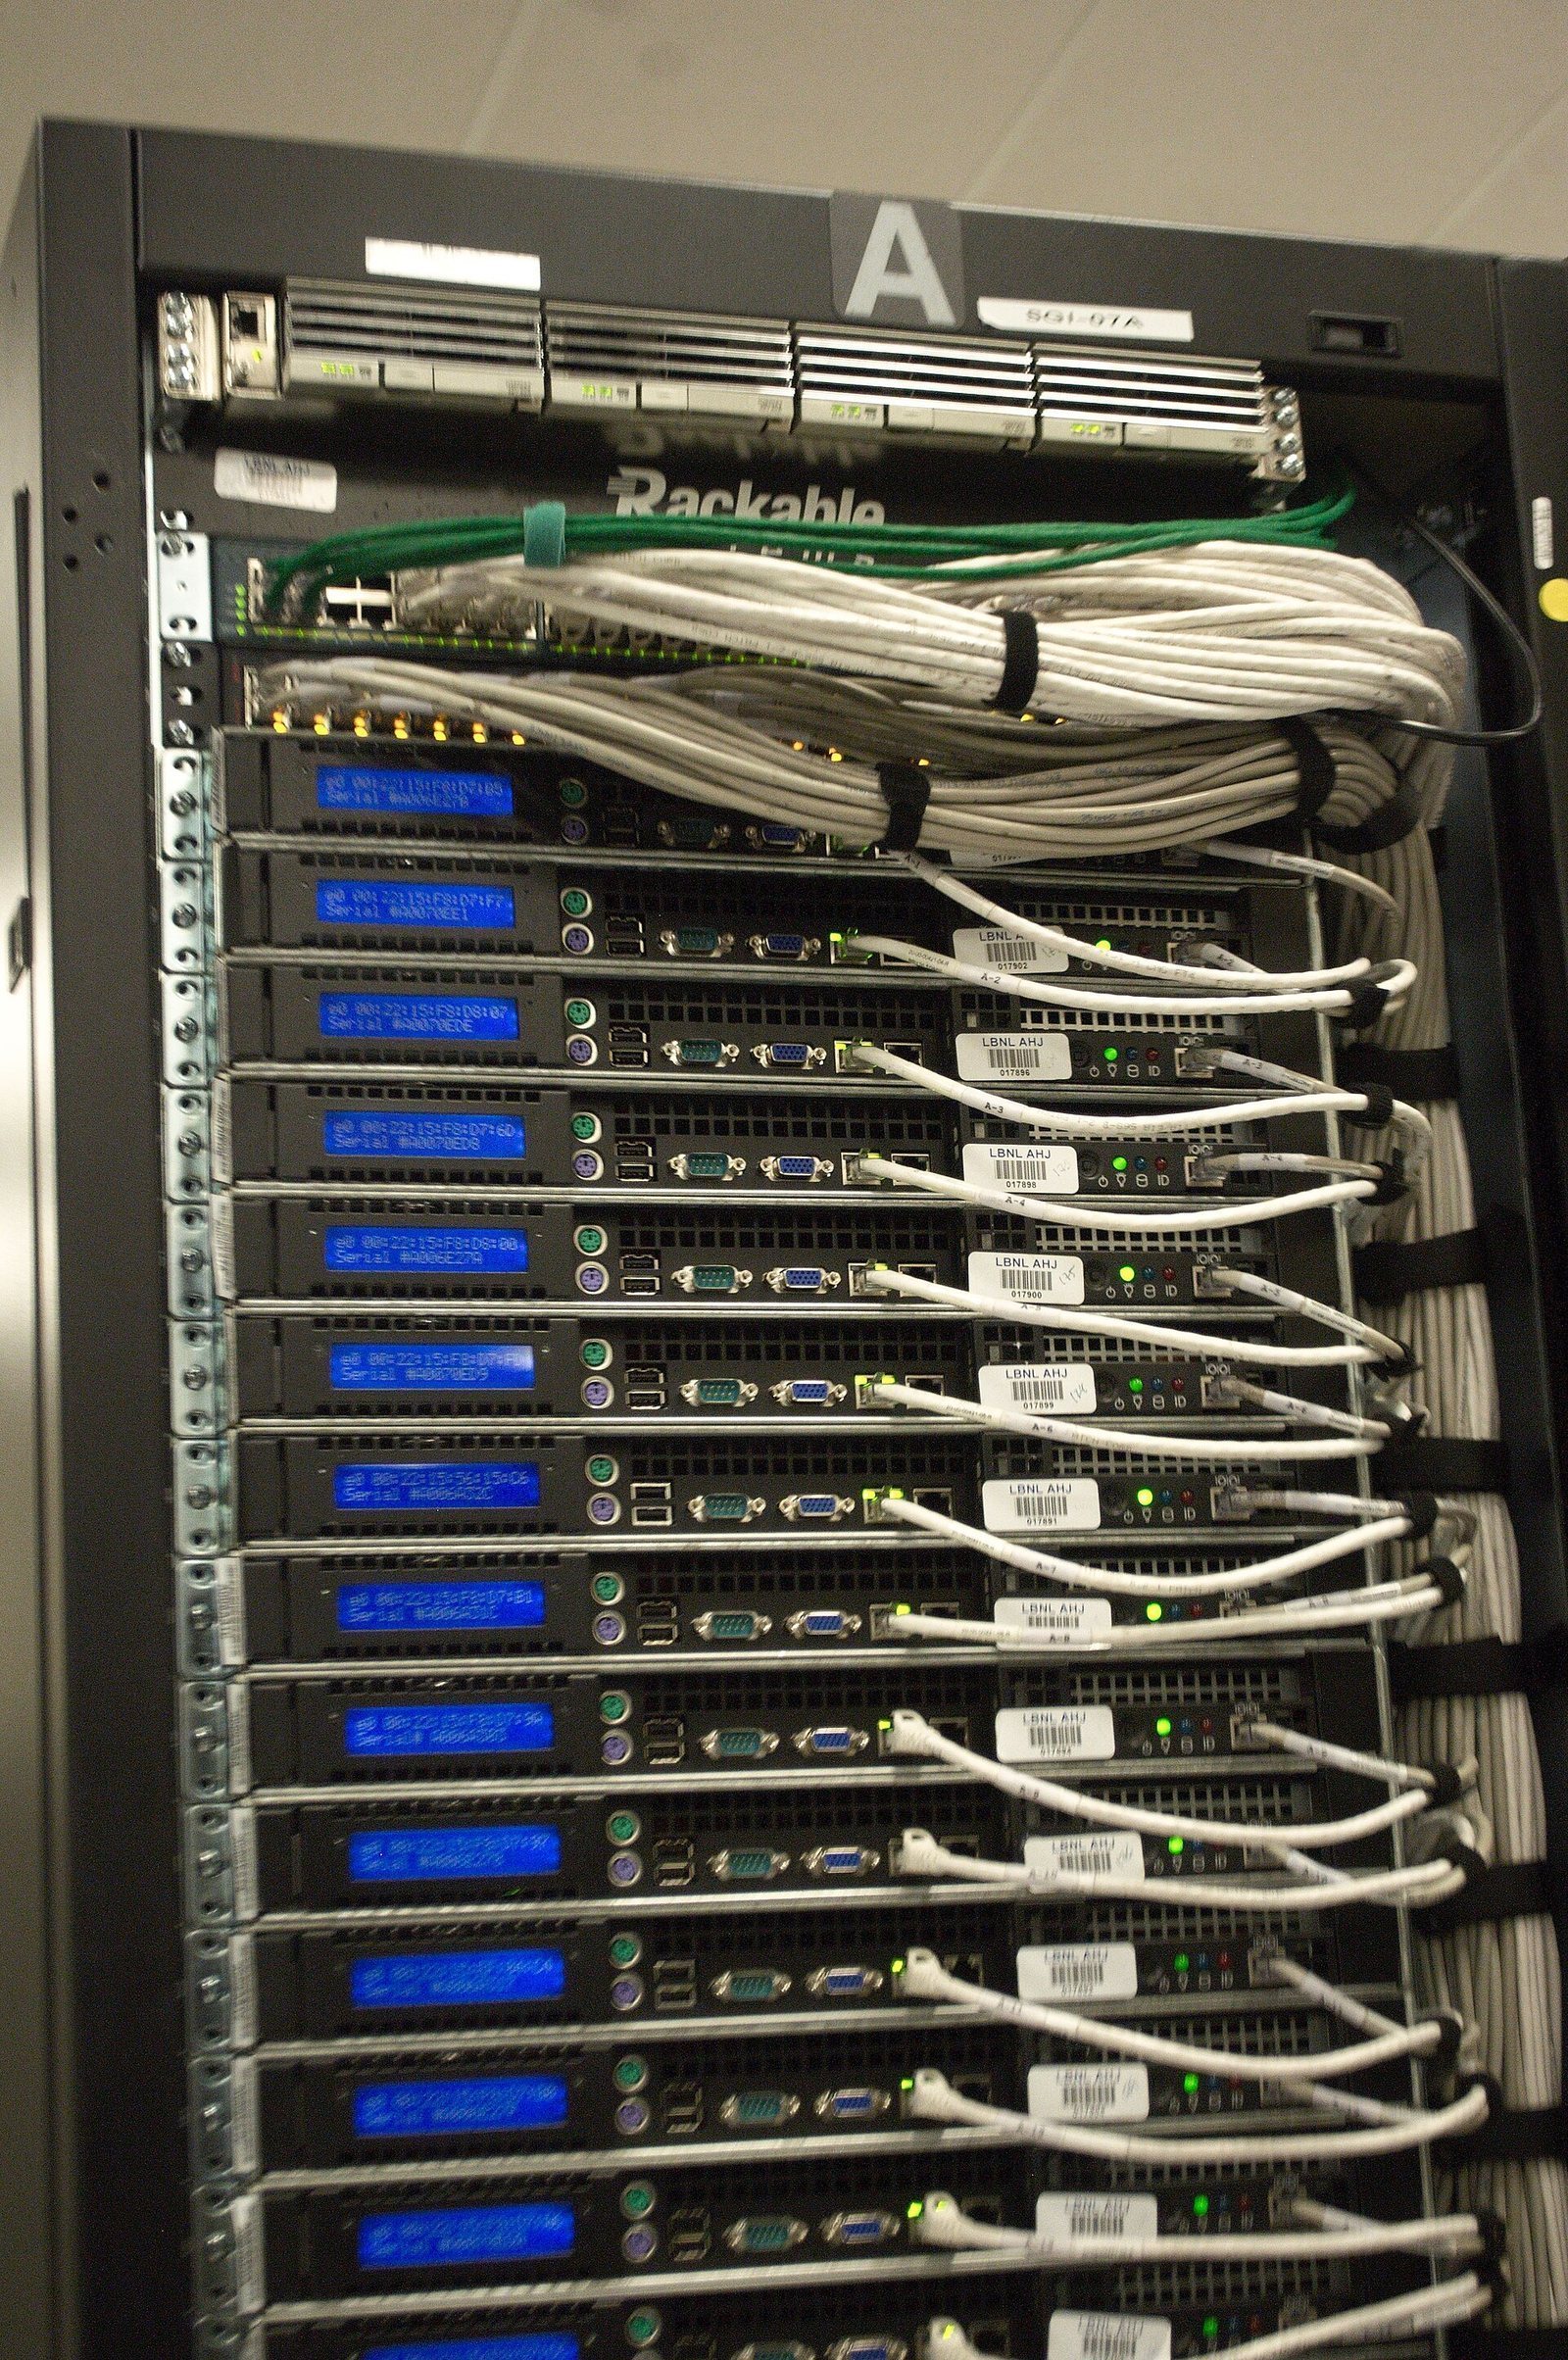
연구용 시설의 랙 뒷면 — 배선의 현실
설계도에서는 깔끔한 fat-tree지만 현실은 이렇다. 케이블 하나가 잘못 꽂히면 그 노드가 통째로 성능이 떨어지고, 수천 개 중 어느 것인지 찾는 데 며칠이 걸리기도 한다. 9장에서 rail-optimized 배선 규칙이 까다롭다고 할 때, 그 대가가 바로 이 그림이다.
출처: Derrick Coetzee from Berkeley, CA, USACC0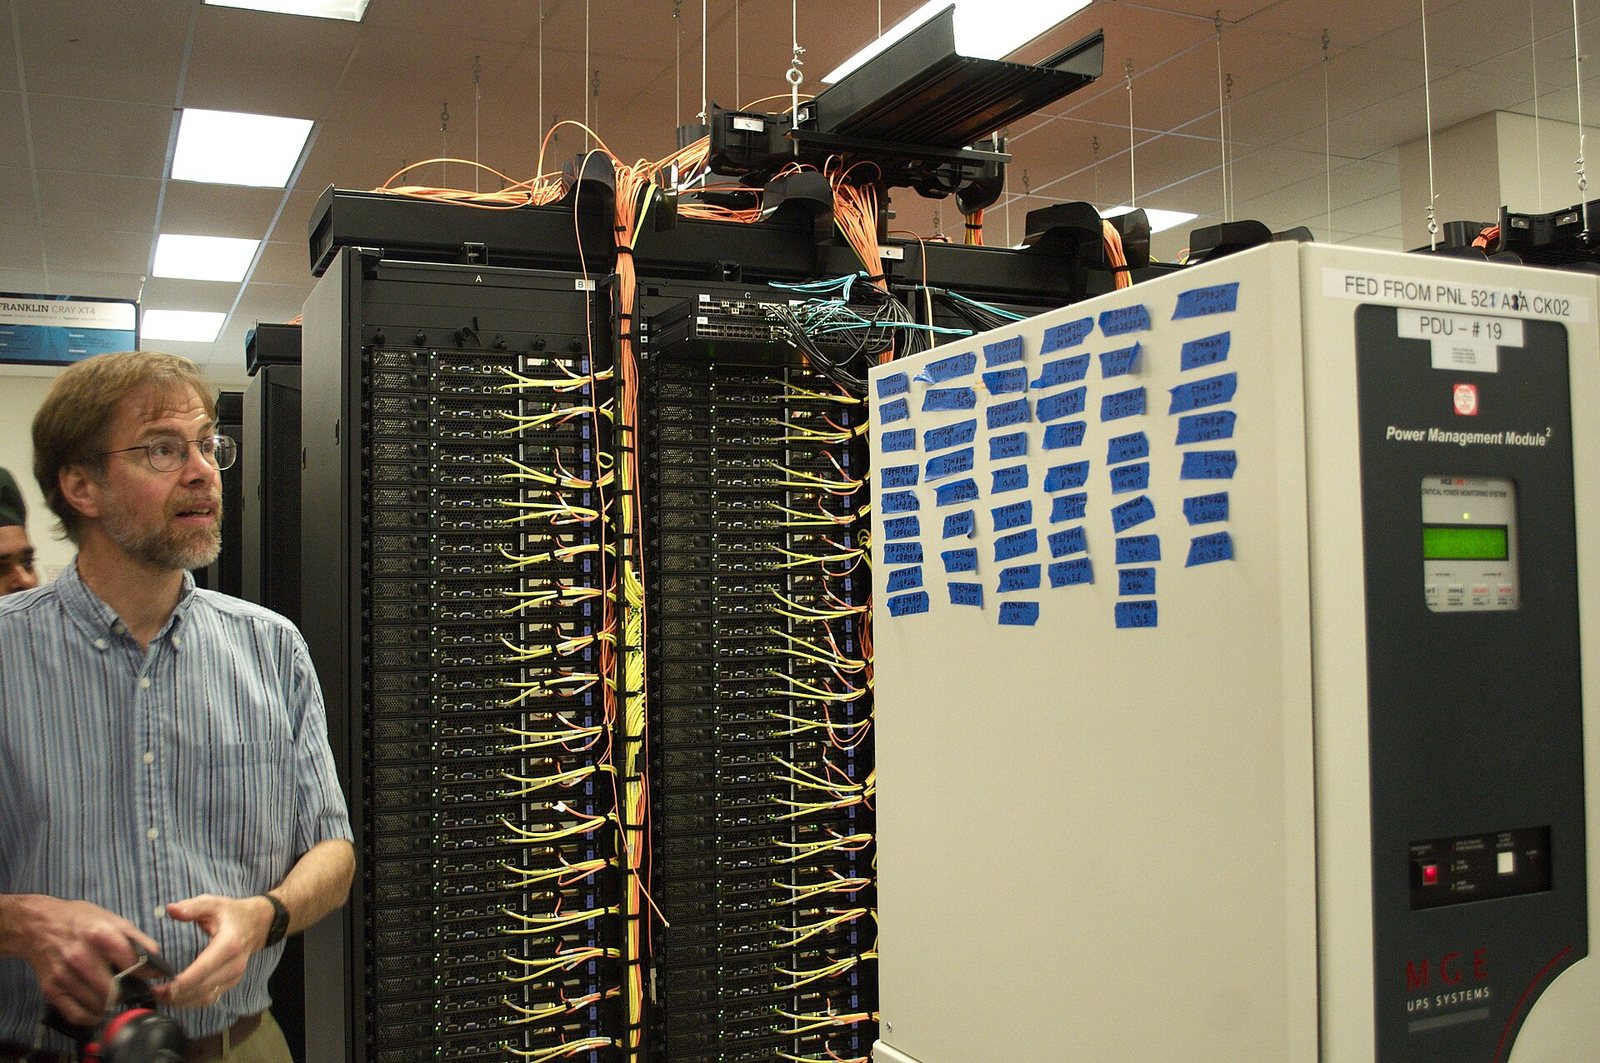
전력 관리 모듈이 연산 랙 옆에 붙어 있다 — 오른쪽 흰 캐비닛
사람이 서 있는 곳 오른쪽의 흰 캐비닛이 UPS 전력 관리 모듈이고, 그 왼쪽이 노란 케이블 다발이 지나는 연산 랙이다. 캐비닛 위쪽에 「FED FROM PNL …」 라벨이 붙어 어느 배전반에서 받는지 적혀 있고, 파란 라벨들이 회로를 하나씩 표시한다. 전력 설비가 연산 랙 옆에서 차지하는 자리를 눈으로 재 보자. 11장에서 랙이 200 kW 를 넘어가면 이 부분이 연산 랙만큼 커지고, 결국 800 VDC 배전과 사이드카 랙이라는 형태로 재설계된다.
출처: D CoetzeeCC0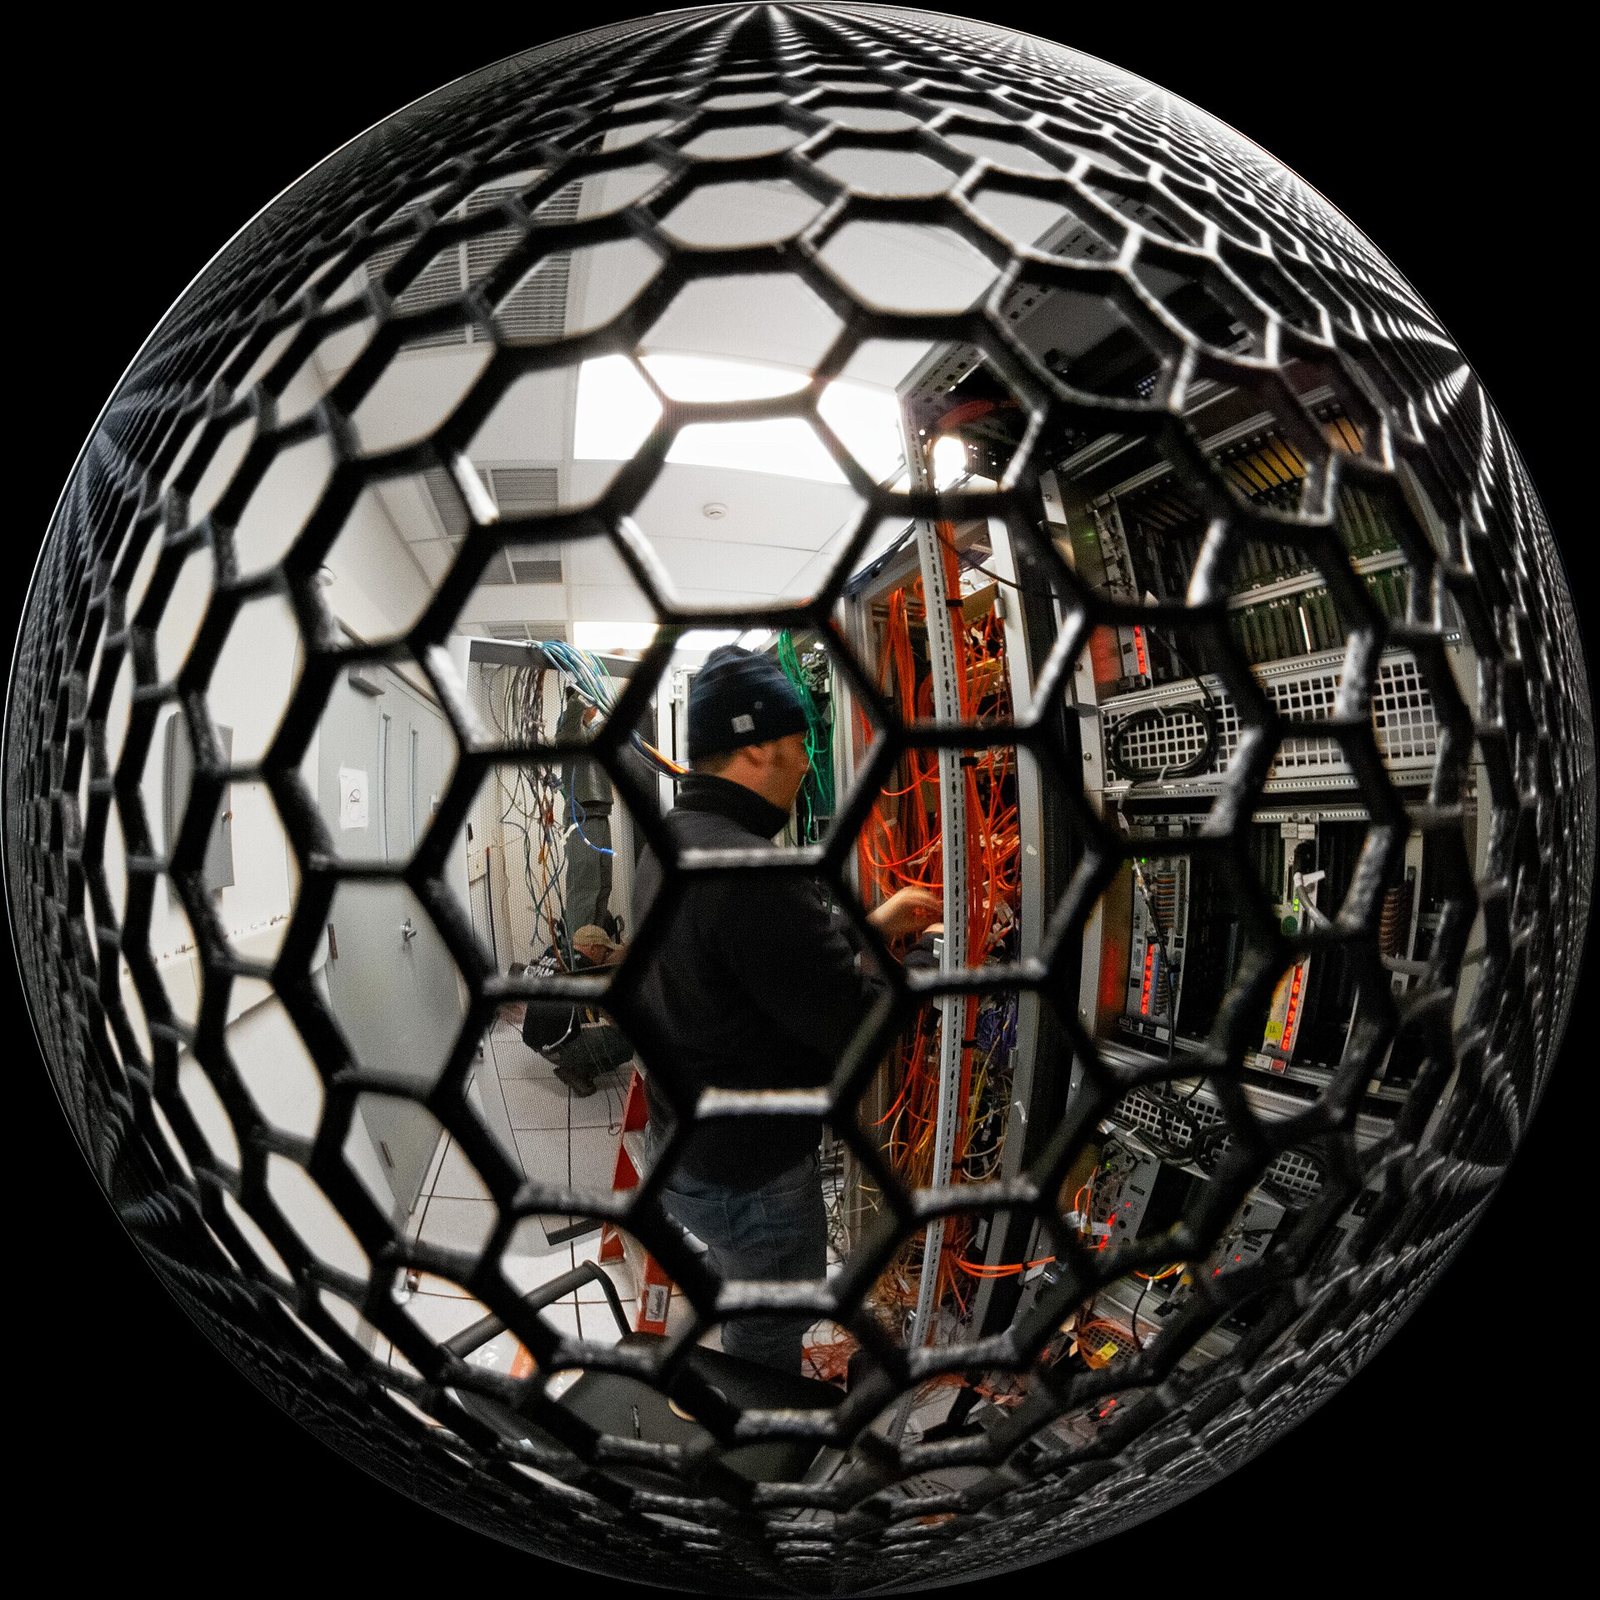
어안 렌즈로 본 데이터센터 통로 — 공랭 시대의 공간 배치
찬 공기 통로와 더운 공기 통로를 나누고(hot/cold aisle), 그 사이에 랙을 세운다. 이 배치는 공기로 열을 나른다는 전제 위에 서 있다. 11장에서 액체냉각으로 넘어가면 통로의 의미가 달라지고, 대신 배관과 CDU가 공간을 차지하게 된다.
출처: International Gemini Observatory/NOIRLab/NSF/AURA/Manuel ParedesCC BY 4.0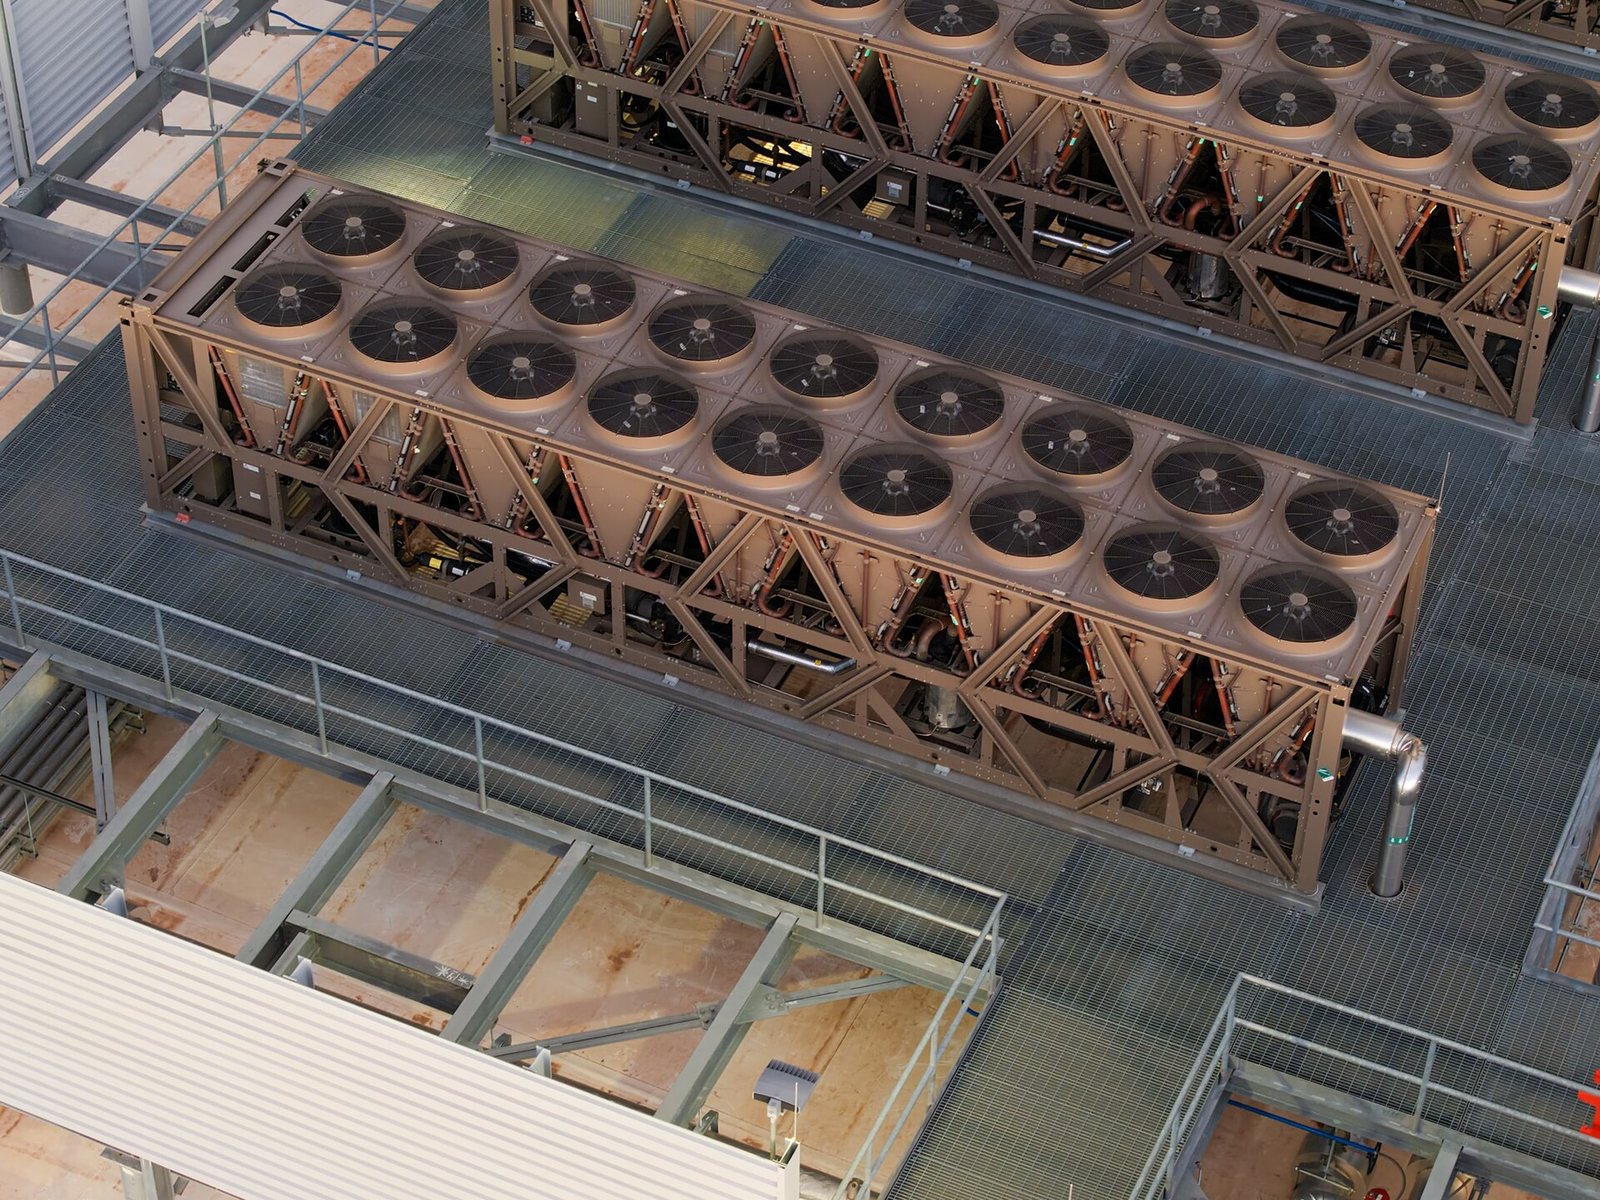
냉각탑 — 열이 최종적으로 버려지는 곳
데이터센터가 만든 열은 결국 대기나 물로 나간다. 냉각탑은 물을 증발시켜 열을 버리므로 물을 소비한다. GW 규모 시설에서는 이 물 소비량이 부지 선정의 제약이 되며, 7장에서 국가AI컴퓨팅센터의 입지를 논할 때 다시 나온다.
출처: Rsparks3CC0LLM 워크로드의 세 가지 얼굴
「LLM을 돌린다」는 말 안에는 하드웨어 요구가 전혀 다른 세 가지 작업이 섞여 있다. 이것을 구분하지 못하면 제품 비교표를 읽을 수 없다.
| 단계 | 하는 일 | 지배적 자원 | 실패하면 생기는 일 | 장비 성격 |
|---|---|---|---|---|
| 사전학습 pre-training | 대규모 코퍼스로 기본 능력 습득 | 연산량 · 노드 간 대역폭 | 몇 주짜리 잡이 며칠 더 걸린다 | 수천~수만 GPU 동기 클러스터 |
| 사후학습 post-training / RL | 정렬, 추론 능력 강화, RLHF·RLVR | 학습과 추론이 한 잡 안에 섞임 | 샘플 생성 대기로 GPU가 논다 | 학습 클러스터 + 추론 롤아웃 풀 |
| 추론 inference | 실제 서비스 응답 생성 | 메모리 대역폭 · 지연 | 사용자가 기다린다, 동시접속이 안 늘어난다 | 다수의 소규모 노드 + 라우팅 |
최근 몇 년의 가장 큰 변화는 사후학습과 추론의 경계가 흐려진 것이다. 강화학습 기반 사후학습은 모델이 스스로 답을 생성(추론)하고 그 결과로 다시 학습하기 때문에, 한 클러스터 안에서 학습 워크로드와 추론 워크로드가 동시에 돌아간다. test-time scaling(추론 시점에 더 오래 생각하기)과 에이전틱 워크로드도 같은 방향으로 압력을 준다 — 추론이 전체 연산량에서 차지하는 비중이 계속 커진다.
추론 비중이 커진다는 것은 곧 디코드 비중이 커진다는 뜻이고, 디코드는 아래에서 보듯 메모리 대역폭에 묶여 있다. 2026년에 Groq·Cerebras·d-Matrix 같은 SRAM 기반 추론 전용 하드웨어가 따로 시장을 만든 이유가 여기에 있다. 7장에서 다룬다.
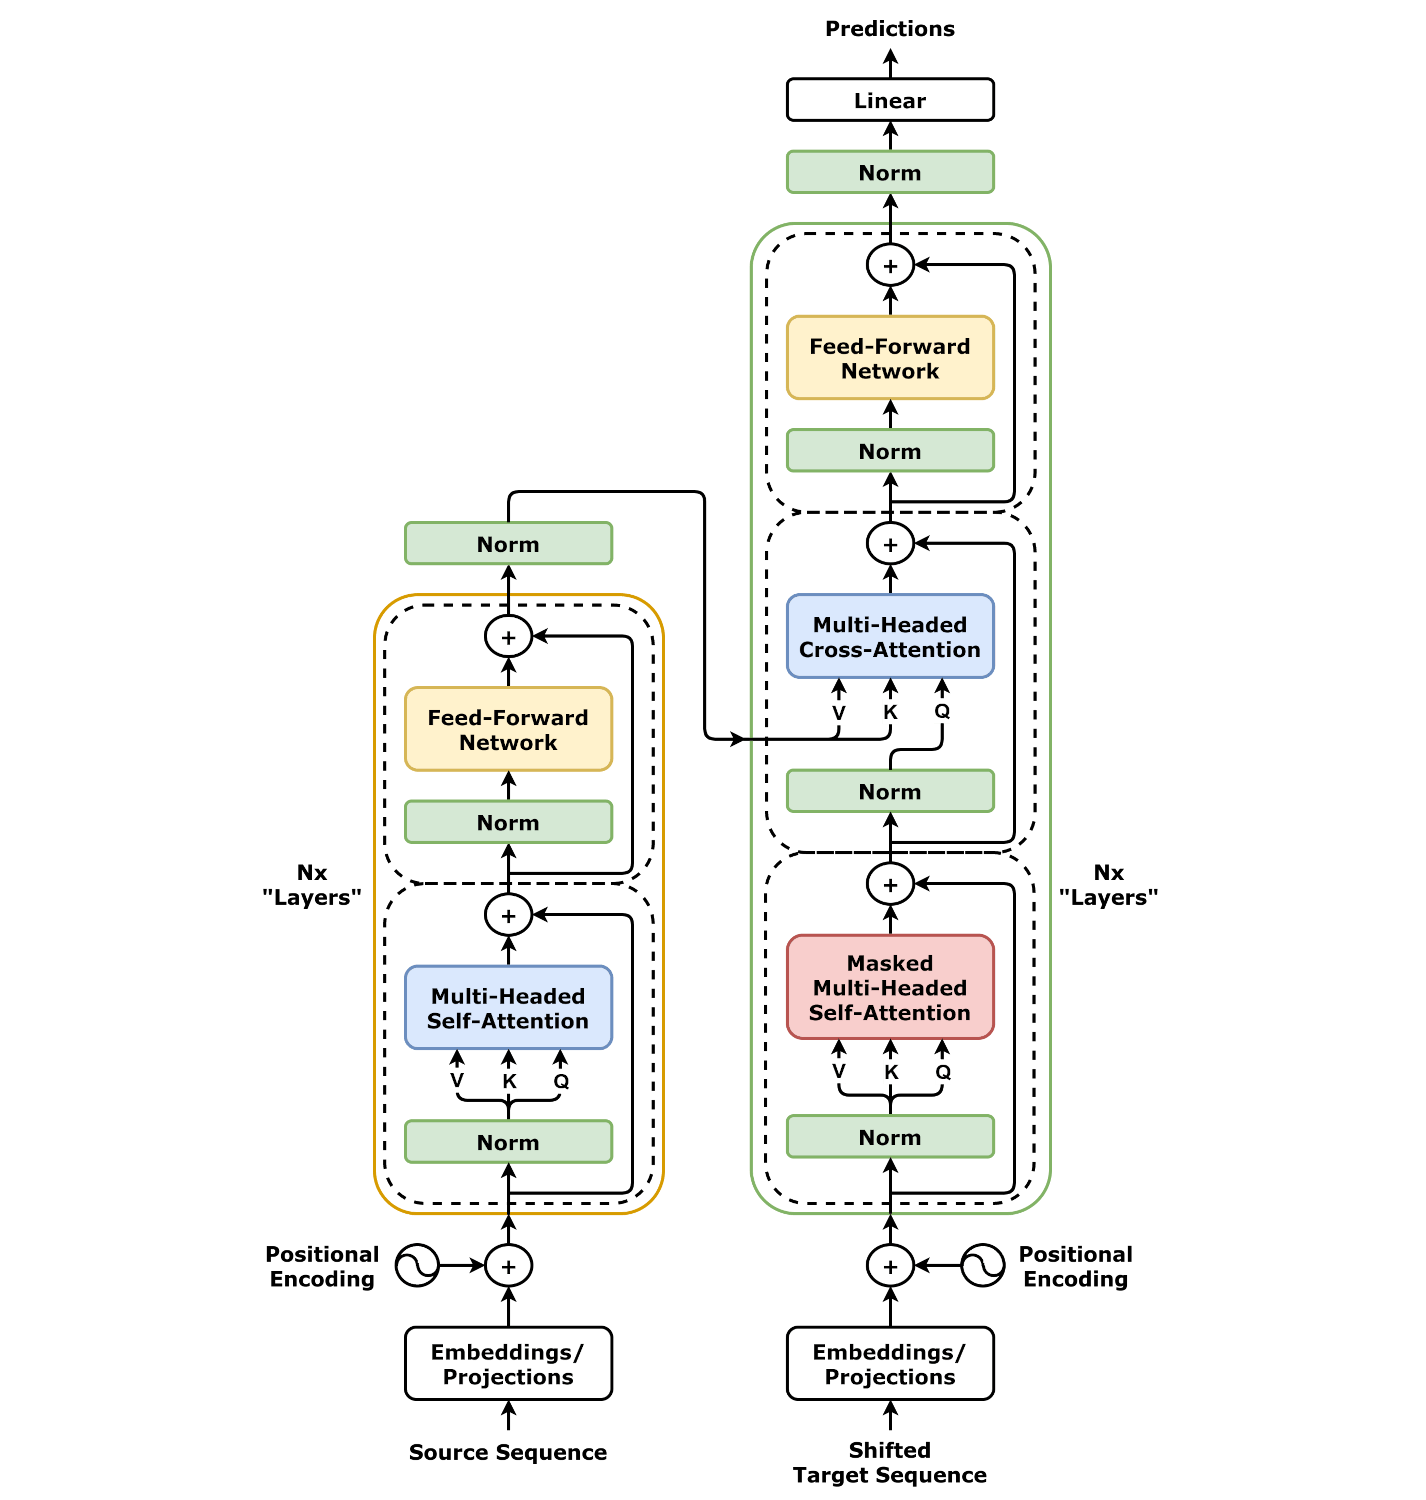
트랜스포머 전체 구조
이 과목에서는 구조 자체보다 각 블록이 메모리에서 무엇을 얼마나 읽어오는가에 관심이 있다. 그림에서 반복되는 블록이 곧 「레이어」이며, 14장의 KV 캐시 계산에서 이 레이어 수가 그대로 곱해진다.
출처: dvgodoyCC BY 4.0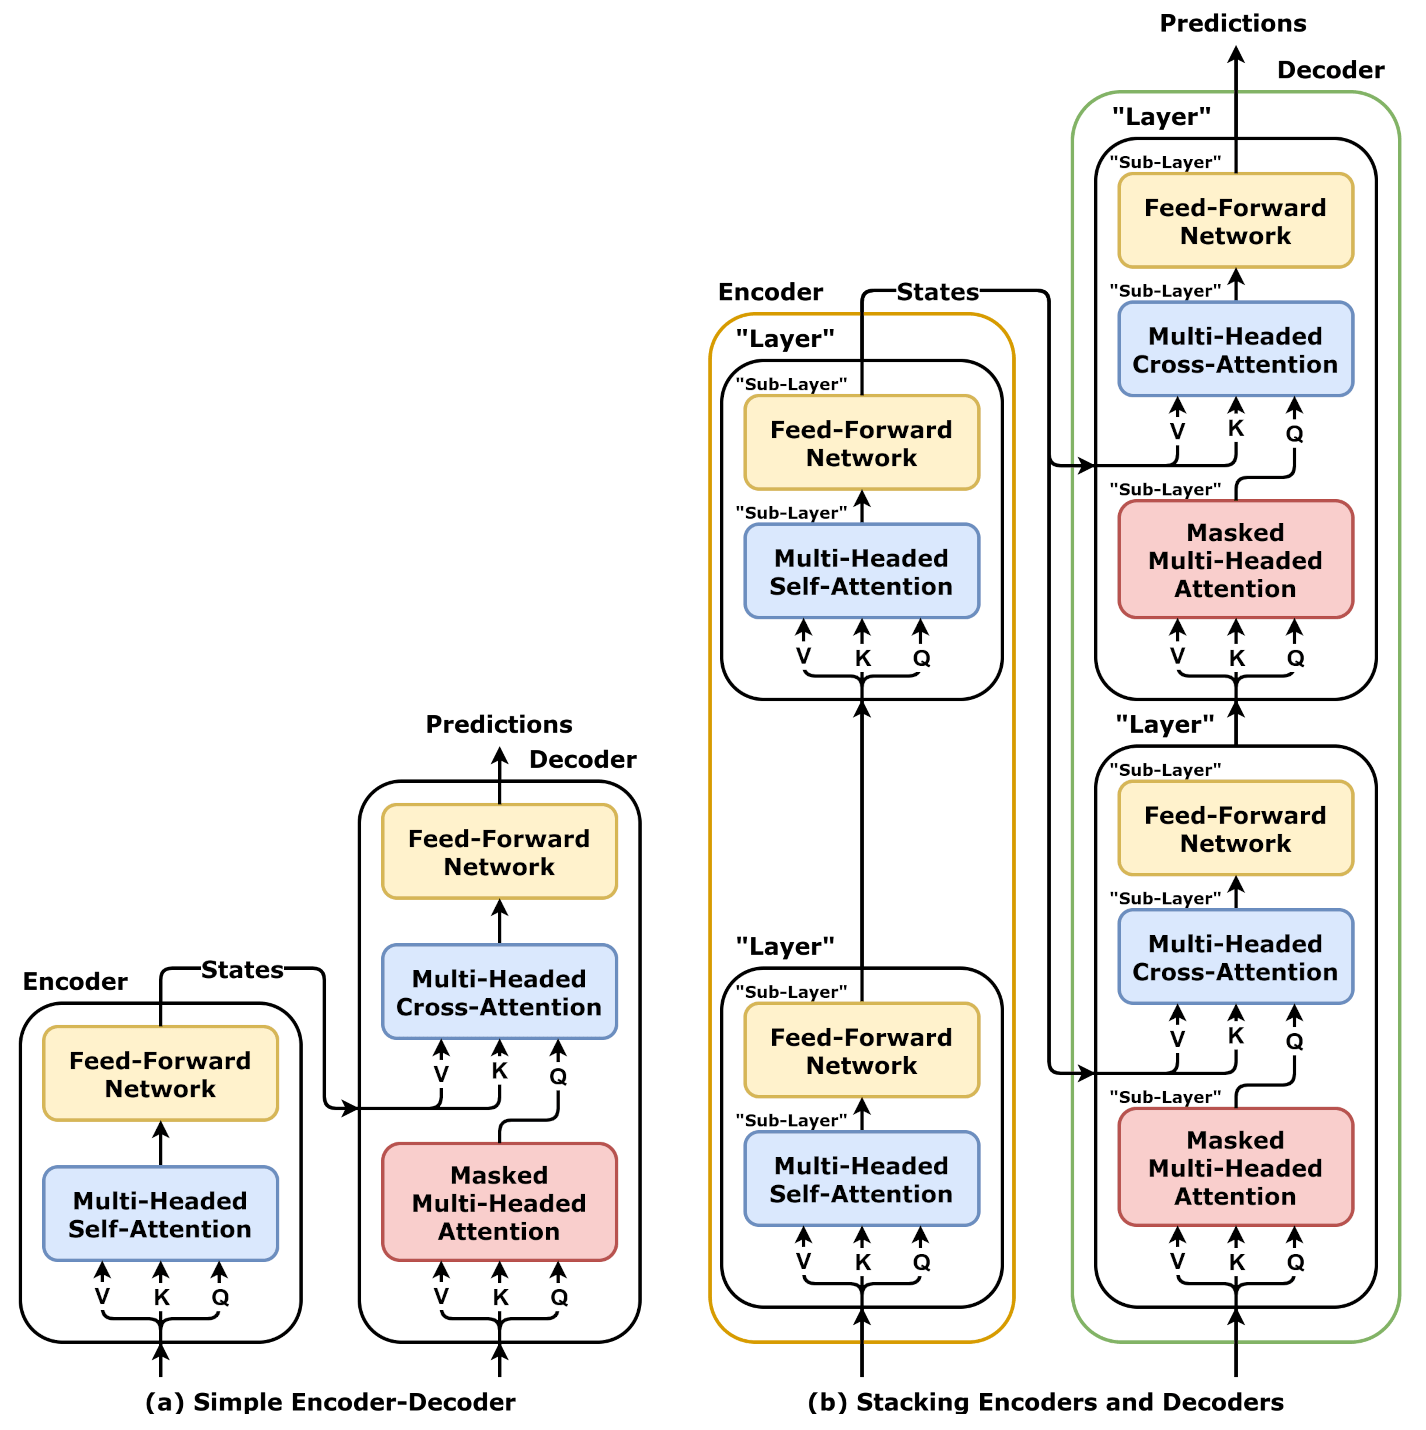
같은 블록을 수십~수백 층 쌓은 모습
70 B 모델이면 이 블록이 80층, 405 B면 126층이다. 층이 깊어질수록 KV 캐시가 층 수에 비례해 커진다. 「모델이 크면 왜 동시 사용자가 줄어드는가」의 직접적인 이유가 이 그림에 있다.
출처: dvgodoyCC BY 4.0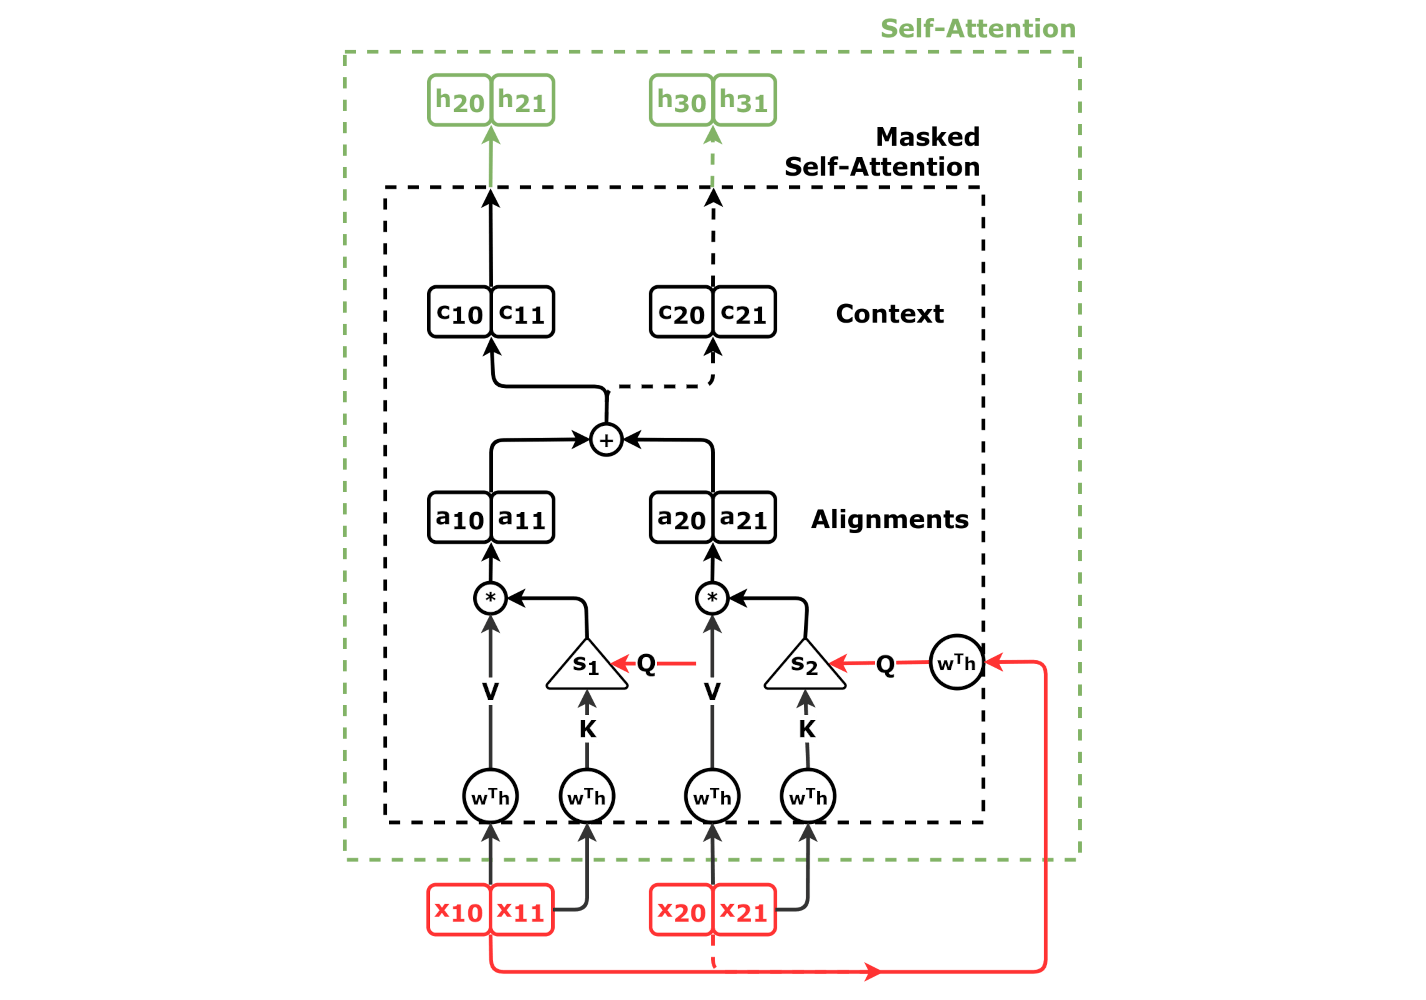
인과 마스킹이 걸린 디코더 셀프어텐션
각 토큰은 자기보다 앞선 토큰만 볼 수 있다(마스킹). 이 제약 때문에 토큰을 한 번에 하나씩만 만들 수 있고, 그것이 디코드가 순차적일 수밖에 없는 이유다. 13장의 투기적 디코딩은 바로 이 순차성을 우회하려는 시도다.
출처: dvgodoyCC BY 4.0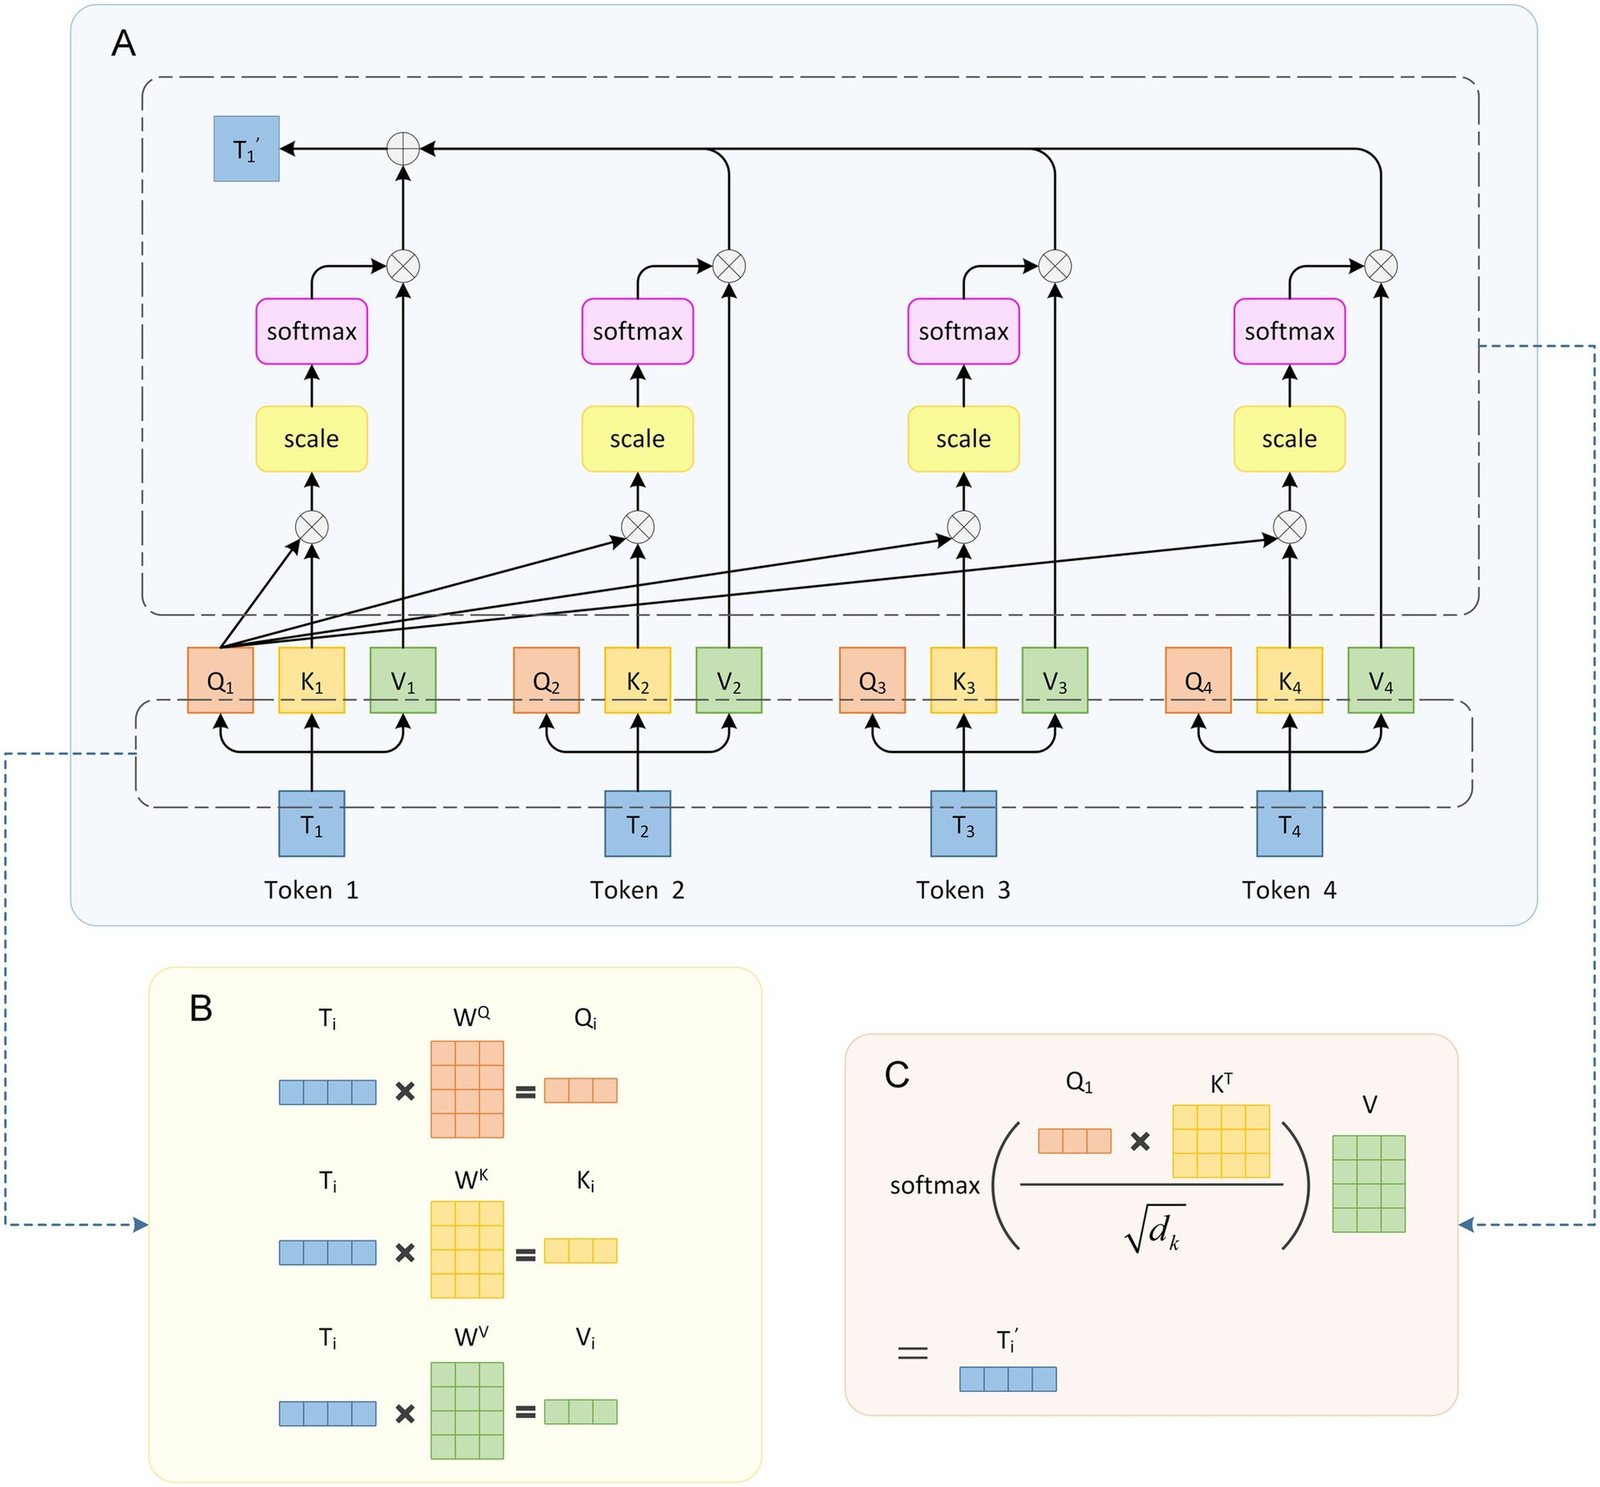
어텐션 헤드 하나 안에서 일어나는 일
Query·Key·Value 세 벌의 행렬이 만들어지고, Q와 K의 내적으로 가중치를 구한 뒤 V를 섞는다. 여기서 K와 V를 저장해 두는 것이 KV 캐시다. Q는 저장하지 않는다 — 14장 공식의 「2 ×」가 Key와 Value 두 벌이라는 뜻인 이유가 이것이다.
출처: Shuang Zhang, Rui Fan, Yuti Liu, Shuang Chen, Qiao Liu, Wanwen ZengCC BY 4.0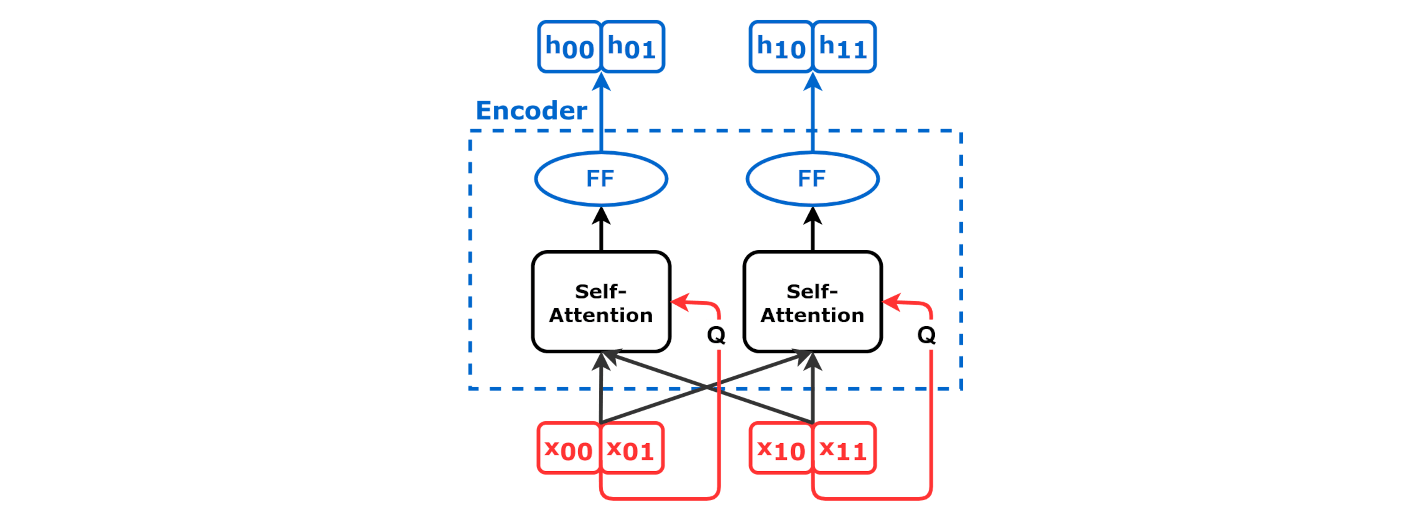
셀프어텐션 블록의 개략도
입력이 들어와 어텐션을 거치고 잔차 연결과 정규화를 지나 나간다. 이 단순한 구조가 수백 층 반복되며, 행렬 곱이 연산량의 대부분을 차지한다. 2장에서 볼 시스톨릭 어레이가 겨냥하는 것이 정확히 이 행렬 곱이다.
출처: dvgodoyCC BY 4.0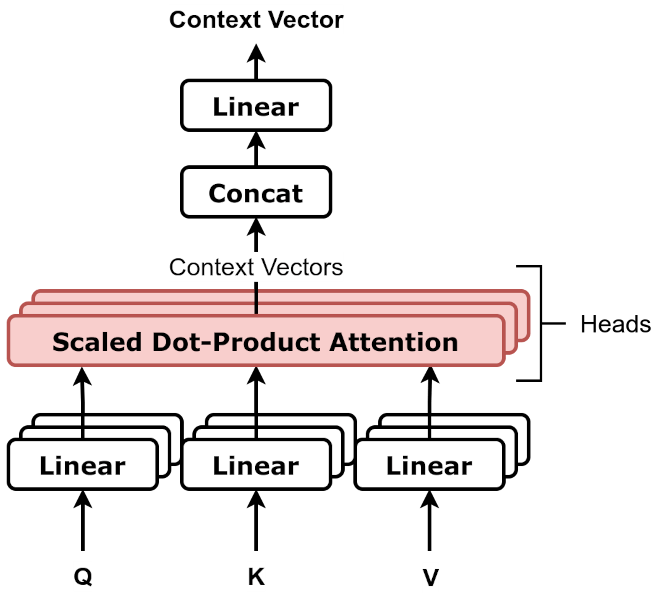
멀티헤드 어텐션 — 여러 헤드가 병렬로
헤드를 여럿 두어 서로 다른 관계를 동시에 본다. 헤드 수가 많을수록 KV 캐시도 커지므로, 최근 모델은 GQA로 Query 헤드는 많이 두되 Key·Value 헤드는 적게 공유하는 구조를 쓴다. 14장에서 「KV 헤드 8개」라는 숫자가 나오는 배경이다.
출처: dvgodoyCC BY 4.0프리필과 디코드 — 이 과목에서 가장 중요한 한 장
모델에 프롬프트를 넣고 답을 받는 과정은 두 단계로 나뉜다.
- 프리필(prefill) — 입력 프롬프트 전체를 한 번에 읽어 KV 캐시를 만든다. 첫 토큰이 나올 때까지의 시간(TTFT)을 결정한다.
- 디코드(decode) — 토큰을 하나씩 순차적으로 생성한다. 토큰 간 시간(TPOT)을 결정한다.
두 단계는 같은 가중치로 같은 연산을 하는데도 하드웨어 입장에서는 완전히 다른 일이다. 그 이유는 연산 강도(arithmetic intensity), 즉 「메모리에서 1바이트 읽어올 때마다 몇 번 계산하는가」가 다르기 때문이다.
루프라인 모델 위에 놓은 프리필과 디코드. 같은 모델·같은 가중치인데 한쪽은 연산 한계에, 다른 쪽은 대역폭 한계에 걸린다.
직접 제작 도해 · 자유 사용숫자로 확인하기
70B 모델을 FP8로 서빙한다고 하자. 가중치는 약 70GB다. 토큰 하나를 만들려면 이 70GB를 전부 HBM에서 읽어야 한다(MoE가 아니라면).
배치 1 · 디코드 1스텝
  읽어야 할 바이트   ≈ 70 GB   (가중치 전체)
  해야 할 연산       ≈ 2 × 70e9 = 140 GFLOPs
  연산 강도          = 140e9 / 70e9 ≈ 2 FLOPs/byte

HBM 대역폭이 8 TB/s 라면
  1스텝 소요시간     ≈ 70 GB / 8 TB/s ≈ 8.75 ms
  → 초당 약 114 토큰이 이론 상한. 연산 유닛은 거의 놀고 있다.

배치 256 · 디코드 1스텝
  읽어야 할 바이트   ≈ 70 GB   (똑같다! 가중치는 한 번만 읽으면 된다)
  해야 할 연산       ≈ 256 × 140 GFLOPs = 35.8 TFLOPs
연산 강도 ≈ 512 FLOPs/byte → 이제서야 연산 한계에 접근- 배치를 키우는 것이 디코드 처리량의 핵심이다. 다만 배치를 키우면 KV 캐시가 HBM을 잡아먹고 지연도 늘어난다 — 13장의 주제.
- 양자화는 연산이 아니라 메모리를 위한 것이다. FP8·NVFP4로 가는 진짜 이유는 곱셈이 빨라져서가 아니라 읽어야 할 바이트가 줄어서다.
- 프리필과 디코드는 다른 기계에서 돌리는 편이 낫다. 성격이 반대인 두 작업을 같은 GPU에 섞으면 서로를 방해한다. 이것이 P/D 분리 서빙(13장)과 디코드 전용 하드웨어(7장)의 근거다.
MoE(Mixture of Experts) 모델은 이 계산을 한 번 더 비튼다. 토큰마다 일부 전문가만 활성화되므로 읽는 바이트가 줄어들지만, 그 대신 어느 전문가가 어느 GPU에 있느냐에 따라 네트워크 통신이 발생한다. 메모리 문제를 네트워크 문제로 바꾼 셈이다 — 12장 전문가 병렬화(EP)에서 다룬다.
시스템 계층 — 칩에서 사이트 간까지
AI 팩토리는 다섯 계층으로 분해된다. 각 계층은 서로 다른 인터커넥트로 묶이며, 계층을 하나 내려갈 때마다 대역폭은 약 10배씩 줄고 지연은 약 1,000배씩 늘어난다. 이 비대칭이 분산 학습·서빙 설계의 모든 것을 결정한다.
AI 팩토리의 다섯 계층과 각 계층을 묶는 패브릭. 8~9장에서 ③·④를, 12장에서 병렬화 기법을 이 계층에 어떻게 매핑하는지 다룬다.
직접 제작 도해 · 자유 사용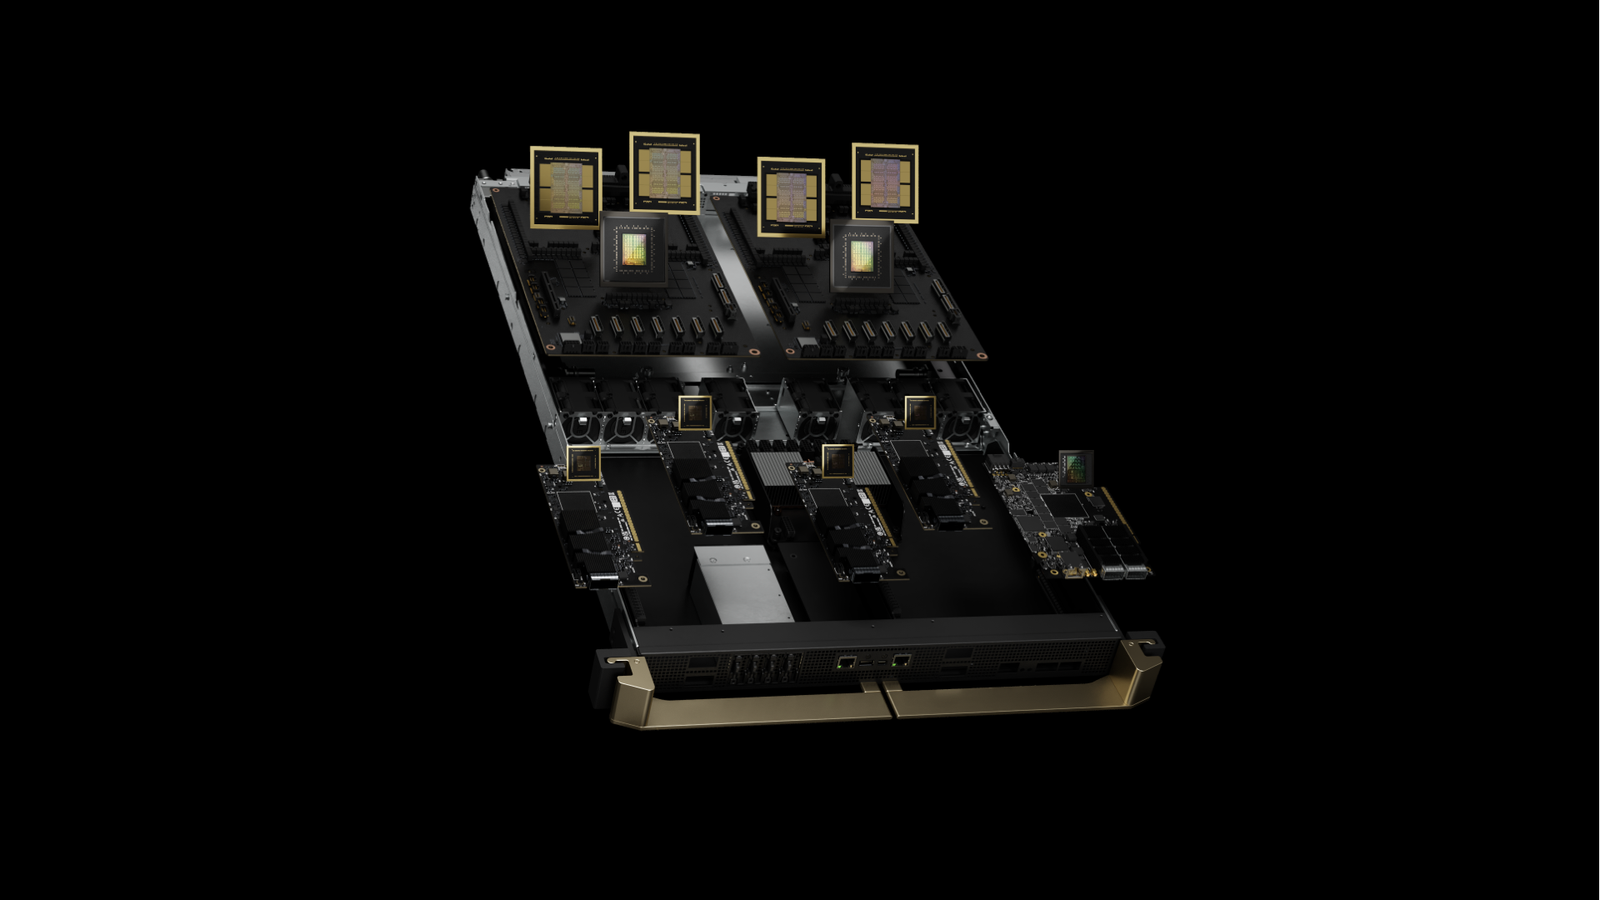
② 노드 — 컴퓨트 트레이 (제품 렌더)
한 장의 보드 위에 큰 칩 네 개가 올라가 있다. 이것이 랙에 꽂히는 최소 교체 단위이며, 보드 전체가 하나의 부품처럼 취급된다 — 칩 하나가 고장 나도 트레이째 교체한다. 3장에서 본 슈퍼칩 모듈이 이런 트레이에 실린다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)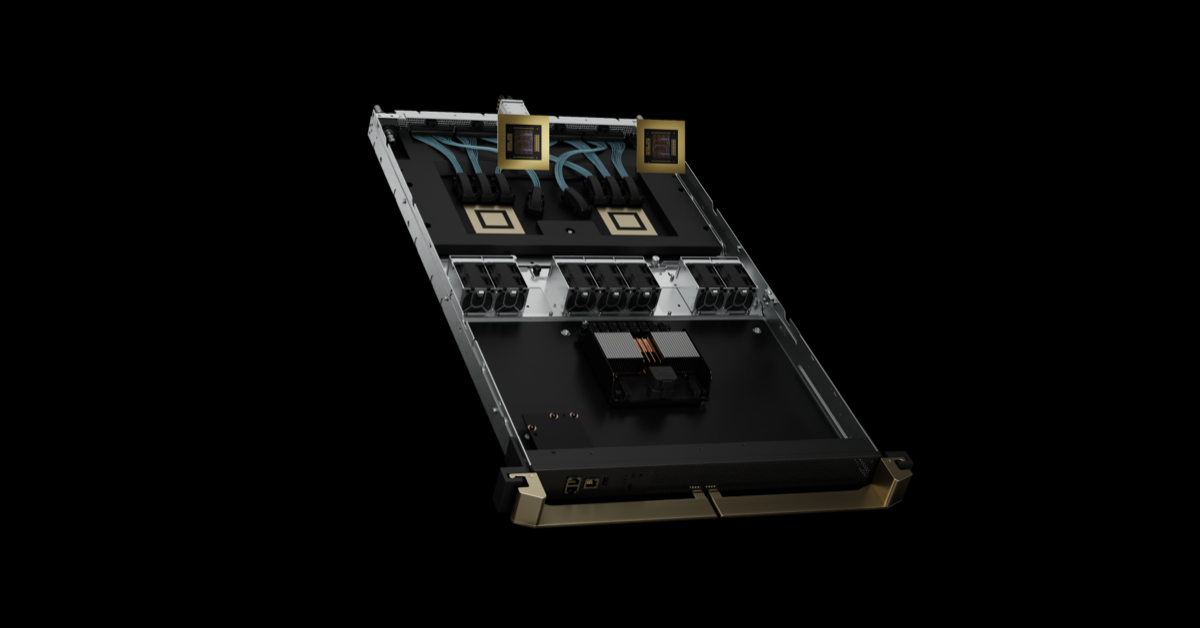
③ 랙 — NVLink 스위치 트레이. 이 트레이가 랙 안 72개 GPU를 전대역으로 연결한다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)여기서 반드시 짚어야 할 개념이 scale-up과 scale-out의 구분이다.
| Scale-up (랙 안) | Scale-out (랙 사이) | |
|---|---|---|
| 비유 | GPU를 하나로 키운다 | GPU를 여러 개 늘어놓는다 |
| 기술 | NVLink, UALink, 이더넷 기반 SUE | InfiniBand, Spectrum-X 이더넷 |
| GPU당 대역폭 | 1.8~3.6 TB/s | 0.4~0.8 Tb/s (≈ 50~100 GB/s) |
| 메모리 접근 | 다른 GPU의 HBM을 직접 읽는다 | 명시적 메시지 전송 |
| 어울리는 병렬화 | 텐서 병렬(TP), 전문가 병렬(EP) | 데이터 병렬(DP), 파이프라인 병렬(PP) |
| 규모 한계 | 수십~수천 (전력·거리 제약) | 수십만 이상 |
숫자는 2026년 상용 제품 기준의 대략적 규모다. 제품별 정확한 값은 4~6장, 패브릭 기술의 상세는 8~9장에서 다룬다.
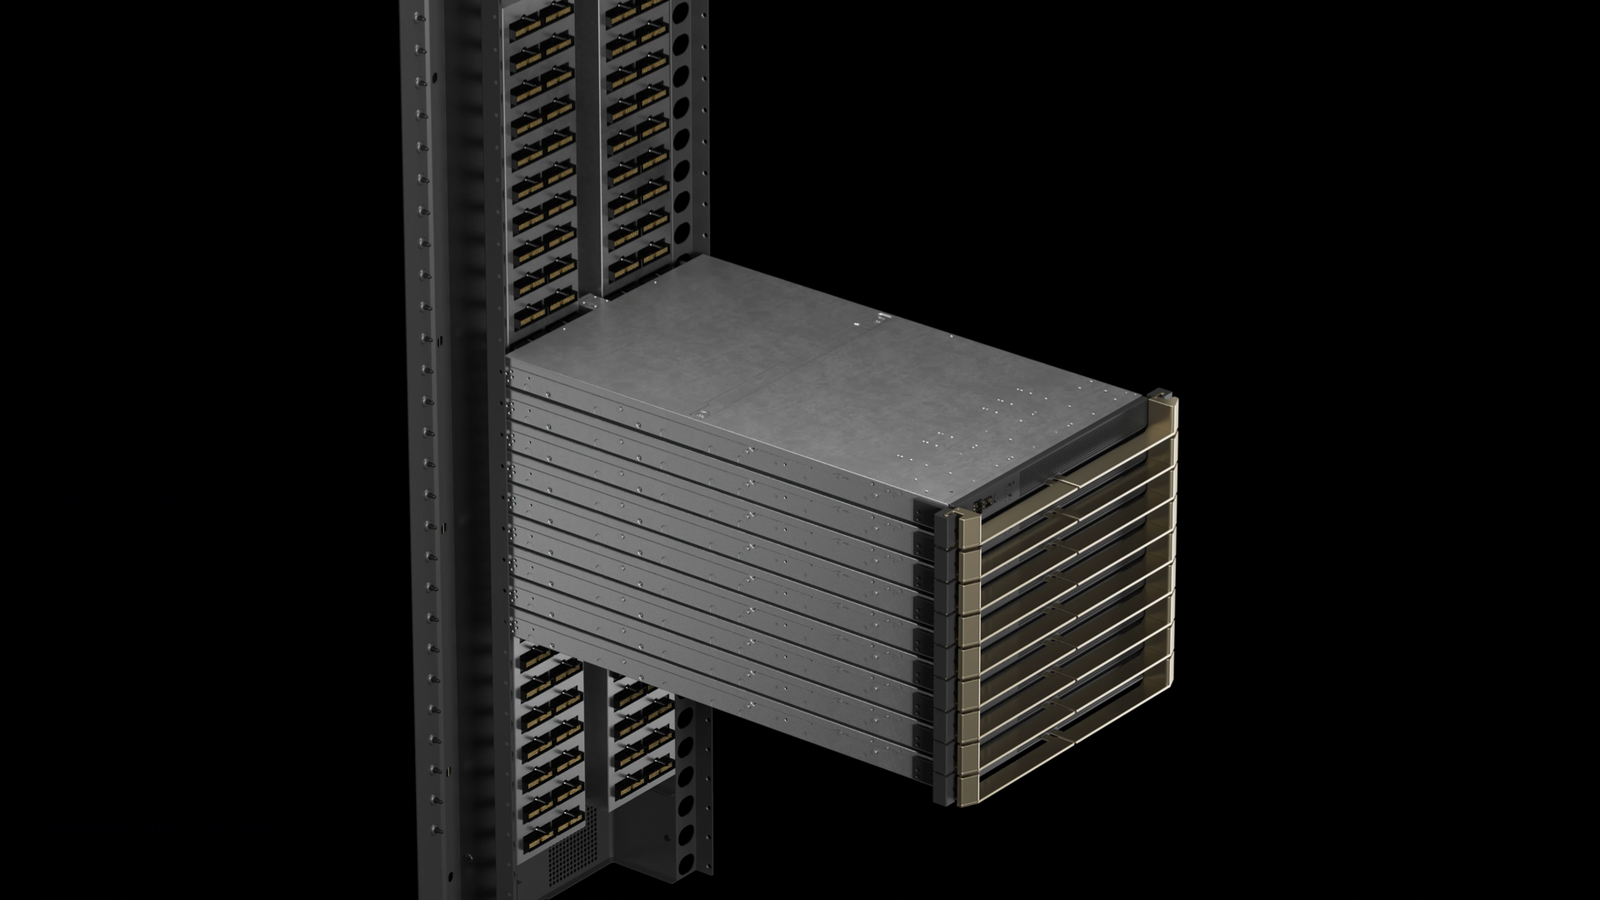
③ 랙을 하나로 묶는 NVLink 스위치 시스템 전체
스위치 트레이 여러 장이 랙 안 모든 GPU를 연결한다. 이 구조 덕분에 어느 GPU에서 어느 GPU로든 같은 대역폭·같은 지연으로 접근할 수 있고, 그래서 소프트웨어가 「72개를 하나처럼」 다룰 수 있다. 8장의 주제다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)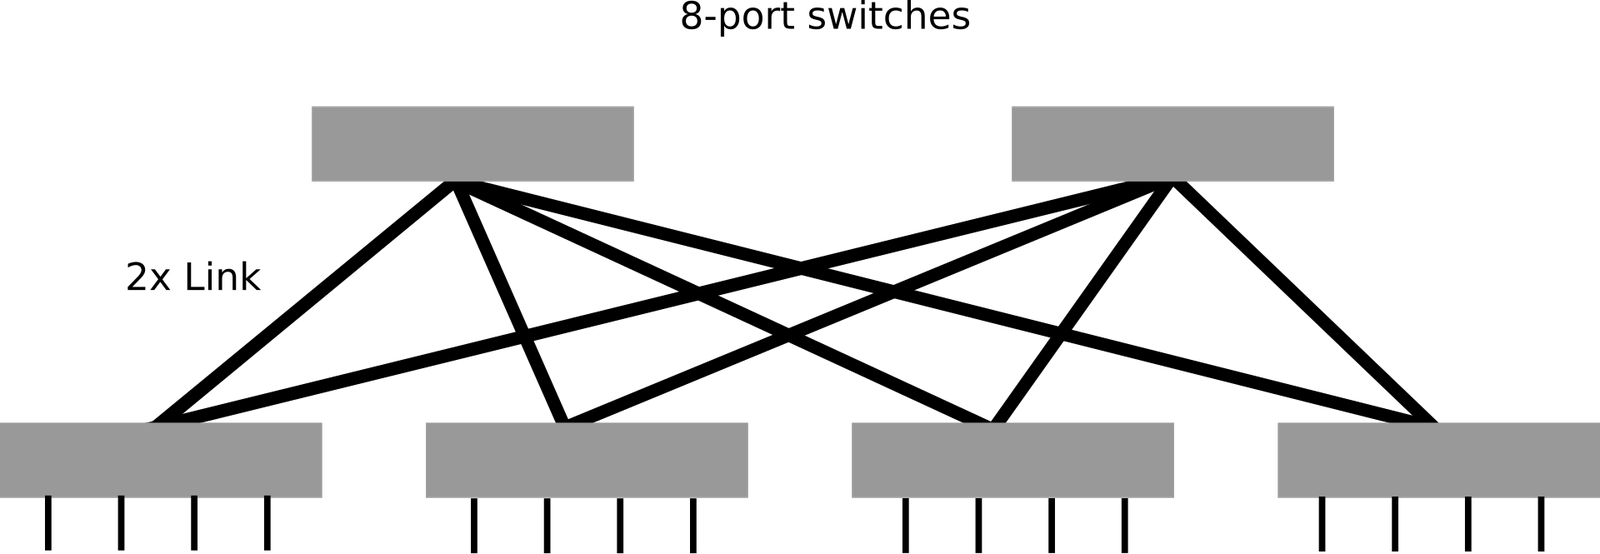
④ 클러스터를 묶는 대표적 토폴로지 fat-tree
위로 올라갈수록 링크가 굵어져 어느 노드 쌍이든 같은 대역폭을 보장하려 한다. 「굵어진다」는 것은 실제로는 링크를 여러 개 병렬로 놓는다는 뜻이며, 그래서 위층 스위치가 더 많이 필요해진다. 9장에서 그 개수를 직접 계산한다.
출처: Konstantinos AgiannisCC BY-SA 4.0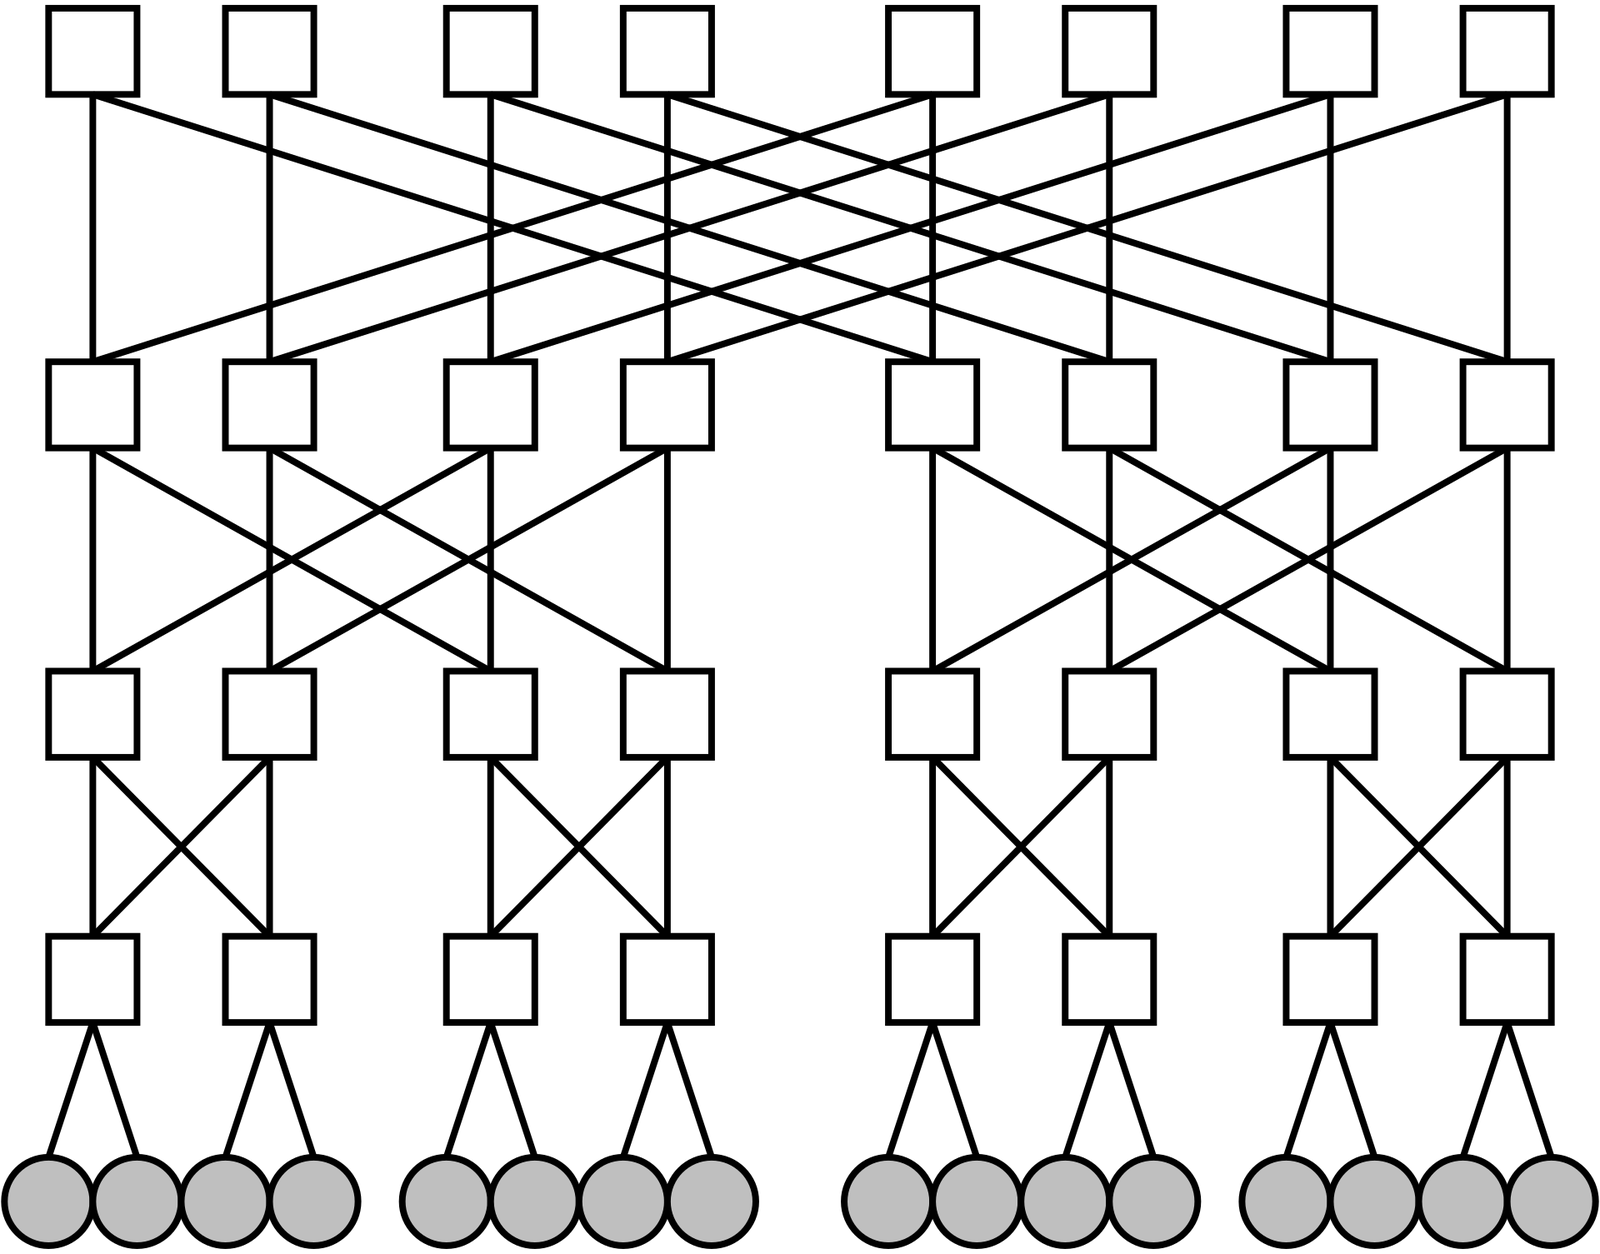
fat-tree를 다른 방식으로 그린 것 — 단계별 연결 관계가 더 잘 보인다
아래쪽 잎(leaf)에 노드가 붙고, 위로 올라갈수록 경로가 여러 갈래로 갈라진다. 어느 두 노드를 잡아도 같은 대역폭이 나오게 하는 것이 이 구조의 목표이며, 그 대가로 스위치와 케이블이 많이 든다. 9장에서 「오버서브스크립션」으로 이 대가를 얼마나 깎을 수 있는지 따져 본다.
출처: User:A5bPublic domain산업 지형 — 왜 이렇게 빨리 바뀌는가
이 과목이 매년 갱신을 전제로 설계된 이유는 NVIDIA가 2023년경부터 연간 케이던스로 전환했기 때문이다. 과거 2년 주기였던 아키텍처 교체가 1년으로 줄었다.
Blackwell → Blackwell Ultra → Rubin → Rubin Ultra → Feynman
   (GB200)      (GB300)        (VR200)    (Kyber NVL576)
케이던스가 짧아진 결과는 단순히 「칩이 자주 나온다」가 아니다. GPU 세대가 바뀔 때마다 랙 전력, 냉각 방식, 네트워크 세대, 심지어 배전 아키텍처까지 함께 바뀐다. 11장에서 보겠지만 Hopper(약 40kW) → GB200(약 120kW) → VR200(약 190~230kW)의 변화는 건물 설계를 매번 다시 하게 만든다.
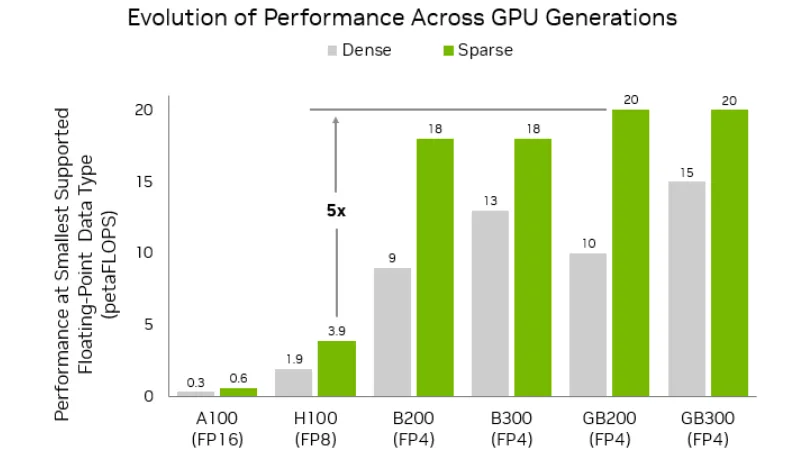
세대별 최고 성능 — 다만 정밀도가 세대마다 다르다
A100은 FP16 기준 0.3 PF, GB300은 FP4 기준 15 PF로 적혀 있다. 즉 가로로 늘어선 막대들이 같은 조건이 아니다. 회색이 dense, 초록이 sparse(희소성 가정)이므로 같은 칩도 두 값이 나온다. 「A100에서 GB300까지 50배」 같은 문장을 만들려면 FP16 dense 0.3과 FP4 sparse 20을 비교하는 셈인데, 그건 같은 것을 잰 것이 아니다. 15장의 「벤더 주장 vs 독립 측정」 체크리스트가 이 그래프 한 장에 다 필요하다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)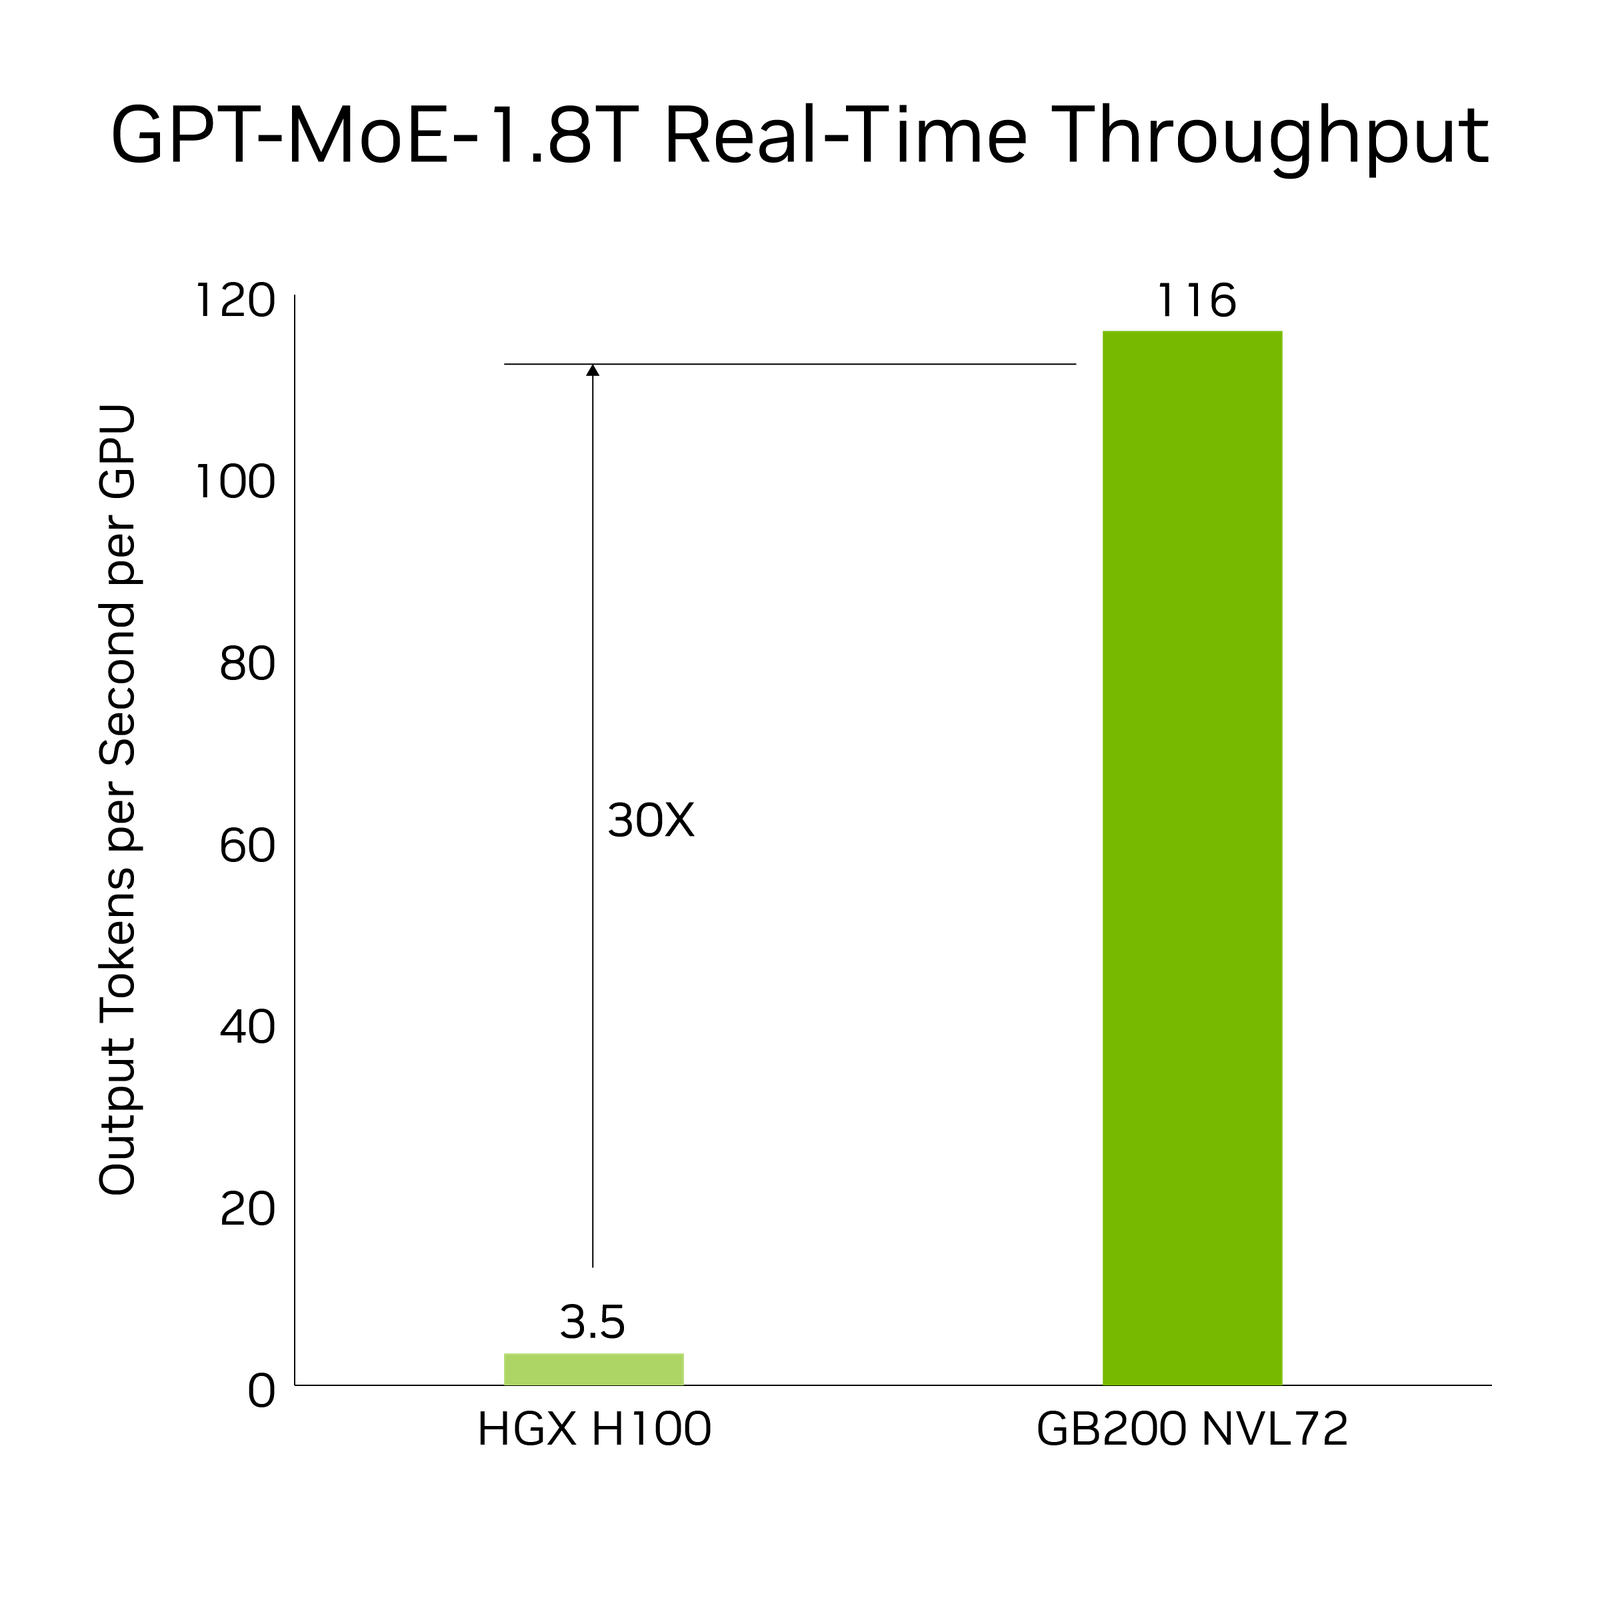
GPT-MoE 1.8T 추론 — HGX H100 대비 GB200 NVL72가 30배 (벤더 제시)
세로축이 GPU 한 장당 초당 출력 토큰이고, 3.5 → 116으로 30배다. GPU당으로 정규화했다는 점이 중요한데, 그러면 「랙에 GPU가 더 많아서」라는 반론이 막힌다. 그래도 남는 질문은 있다 — 어떤 정밀도인가, 어떤 SLO에서 잰 것인가, 전력은? 1장 뒤쪽에서 볼 프리필/디코드 비율에 따라서도 이 값은 크게 달라진다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)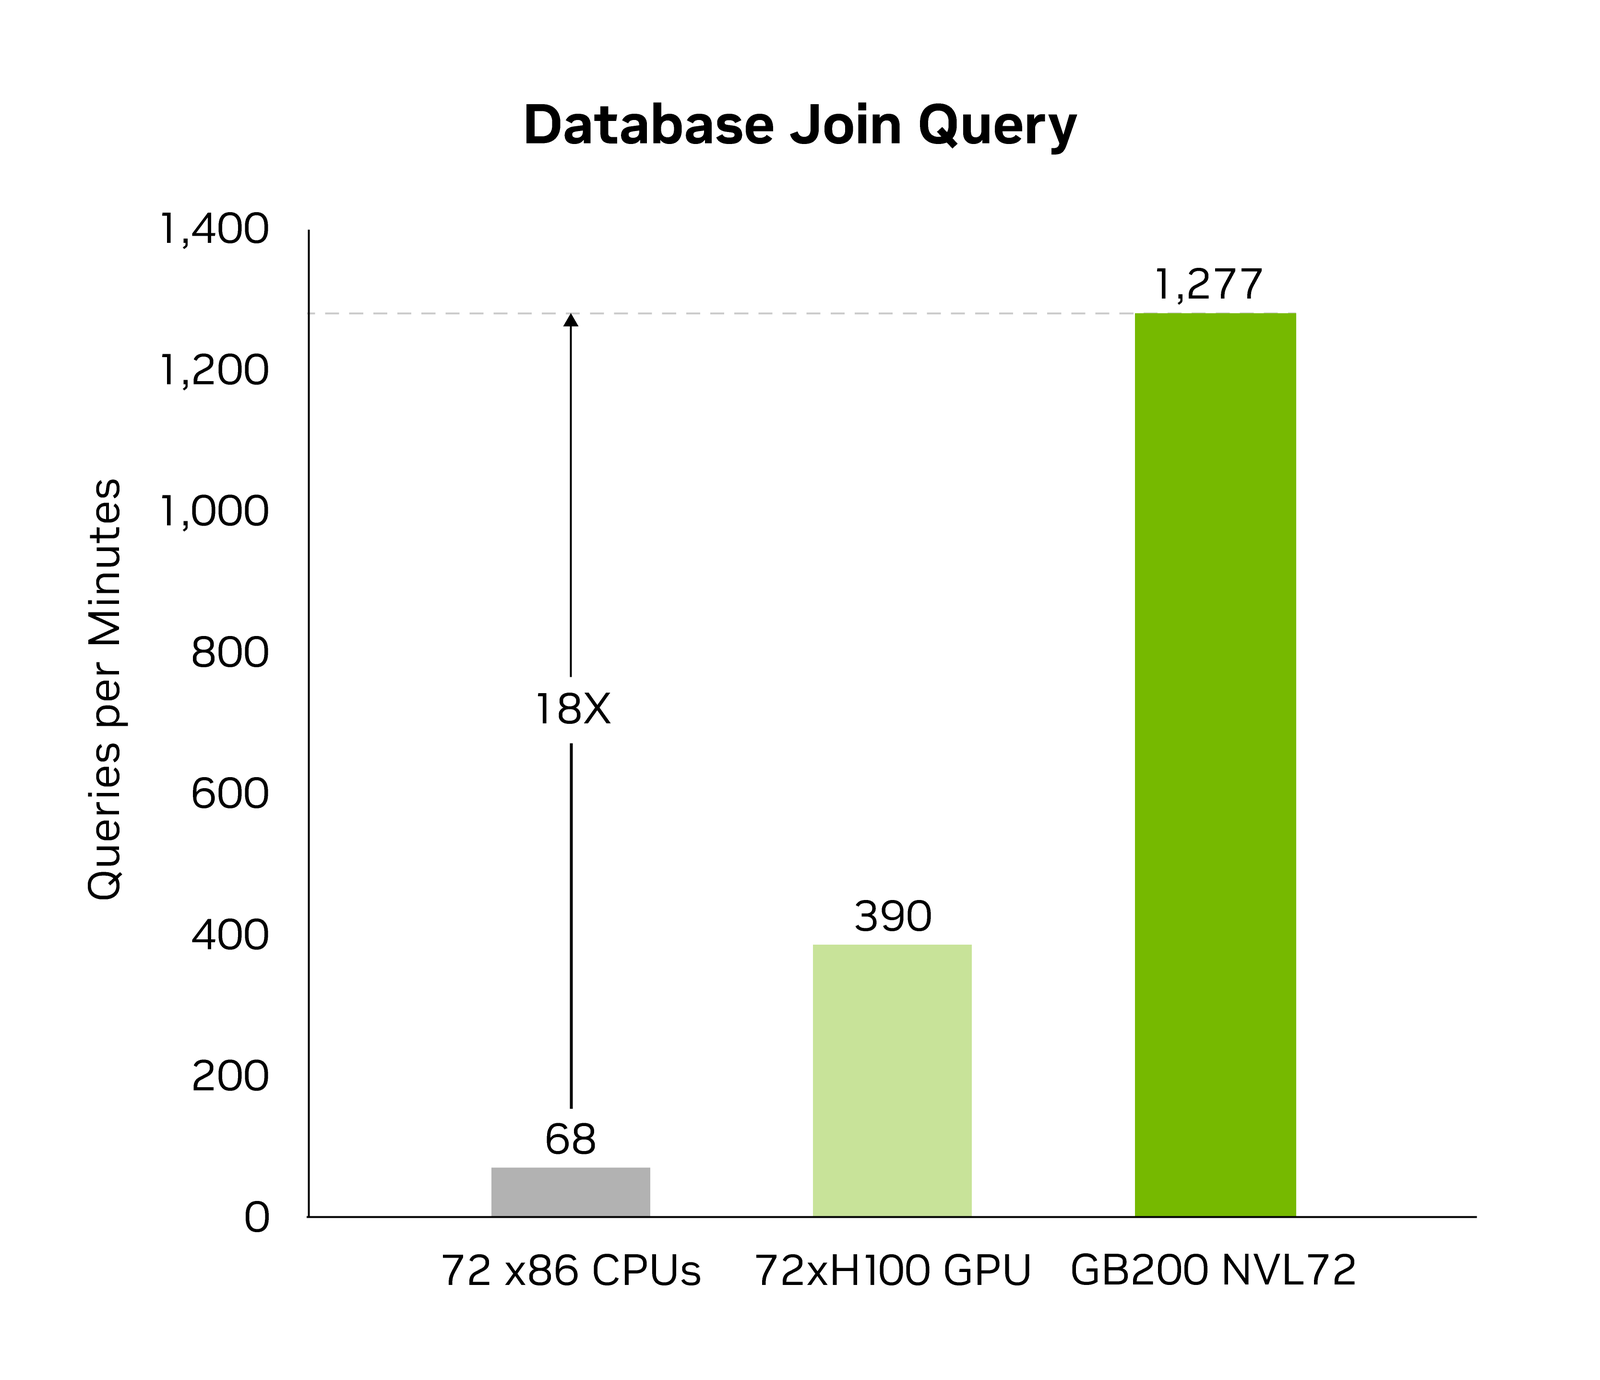
데이터베이스 조인 질의 — AI가 아닌 워크로드에서의 비교
72개 x86 CPU가 분당 68건, 72개 H100이 390건, GB200 NVL72가 1,277건이다. AI 워크로드가 아니라 데이터 처리 성능이라는 점이 흥미롭다 — GPU 데이터센터가 학습·추론만 하는 것이 아니라 데이터 전처리·분석까지 가져가려 한다는 방향을 보여준다. 10장에서 볼 데이터 파이프라인 병목과 이어지는 이야기다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)판이 커지면서 생긴 두 번째 변화
- 하이퍼스케일러 자체 실리콘 — Google TPU, AWS Trainium, Microsoft Maia, Meta MTIA. 구매력이 충분히 크면 자기 워크로드에 맞춘 칩을 직접 만드는 편이 싸진다 (6장).
- 개방형 규격 진영 — UALink, Ultra Ethernet, OCP 랙 규격. NVLink 독점에 대응해 AMD·Broadcom·하이퍼스케일러가 뭉쳤다 (5장, 8장).
- 추론 전용 하드웨어 — 디코드가 대역폭에 묶인다는 사실을 정면으로 노린 설계들 (7장).
이 커리큘럼이 다루는 제품 사양·출하 시점·계약 규모는 강의 준비 시점의 공개 자료에 근거한다. 특히 아직 출하 전인 제품의 수치는 벤더 발표값이므로, 수업에서 인용할 때는 반드시 원문 슬라이드·블로그를 함께 확인하고 갱신하기 바란다. 5절의 갱신 캘린더를 참고할 것.
실습 — 손계산과 실측을 맞춰보기
목표: 토큰 1개를 만드는 비용을 이론적으로 계산하고, DGX Spark에서 실제로 측정해 둘이 얼마나 맞는지 확인한다. 어긋난다면 그 차이가 어디서 오는지 설명한다.
1단계 — 손계산 (30분)
- 실습에 쓸 소형 모델(예: 1~8B급)의 파라미터 수와 정밀도를 확인한다.
- 가중치 크기 = 파라미터 수 × 바이트/파라미터 를 계산한다.
- 디코드 1스텝의 이론 소요시간 = 가중치 크기 ÷ 메모리 대역폭 을 구한다.
- 여기서 나온 초당 토큰 수를 적어 둔다. 이것이 이론 상한이다.
2단계 — 실측 (40분)
# 장비 메모리 대역폭 확인
nvidia-smi --query-gpu=name,memory.total --format=csv

# 서빙 후 TTFT / TPOT 측정 (예: vLLM 벤치마크 스크립트)
#   - 짧은 프롬프트 / 긴 프롬프트 각각
#   - 배치 1 / 배치 8 / 배치 32
# 기록할 값: TTFT(ms), TPOT(ms), 처리량(tok/s), GPU 사용률(%)
3단계 — 해석 (20분)
- 배치 1일 때 실측 토큰/초는 이론 상한의 몇 %인가? 왜 100%가 안 나오는가?
- 배치를 8배 늘렸을 때 처리량은 몇 배가 되는가? 8배가 안 된다면 무엇이 막고 있는가?
- 프롬프트를 10배 길게 했을 때 TTFT와 TPOT 중 어느 쪽이 더 늘어나는가? 왜인가?
nvidia-smi dmon으로 본 GPU 사용률이 낮다면, 그것은 「놀고 있다」는 뜻인가? (힌트: 사용률은 SM이 명령을 실행 중인 비율이지 연산 유닛이 꽉 찼다는 뜻이 아니다.)
제출물
계산 과정과 측정표, 그리고 이론과 실측이 어긋난 이유에 대한 설명 (A4 2장 이내).
- 「AI 팩토리」라는 비유는 어디까지 유효한가? 공장과 다른 점은 무엇인가?
- 추론 비중이 계속 커진다면, 5년 뒤 데이터센터의 칩 구성비는 어떻게 될까?
- 우리 학교가 GPU를 산다면, 사전학습용인가 추론용인가? 그 답이 장비 선택을 어떻게 바꾸는가?
참고 자료
- NVIDIA Technical Blog — GB200 NVL72 : 이 페이지의 랙·트레이 사진 출처
- Williams, Waterman, Patterson, Roofline: An Insightful Visual Performance Model (CACM 2009) — 루프라인 모델 원논문
- NVIDIA Dynamo Docs — Disaggregated Serving : 프리필/디코드 분리의 실제 구현 (13장 예습)
- vLLM 문서 : 실습에 사용할 서빙 엔진