AMD Helios와 개방형 진영
같은 72-GPU 랙을 만드는데, 한쪽은 전용 규격으로 묶고 다른 쪽은 이더넷 위에 얹는다. 이 차이가 성능·가격·공급망에서 무엇을 바꾸는지, 그리고 「토큰당 30% 싸다」는 주장이 어떤 조건에서 성립하는지 따져 본다.
이 장을 마치면
- Helios 랙의 구성을 VR200 NVL72와 항목별로 비교할 수 있다.
- 수직 통합과 개방형 조립의 트레이드오프를 계층별로 설명할 수 있다.
- UALink·SUE가 「이더넷 위에 scale-up을 얹는다」는 것의 기술적 의미를 설명할 수 있다.
- GW 단위 고객 계약이 제품 로드맵과 공급망에 주는 의미를 해석할 수 있다.
- 동일 워크로드 기준으로 두 랙의 비용을 비교하는 표를 만들 수 있다.
Helios — AMD가 내놓은 랙
AMD는 CPU와 GPU를 모두 가진 유일한 회사다. Helios는 그 이점을 랙 단위로 묶은 제품이다.
| 항목 | Helios | 비교: VR200 NVL72 |
|---|---|---|
| 가속기 | MI455X × 72 (CDNA5) | Rubin GPU × 72 |
| CPU | EPYC Venice × 18 (2nm, 최대 256코어 Zen 6) | Vera CPU |
| HBM 총량 | 31 TB (HBM4) | 288 GB × 72 ≈ 20.7 TB |
| 저정밀 성능 | FP4 2.9 EF | — |
| Scale-up | UALink over Ethernet | NVLink 6 · 260 TB/s |
| 네트워킹 | Pensando | ConnectX-9 · Spectrum-6 |
| 랙 규격 | OCP Open Rack Wide (ORW) | MGX |
| 소프트웨어 | ROCm 7 | CUDA |
| 출하 | 2026년 3분기 말 | 2026년 하반기 |
- HBM 총량 31 TB — 용량 우위를 정면으로 내세운다. 2장에서 본 「용량 vs 대역폭」 선택에서 AMD는 용량 쪽에 걸었다. 큰 모델을 더 적은 랙에 얹을 수 있다는 것이 논거다.
- OCP Open Rack Wide — 랙 규격 자체가 개방형 표준이다. 여러 ODM이 같은 규격으로 만들 수 있고, 고객이 벤더를 갈아탈 여지가 생긴다.
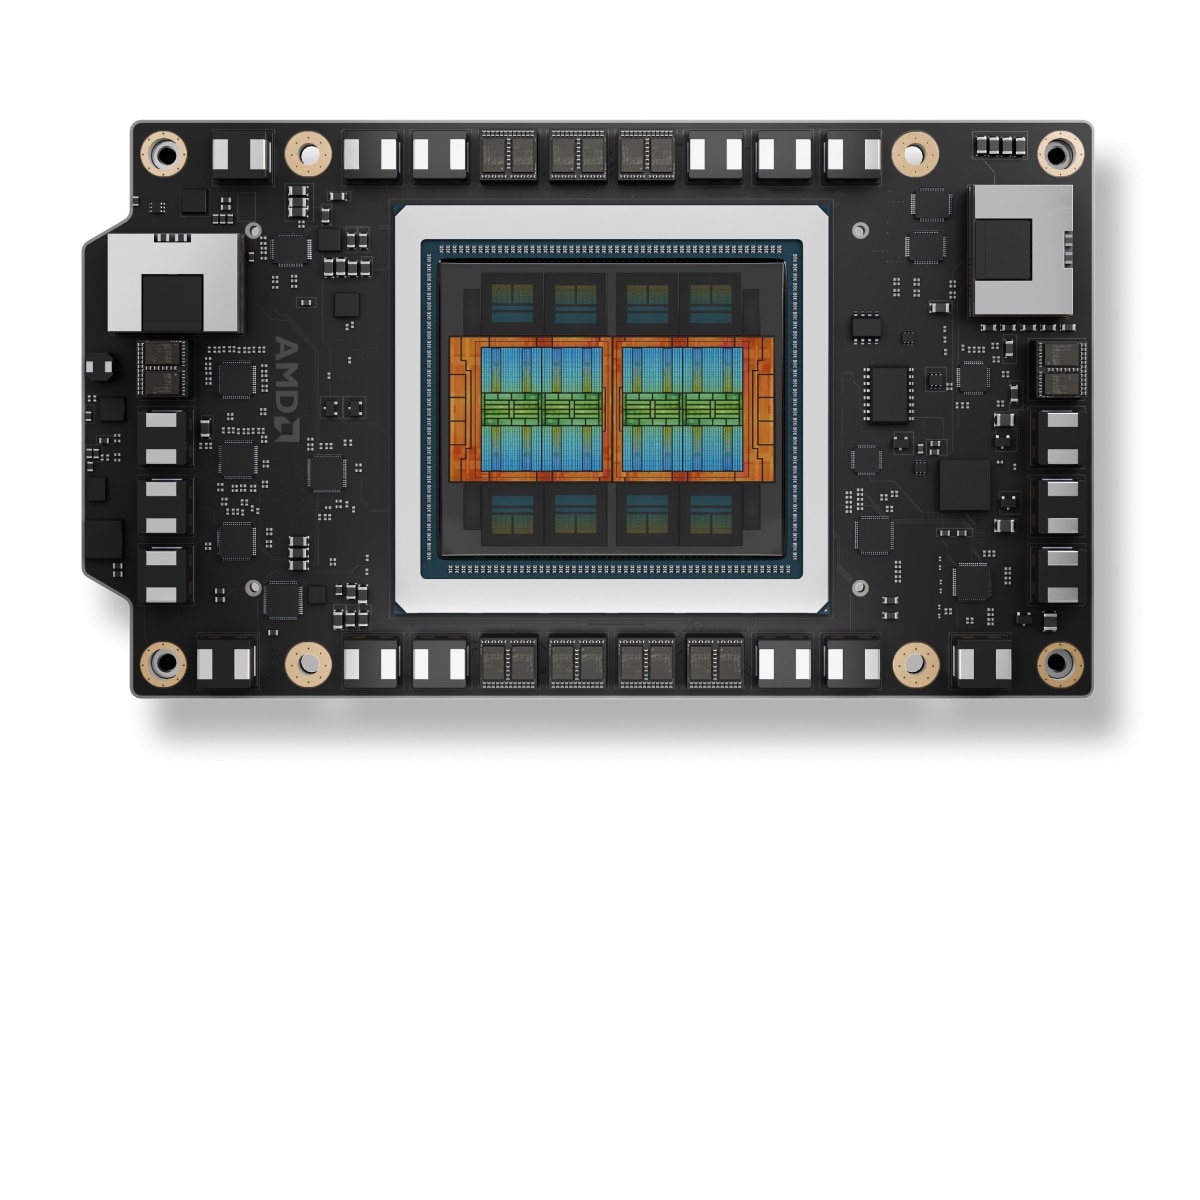
AMD Instinct 가속기 모듈(MI350X). 가운데 큰 다이 주변으로 HBM 스택이 둘러싼 2장의 전형적인 배치다. MI455X도 같은 계보다.
출처: www.amd.com© www.amd.com (교육 목적 인용)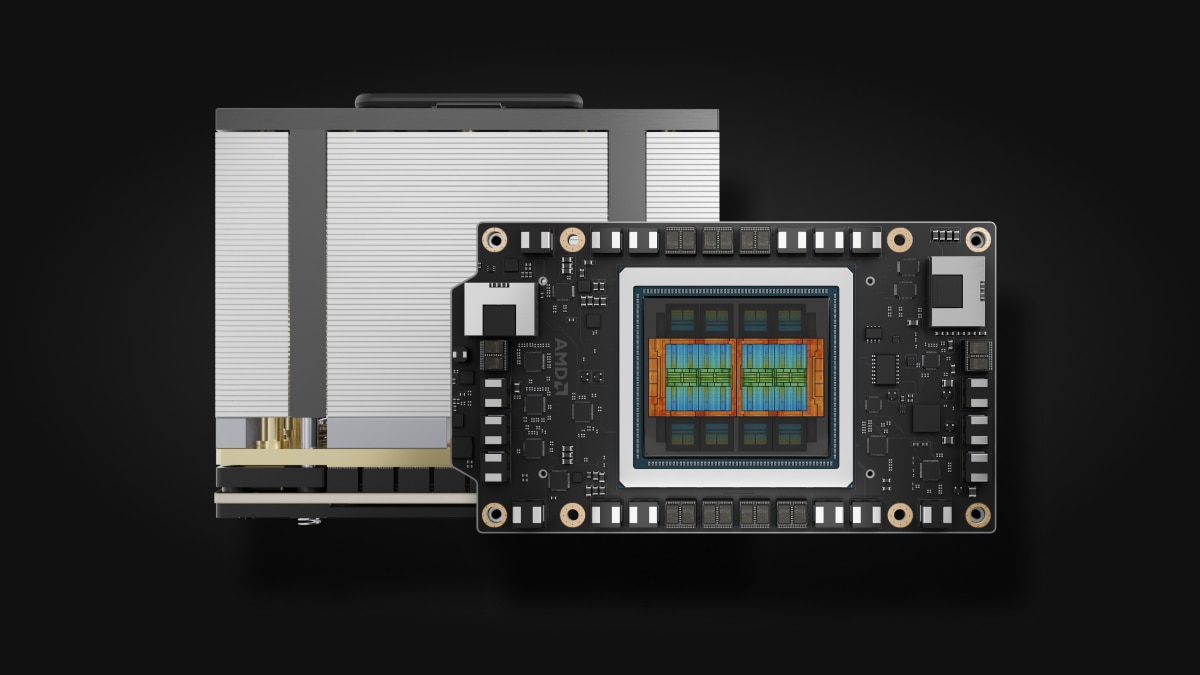
같은 모듈의 다른 각도. OAM 폼팩터로, 이 규격 자체가 OCP 표준이다.
출처: www.amd.com© www.amd.com (교육 목적 인용)설계 철학 — 수직 통합 대 개방형 조립
Helios와 NVL72의 진짜 차이는 사양표의 숫자가 아니라 누가 각 계층을 공급하는가에 있다.
같은 랙을 만드는 두 가지 방법. 색이 다르면 공급자가 다르다는 뜻이다.
직접 제작 도해 · 자유 사용고객이 실제로 저울질하는 것
| 수직 통합 (NVIDIA) | 개방형 조립 (AMD·OCP) | |
|---|---|---|
| 초기 도입 | 빠르다 — 검증된 조합 | 느리다 — 조합 검증이 필요 |
| 소프트웨어 성숙도 | CUDA 생태계의 축적 | ROCm이 빠르게 추격 중이나 격차 존재 |
| 가격 협상력 | 약하다 | 계층마다 경쟁이 생긴다 |
| 공급망 위험 | 한 회사에 집중 | 분산 가능 |
| 성능 예측 가능성 | 높다 | 조합에 따라 편차 |
| 장기 종속 | 높다 | 낮다 |
여기서 중요한 것은 정답이 규모에 따라 달라진다는 점이다. 수십 대 규모라면 검증 부담이 크므로 수직 통합이 유리하다. GW 단위로 사는 고객이라면 가격 협상력 1%가 수억 달러이므로 개방형에 투자할 이유가 생긴다.
이더넷 위에 scale-up을 얹는다는 것
개방형 진영의 기술적 핵심은 UALink와 SUE(Broadcom의 Scale-Up Ethernet)다. 둘 다 「이더넷 물리 계층 위에 scale-up 의미론을 올린다」는 발상을 공유한다.
8장에서 자세히 다루지만 여기서 미리 짚고 가자. scale-up 패브릭의 본질은 「다른 칩의 메모리를 내 주소공간처럼 읽는 것」이다. 메시지를 보내는 것(scale-out)이 아니라 로드/스토어를 하는 것이다.
그러려면 지연이 아주 낮고, 순서가 보장되고, 오류율이 극히 낮아야 한다. NVLink는 이 요구에 맞춰 처음부터 전용으로 설계됐다. UALink·SUE는 이더넷의 물량 경제성을 빌리되 그 위에 이런 의미론을 얹으려는 시도다.
| NVLink 6 | UALink 1.0 | UALink 2.0 (규격) | |
|---|---|---|---|
| 레인당 속도 | — | 200 Gbps | 400 Gbps |
| 최대 가속기 수 | 72 (NVL72 기준) | 1,024 | — |
| 물리 계층 | 전용 | 이더넷 기반 | 이더넷 기반 |
| 특징 | 성숙 · 검증됨 | 개방 규격 | 인네트워크 컴퓨팅 · UCIe 칩렛 |
| 공급자 | NVIDIA | 다수 | 다수 |
GPU당 scale-up 대역폭으로 보면 MI455X 약 3.6 TB/s로 NVLink 5의 1.8 TB/s를 앞선다는 것이 AMD 측 주장이다. 다만 대역폭 숫자만으로는 답이 나오지 않는다 — 지연, 집합 통신(all-reduce) 효율, 소프트웨어 스택의 성숙도가 실제 성능을 좌우한다. 8장 실습에서 이 격차를 직접 측정한다.
Upscale AI 등 신규 스위치 공급자가 진입을 예고하고 있다. 개방형 진영의 성패는 「규격이 있는가」가 아니라 「실제로 여러 회사가 상호운용되는 물건을 내놓는가」에 달려 있다.
소프트웨어 격차를 어떻게 재는가
「ROCm이 CUDA를 따라잡았는가」는 예/아니오로 답할 질문이 아니다. 무엇을 기준으로 재느냐를 먼저 정해야 한다. 실무에서 쓰는 기준은 대체로 넷이다.
| 기준 | 무엇을 보는가 | 어떻게 확인하나 |
|---|---|---|
| ① 모델 커버리지 | 우리가 쓰려는 모델이 그대로 돌아가는가 | 실제로 로드해서 돌려 본다. 「지원 목록에 있다」와 다르다 |
| ② 성능 격차 | 같은 하드웨어 등급에서 몇 % 나오는가 | 같은 모델·같은 배치로 tokens/s 를 직접 비교 |
| ③ 신모델 대응 속도 | 새 모델이 나오고 며칠 만에 돌아가는가 | 최근 몇 개 모델의 지원 시점을 추적 |
| ④ 디버깅 가능성 | 문제가 생겼을 때 원인을 찾을 수 있는가 | 프로파일러·로그·커뮤니티 답변의 두께 |
추론 쪽 격차는 빠르게 좁혀지고 있다. vLLM·SGLang 같은 서빙 엔진이 벤더 중립적으로 만들어지면서, 「엔진이 지원하면 그 하드웨어에서 돈다」는 구조가 됐기 때문이다.
학습 쪽은 아직 격차가 크다. 커스텀 커널, 분산 학습 프레임워크의 세부 최적화, 디버깅 도구의 성숙도가 오랜 축적을 필요로 하는 영역이다. 그래서 개방형 진영이 추론 시장에서 먼저 발판을 얻으려 하는 것이며, 5장 앞부분에서 본 vLLM-ATOM·MORI-IO 같은 투자가 그 방향이다.
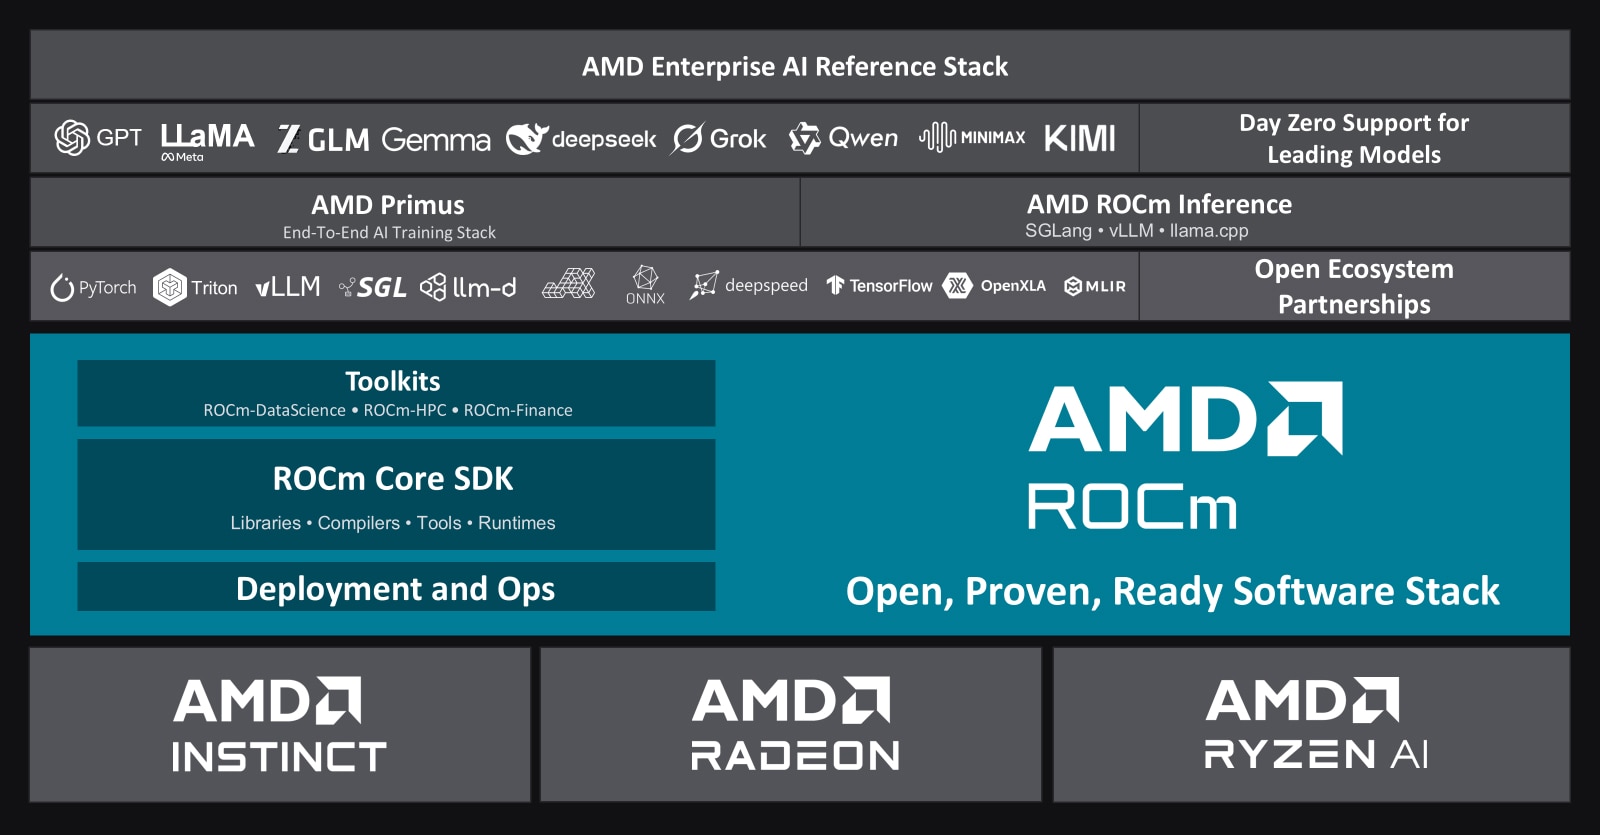
AMD Enterprise AI Reference Stack — 위 네 기준이 그림 한 장에 들어 있다
맨 윗줄에 Llama · Gemma · DeepSeek · Qwen · GLM 등 지원 모델이 나열돼 있고(기준 ①), 그 아래 PyTorch · Triton · vLLM · SGLang · DeepSpeed · llm-d가 붙어 있다. 서빙 엔진이 벤더 중립적이라는 사실이 여기서 그림으로 확인된다 — vLLM이 AMD에서도 돌면 「CUDA라서 못 옮긴다」는 장벽이 낮아진다. 맨 아래는 Instinct(데이터센터)·Radeon(워크스테이션)·Ryzen AI(PC)로, 한 소프트웨어 스택으로 세 시장을 덮으려는 전략이다.
출처: www.amd.com© www.amd.com (교육 목적 인용)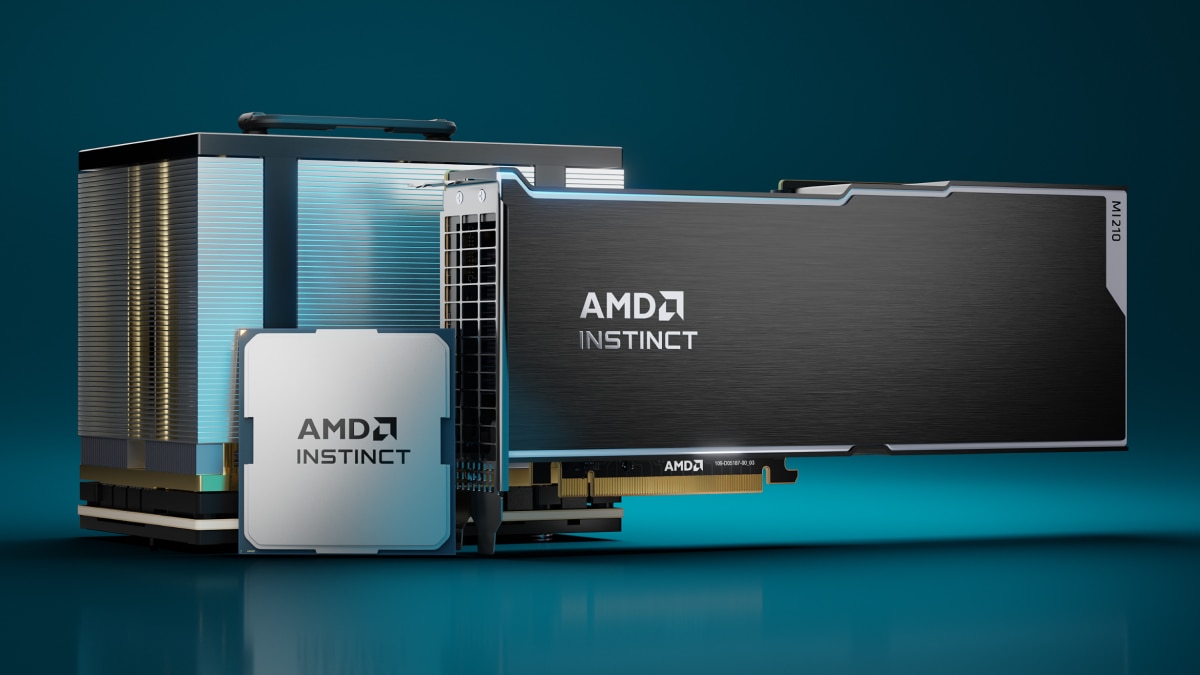
Instinct 가속기 — OAM 모듈(왼쪽)과 PCIe 카드(오른쪽) 제품 렌더
폼팩터가 두 가지라는 점이 보인다. PCIe 카드는 기존 서버에 꽂을 수 있어 도입이 쉽고, OAM 모듈은 보드에 직접 실어 더 많은 전력과 더 넓은 링크를 쓸 수 있다. 3장에서 본 「가속기가 손님에서 주인공으로」의 물리적 표현이며, 5장의 Helios 랙에 들어가는 것은 OAM 쪽이다.
출처: www.amd.com© www.amd.com (교육 목적 인용)도입을 검토한다면 ④번을 특히 눈여겨보라. 성능이 조금 낮은 것은 장비를 더 사면 되지만, 문제가 생겼을 때 원인을 못 찾으면 서비스를 못 올린다. 7장에서 국산 NPU를 평가할 때도 같은 기준이 적용된다.
OCP 개방형 랙 규격이 실제로 바꾸는 것
Helios가 OCP Open Rack Wide(ORW) 규격이라는 사실은 사양표의 한 줄로 보이지만, 실무에서는 꽤 큰 차이를 만든다.
| 항목 | 독자 규격 | OCP 개방형 규격 |
|---|---|---|
| 랙 제조 | 벤더 지정 또는 벤더 제조 | 여러 ODM이 같은 규격으로 만든다 |
| 전원 | 벤더 방식 | 랙 공통 전원 셸프 · 버스바 표준화 |
| 정비 | 벤더 부품 | 규격이 같으면 부품 호환 가능성 |
| 증설 | 같은 벤더로 계속 | 다른 벤더 장비를 같은 랙에 섞을 여지 |
| 데이터센터 설계 | 벤더 요구사항에 맞춤 | 규격이 공개돼 미리 설계 가능 |
특히 마지막 항목이 크다. 랙 규격이 공개돼 있으면 건물을 먼저 설계할 수 있다. 11장에서 볼 대로 데이터센터 공사는 리드타임이 수년이므로, 「장비를 정한 뒤 건물을 설계」하는 순서로는 늦는다.
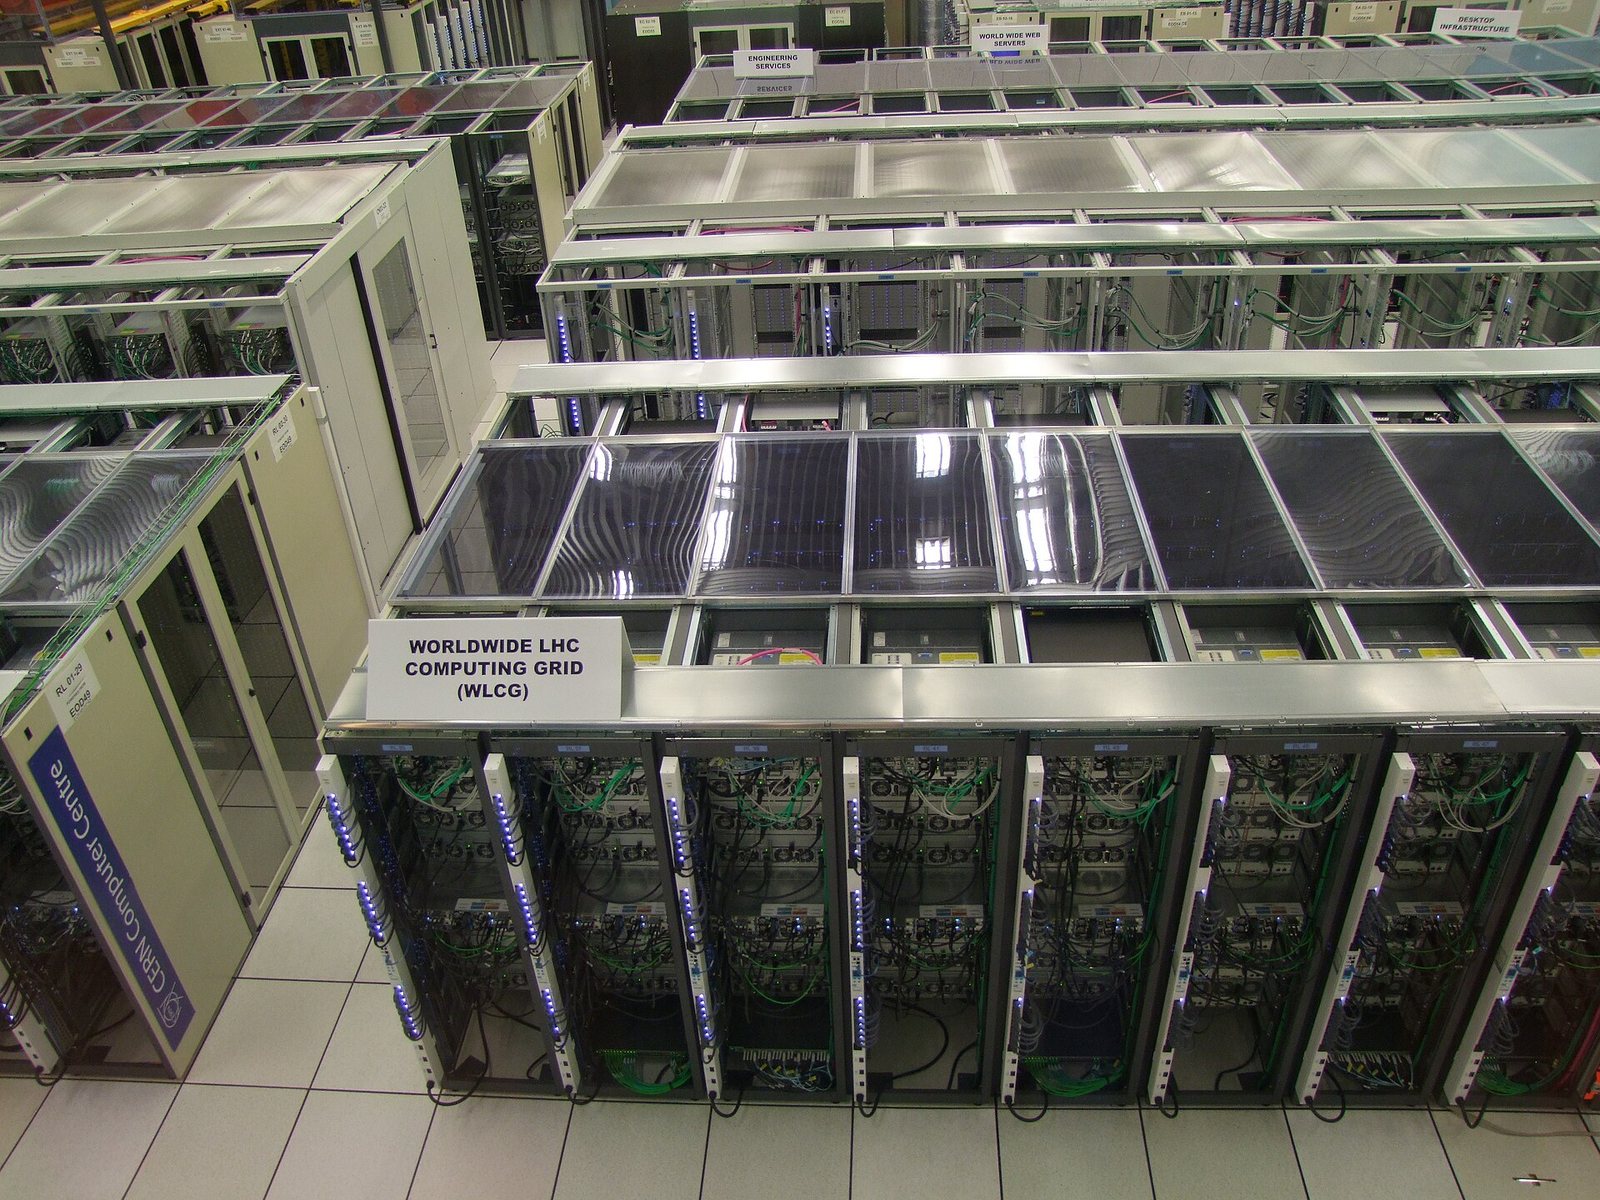
표준 규격 랙에 여러 벤더 장비가 섞여 있는 모습
LHC 컴퓨팅 그리드의 랙이다. 규격이 표준이면 이렇게 섞어 넣을 수 있다. AI 인프라에서 OCP가 노리는 그림이 이것이며, 고객 입장에서는 벤더 하나에 묶이지 않는다는 뜻이고 공급자 입장에서는 경쟁이 생긴다는 뜻이다.
출처: Marián HubinskýCC BY-SA 4.0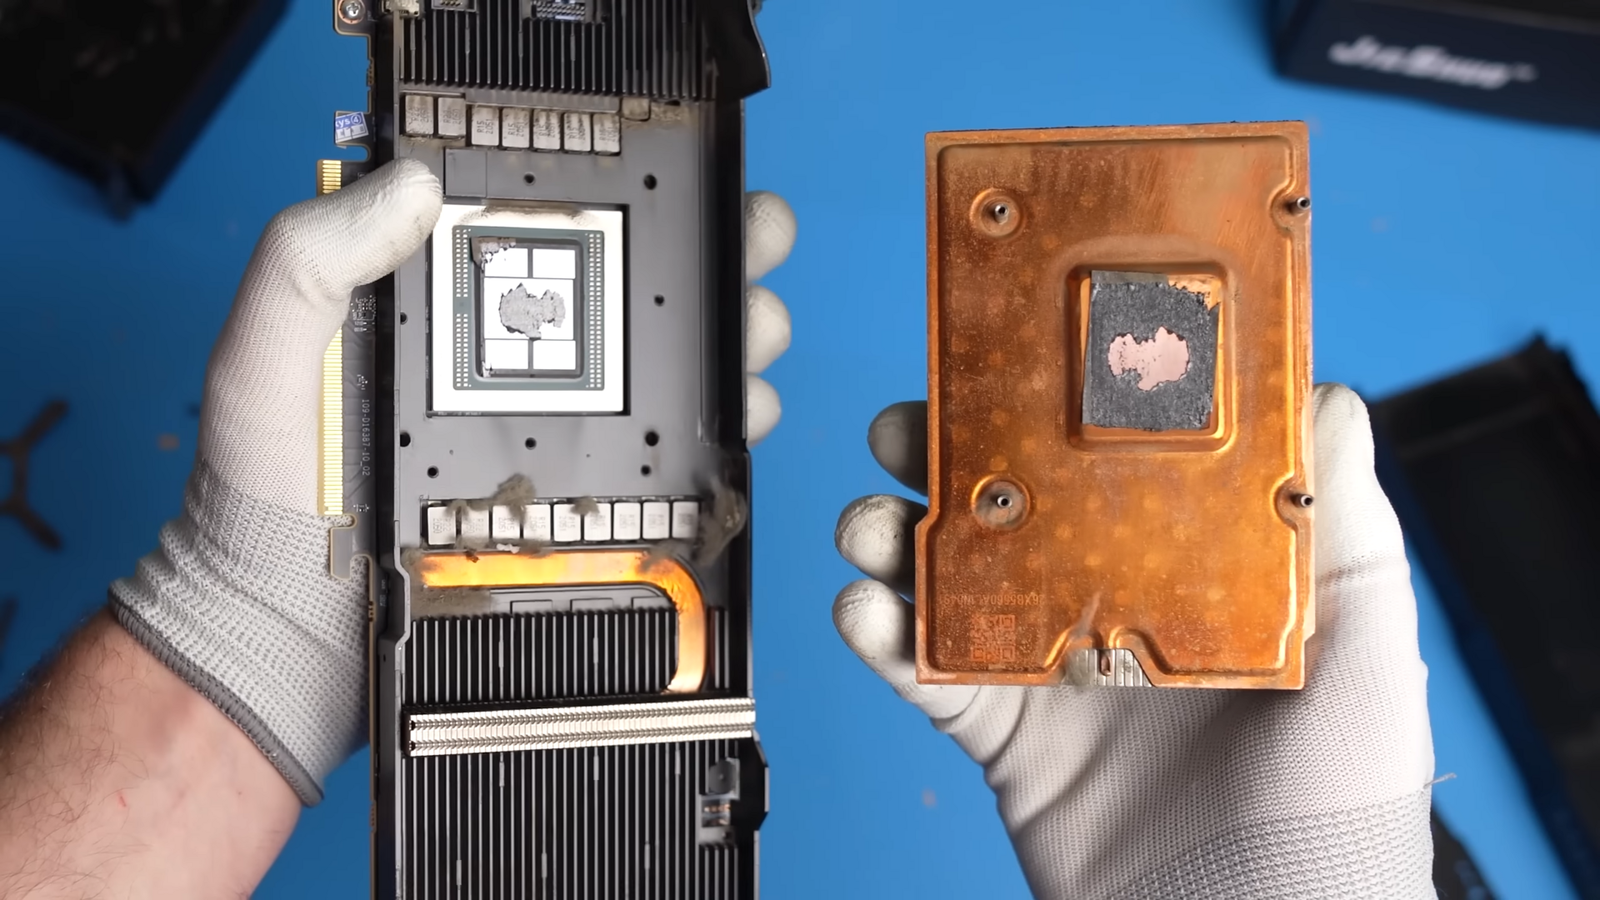
이전 세대 Instinct 가속기 실물
OAM이 아닌 PCIe 카드 형태였던 세대다. 폼팩터가 PCIe 카드에서 OAM 모듈로 바뀐 것 자체가 큰 변화인데, PCIe 슬롯의 전력·대역폭 한계를 벗어나 보드에 직접 실어 더 많은 전력과 더 넓은 링크를 쓸 수 있게 됐기 때문이다. 3장에서 본 「가속기가 손님에서 주인공으로」의 물리적 표현이다.
출처: Мой КомпьютерCC BY 3.0다만 개방형 규격이라고 해서 아무거나 섞을 수 있는 것은 아니다. 전력·냉각·기계적 규격이 맞아도 네트워크와 소프트웨어가 맞아야 실제로 한 시스템이 된다. 8장의 UALink 논의가 그 부분이다.
GW 단위 계약이 의미하는 것
AMD의 2026년 고객 구조는 이 산업이 어떤 단위로 움직이는지를 보여준다.
| 고객 | 규모 | 시점 |
|---|---|---|
| OpenAI | 6 GW | — |
| Meta | 6 GW | — |
| Anthropic | 2 GW | 2027년 상반기 시작 |
| Microsoft Azure | — | 2026년 하반기 |
| Oracle | — | — |
계약이 「GPU 몇 장」이 아니라 「몇 GW」로 표현된다는 것 자체가 1장의 AI 팩토리 관점을 뒷받침한다. 고객이 사는 것은 칩이 아니라 전력을 토큰으로 바꾸는 설비 용량이다.
감을 잡아 보자. 랙 하나가 200 kW라면 1 GW는 랙 약 5,000대다. GPU로 치면 36만 장 규모다. 그리고 이만한 전력을 한 부지에서 끌어올 수 있는 곳은 세계에 많지 않다 — 9장의 scale-across(사이트 간 연결)가 왜 필요해졌는지가 여기서 나온다.
GW 단위 계약은 대개 여러 해에 걸친 도입 총량이며, 구속력의 강도도 계약마다 다르다. 「올해 이만큼 출하된다」로 읽으면 안 된다. 수업에서 인용할 때는 발표 원문의 기간과 조건을 함께 확인할 것.
소프트웨어 — 진짜 격차가 있는 곳
하드웨어 사양은 표로 비교할 수 있지만, 실제 성능은 소프트웨어가 결정한다. 개방형 진영이 가장 힘을 쏟는 지점이기도 하다.
- ROCm 7 — CUDA에 대응하는 AMD의 런타임·라이브러리 스택.
- vLLM-ATOM — vLLM을 AMD 하드웨어에 최적화한 갈래. 13장에서 다룰 서빙 엔진이 벤더 중립적이라는 것이 개방형 진영에 유리하게 작용한다.
- MORI-IO — KV 캐시 전송 계층. NVIDIA의 NIXL에 대응한다(10장·13장).
- AITER 커널 — 어텐션 등 핵심 연산의 최적화 커널.
주목할 점은 추론 서빙 계층이 빠르게 벤더 중립으로 가고 있다는 것이다. vLLM·SGLang이 여러 하드웨어를 지원하면, 「CUDA라서 못 옮긴다」는 장벽이 낮아진다. 학습 쪽은 아직 격차가 크지만, 추론 쪽에서 개방형 진영이 먼저 발판을 얻고 있는 이유다.
실습 — 두 랙을 같은 저울에 올리기
목표: 동일한 워크로드를 가정하고 VR200 NVL72와 Helios를 비교하는 표를 만든다. 스프레드시트로 제출한다.
1단계 — 워크로드를 먼저 정한다
비교는 워크로드를 고정해야만 의미가 있다. 다음 중 하나를 골라 조건을 명시하라.
- (a) 400B급 MoE 모델을 FP8로 서빙, 동시 사용자 1,000명, TTFT 500ms 이하
- (b) 70B 모델 사전학습, 목표 학습 시간 30일
- (c) 긴 컨텍스트(128K) 문서 분석, 처리량 우선
2단계 — 비교표
| 항목 | VR200 NVL72 | Helios | 비교 근거·출처 |
|---|---|---|---|
| 랙당 가속기 수 | |||
| 랙당 HBM 총량 | |||
| 랙당 메모리 대역폭 합 | |||
| Scale-up 대역폭 (GPU당) | |||
| 랙 전력 (kW) | |||
| 선택한 워크로드에 필요한 랙 수 | |||
| 총 전력 (kW) | |||
| 연간 전력비 (원) | |||
| 장비 취득가 (추정) | |||
| tokens / $ (상대값) |
3단계 — 「30% 우위」 주장 검증
- AMD의 토큰당 비용 우위 주장은 어떤 전제 위에 서 있는가? (모델 크기, 정밀도, 배치, 전력 단가, 장비 가격 중 무엇을 가정했는가)
- 그 전제 중 하나를 바꾸면 결론이 뒤집히는가? 어느 것이 가장 민감한가?
- 여러분이 고른 워크로드에서는 어느 쪽이 유리한가? 왜 그런가?
- 표에서 가장 확신이 없는 칸은 어디인가? 그 불확실성이 결론을 바꾸는가?
장비 가격은 공개되지 않는 경우가 많다. 추정치를 쓰되 추정 근거와 오차 범위를 명시하고, 그 가정이 결론에 미치는 영향을 함께 적을 것. 「모르는 것을 모른다고 표시하는 것」도 평가 대상이다.
제출물
워크로드 정의 + 비교표(수식이 살아 있는 스프레드시트) + 검증 결과 서술 1장.
- 우리 학교가 100 GPU를 산다면 수직 통합과 개방형 중 어느 쪽인가? 규모가 답을 바꾸는가?
- ROCm이 CUDA를 따라잡는다는 것은 무엇을 의미하는가? 어디까지 따라잡으면 「따라잡았다」고 할 수 있는가?
- 개방형 규격이 성공한 역사적 사례(이더넷, PCIe)와 실패한 사례를 떠올려 보라. 무엇이 갈랐는가?
참고 자료
- AMD Advancing AI 발표 자료 — 1차 자료
- AMD Instinct MI350 시리즈 : 이 페이지 그림 출처
- UALink Consortium 규격 문서
- OCP Open Rack Wide (ORW) 규격
- ROCm 문서 및 vLLM AMD 지원 문서