클러스터 운영·관측·토큰 경제성
「3배 빠른 새 장비」가 정말 랙 수를 3분의 1로 줄여 주는가. 이 질문에 답하려면 성능 수치를 돈으로 환산해야 하고, 환산해 보면 장비 성능보다 가동률이 더 크게 작용한다는 것을 알게 된다.
이 장을 마치면
- MFU·Goodput 등 운영 지표를 정의하고 측정할 수 있다.
- tokens/$ · tokens/W 기준으로 세대 교체의 경제성을 계산할 수 있다.
- MLPerf 등 벤치마크 결과를 조건까지 포함해 비판적으로 읽을 수 있다.
- 학교 규모 AI 데이터센터의 운영비를 시나리오별로 모델링할 수 있다.
관측 — 무엇을 봐야 하는가
클러스터가 「잘 돌고 있다」를 판단하려면 무엇을 봐야 하는가? 대시보드에 흔히 뜨는 GPU 사용률은 생각보다 쓸모가 적다.
| 지표 | 어디서 | 주의할 점 |
|---|---|---|
| GPU 사용률 (util) | DCGM · nvidia-smi | SM이 명령을 실행 중인 비율일 뿐. 100%여도 연산 유닛은 놀 수 있다 |
| SM 점유율 · 텐서코어 활성도 | DCGM 상세 지표 | util보다 실체에 가깝다 |
| MFU | 직접 계산 | 달성 FLOPs ÷ 이론 피크. 학습 잡 평가의 표준 |
| HBM 대역폭 사용률 | DCGM | 디코드 워크로드에서는 이것이 핵심 지표 |
| 전력 · 온도 · 클럭 | DCGM | 스로틀링이 걸리면 성능이 조용히 떨어진다 |
| RAS 이벤트 · XID 오류 | 드라이버 로그 | 장애 예측과 Goodput 관리의 근거 |
그때 「GPU 사용률이 낮으면 노는 것인가?」라고 물었다. 답은 「아니다」였다. 그리고 반대도 성립한다 — 사용률 100%여도 연산 유닛은 대부분 놀 수 있다. 배치 1 디코드가 정확히 그 상황이다.
그래서 워크로드에 맞는 지표를 봐야 한다. 학습이면 MFU, 디코드 서빙이면 HBM 대역폭 사용률과 SLO 달성률이다.
대시보드를 여러 개 띄우는 것은 쉽다. 어려운 것은 그중 무엇을 벽에 걸 것인가다. 아래 세 장은 90년 간격의 관제실인데, 벽에 걸린 것의 종류가 같다.
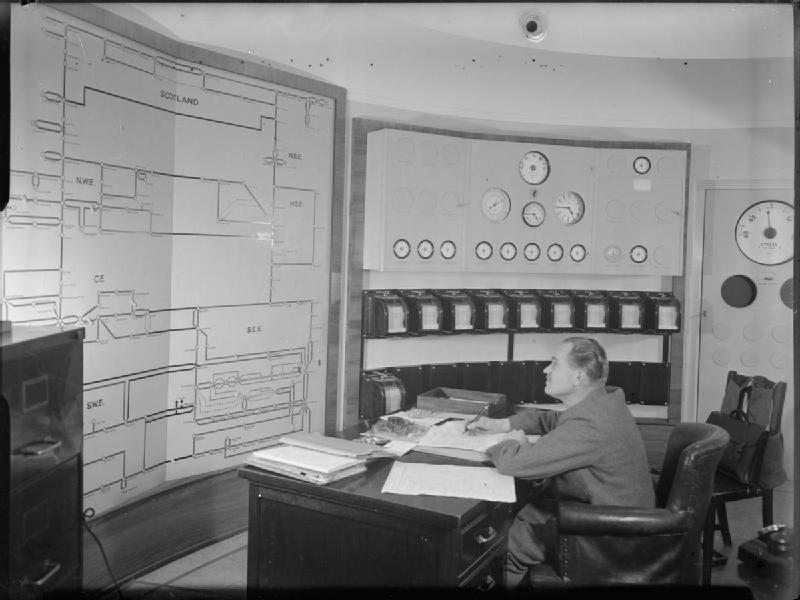
1930년대 — 영국 전력 계통 관제실
벽 왼쪽 절반이 스코틀랜드부터 남부까지의 송전 계통도이고, 오른쪽에 계기반과 표시등이 늘어서 있다. 그 앞 책상에 한 사람이 앉아 있다. 그림·표시등·기록지 — 즉 위상(topology), 상태(state), 이력(history) 세 가지다.
출처: Ministry of Information Photo Division PhotographerPublic domain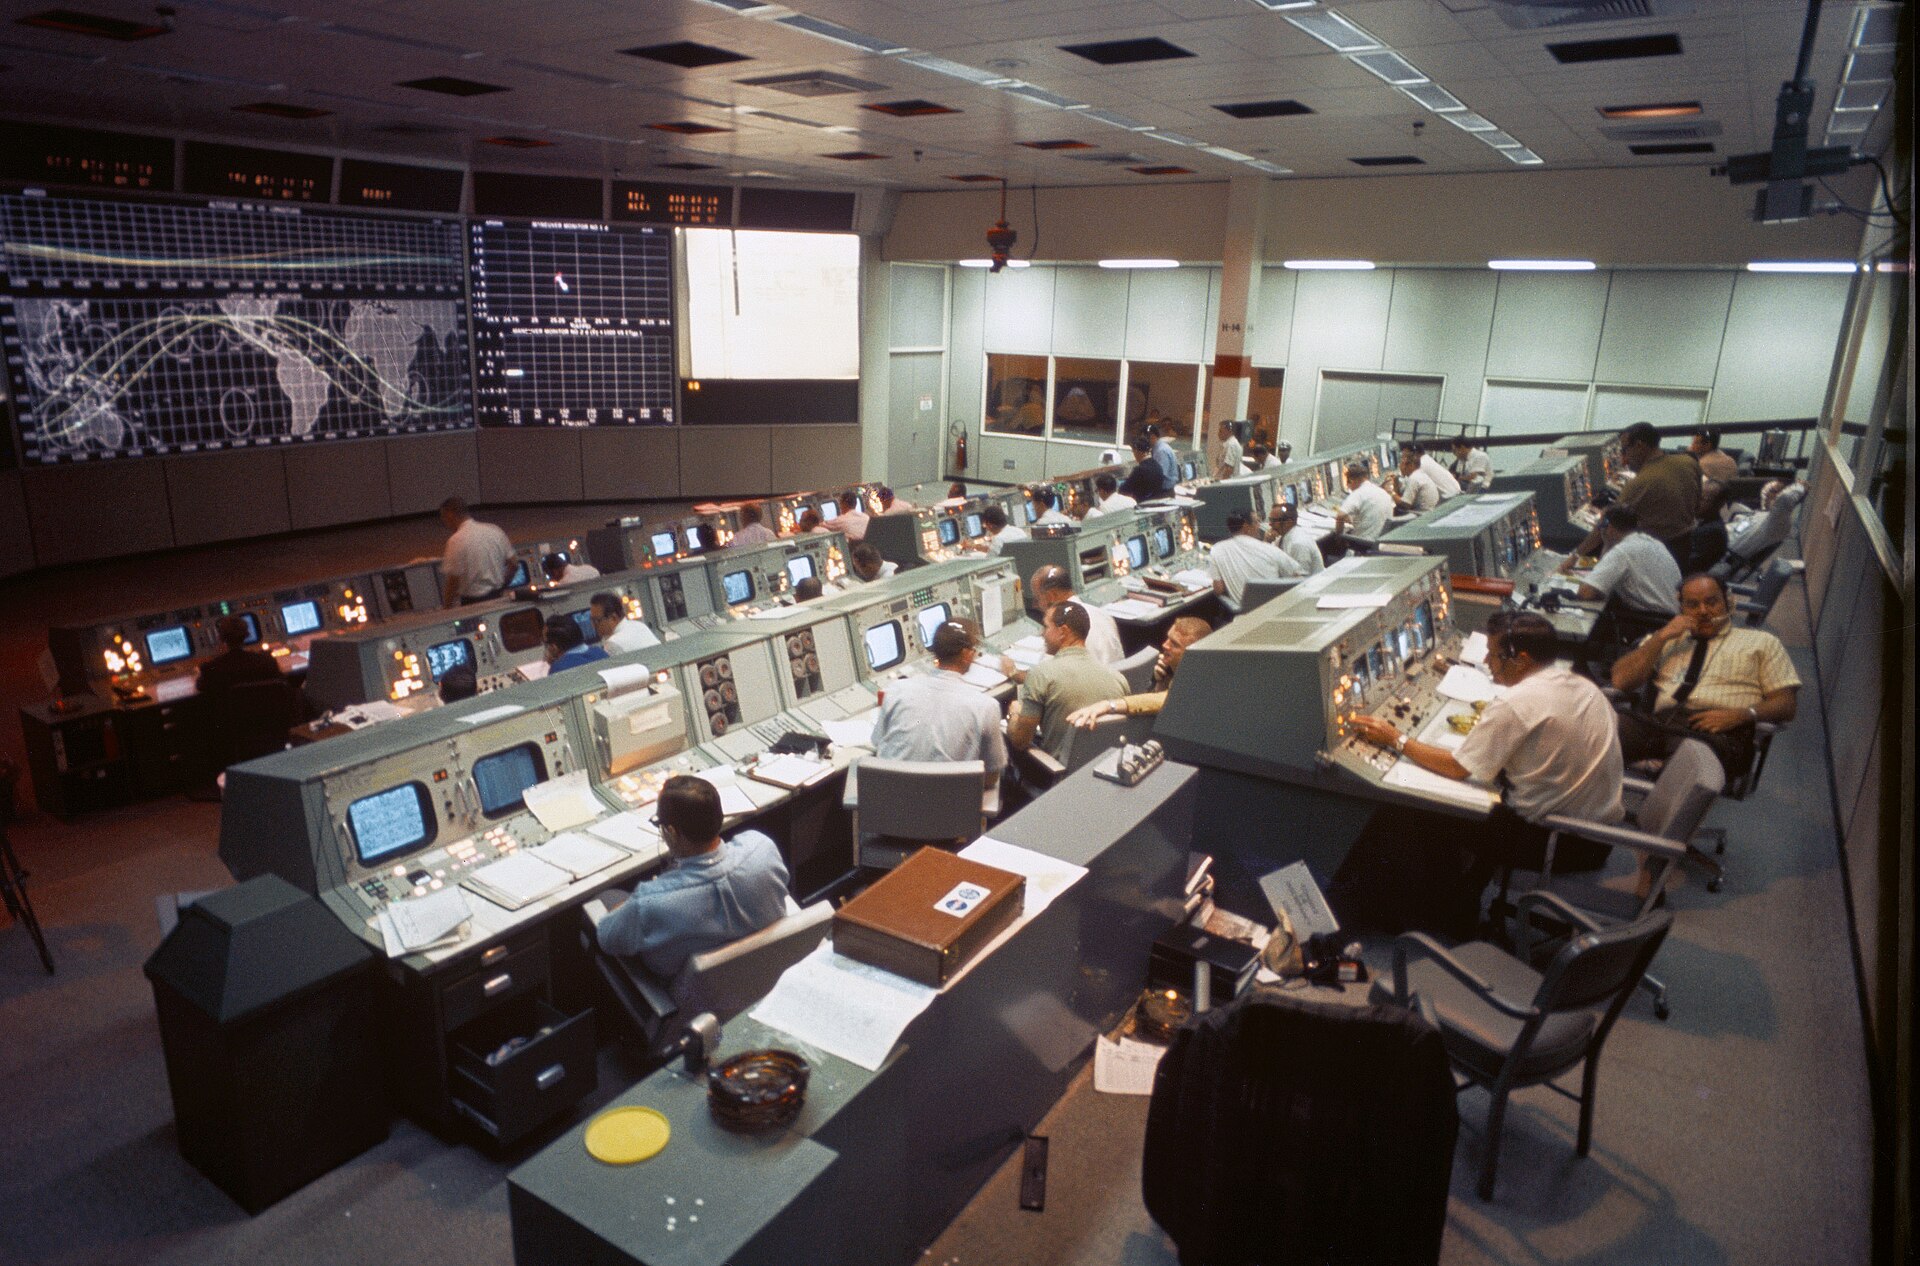
1968년 — 아폴로 7호 첫날의 NASA 관제실
콘솔이 네 줄로 늘어서고 각 자리에 작은 CRT 두어 대가 있다. 정면 벽에는 세계지도와 궤적, 그 옆에 큰 상태판이 걸려 있다. 자리마다 보는 것은 다르지만 벽은 모두가 같은 것을 본다 — 여기가 「지금 전체가 어떤가」의 자리다.
출처: NASA Johnson Space CenterPublic domain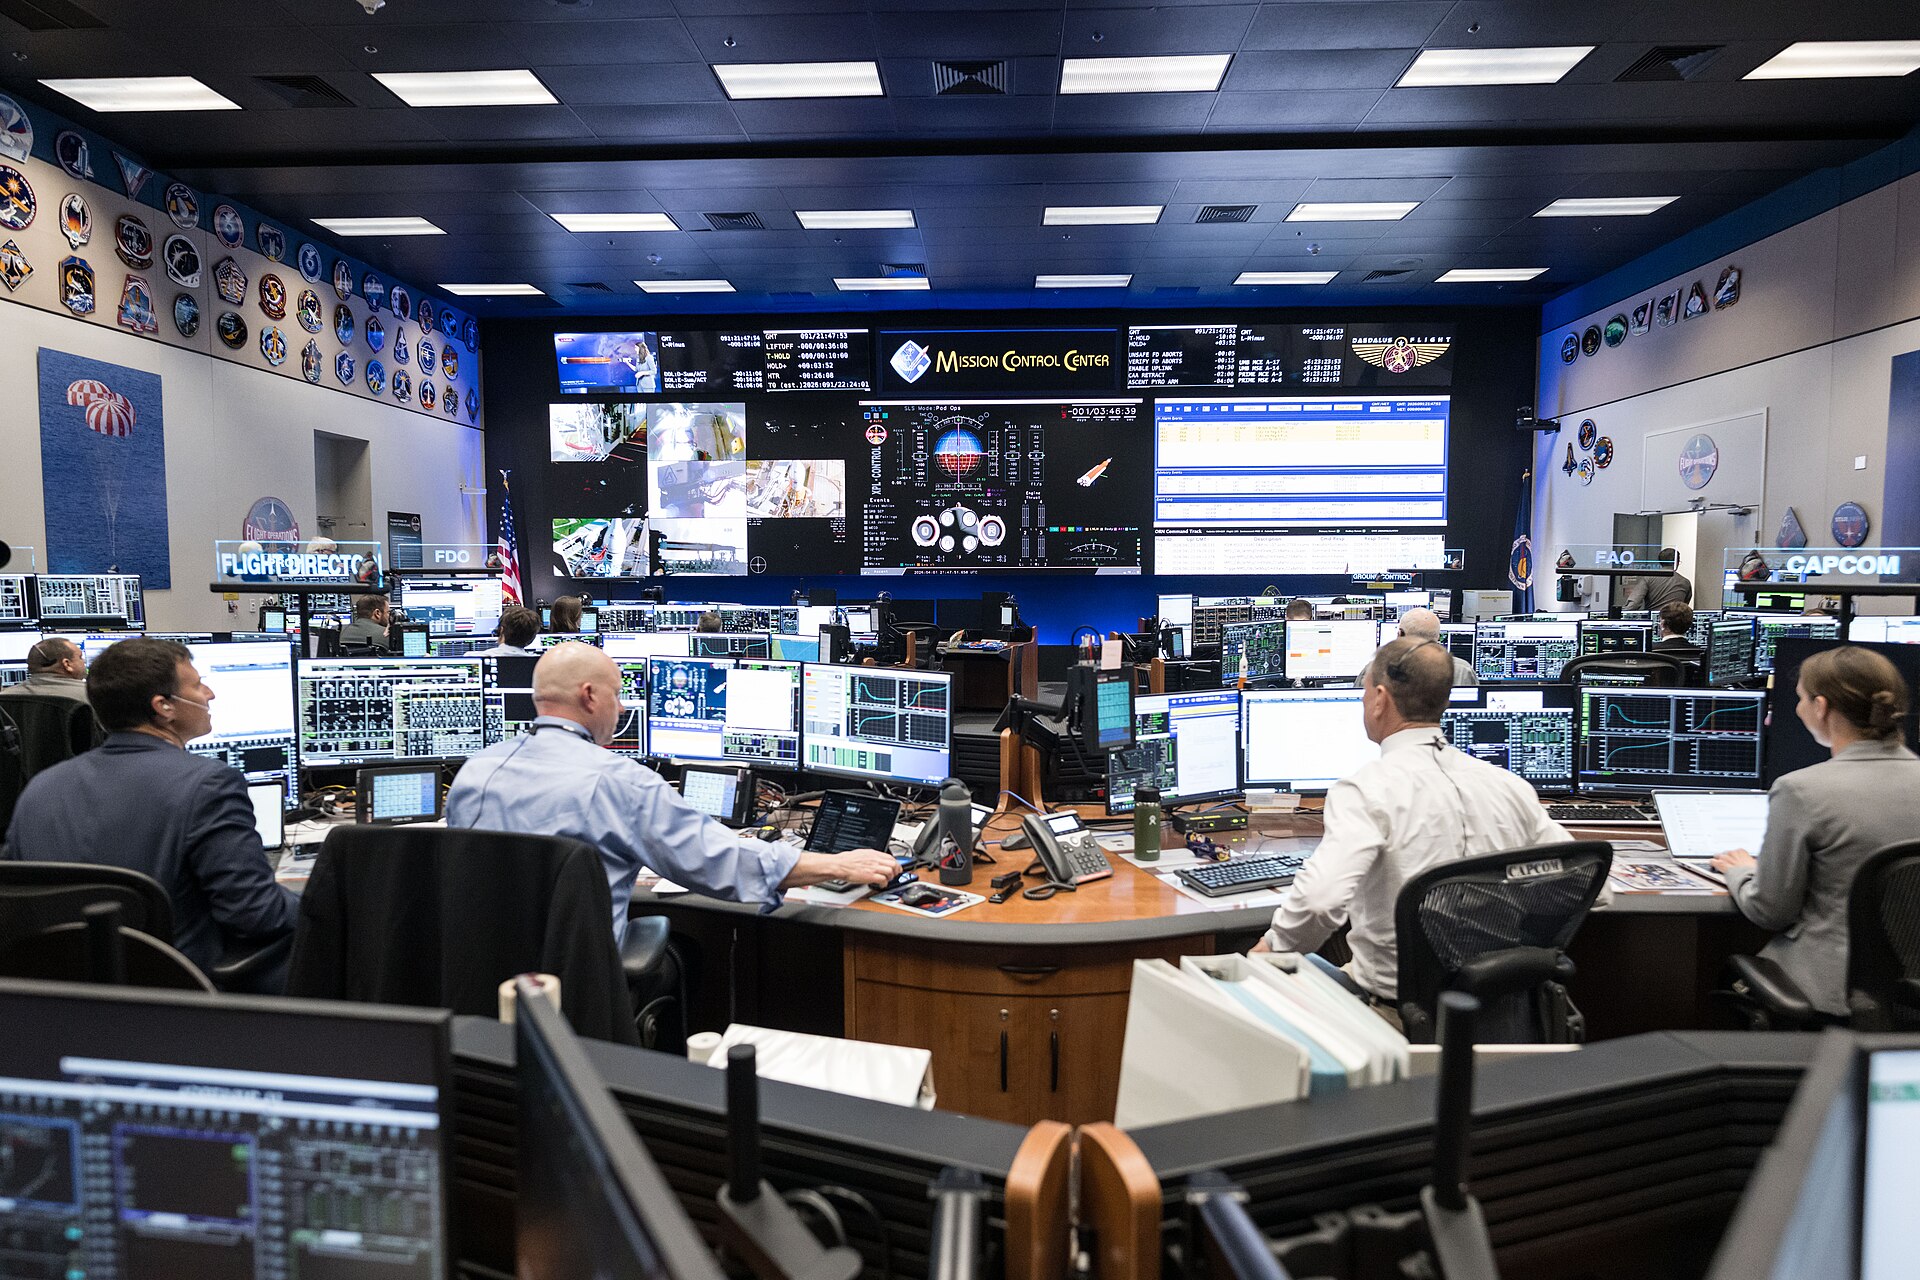
2026년 — 아르테미스 II 비행 관제팀
같은 방의 60년 뒤다. 자리마다 모니터가 네다섯 대로 늘었고 벽은 이제 하나의 큰 디스플레이인데, 그 안에 띄운 것은 여전히 궤적·상태표·타임라인 세 종류다. 가운데 「Mission Control Center」 표기 좌우로 계통 상태가, 양옆에 미션 패치들이 걸려 있다.
출처: NASA Johnson Space Center / Robert Markowitz - NASA - JSCPublic domain세 사진의 공통점을 그대로 옮기면 된다.
- 위상 — 무엇이 무엇에 연결돼 있는가. 우리 경우 노드·존·서비스 의존 그래프다.
- 상태 — 지금 정상인가. 초록/노랑/빨강이면 충분하고, 여기에 숫자를 잔뜩 넣으면 벽의 기능이 사라진다.
- 이력 — 언제부터 그랬는가. 사건은 값이 아니라 변화이므로 시간축이 있어야 한다.
개인 화면은 다르다. 벽이 「전체가 어떤가」라면 개인 화면은 「내가 지금 무엇을 하는가」다. 위 표의 지표 중 학습 클러스터라면 MFU 와 Goodput, 추론 서빙이라면 p99 지연과 SLO 위반율, 둘 다 전력과 온도를 여기에 둔다.
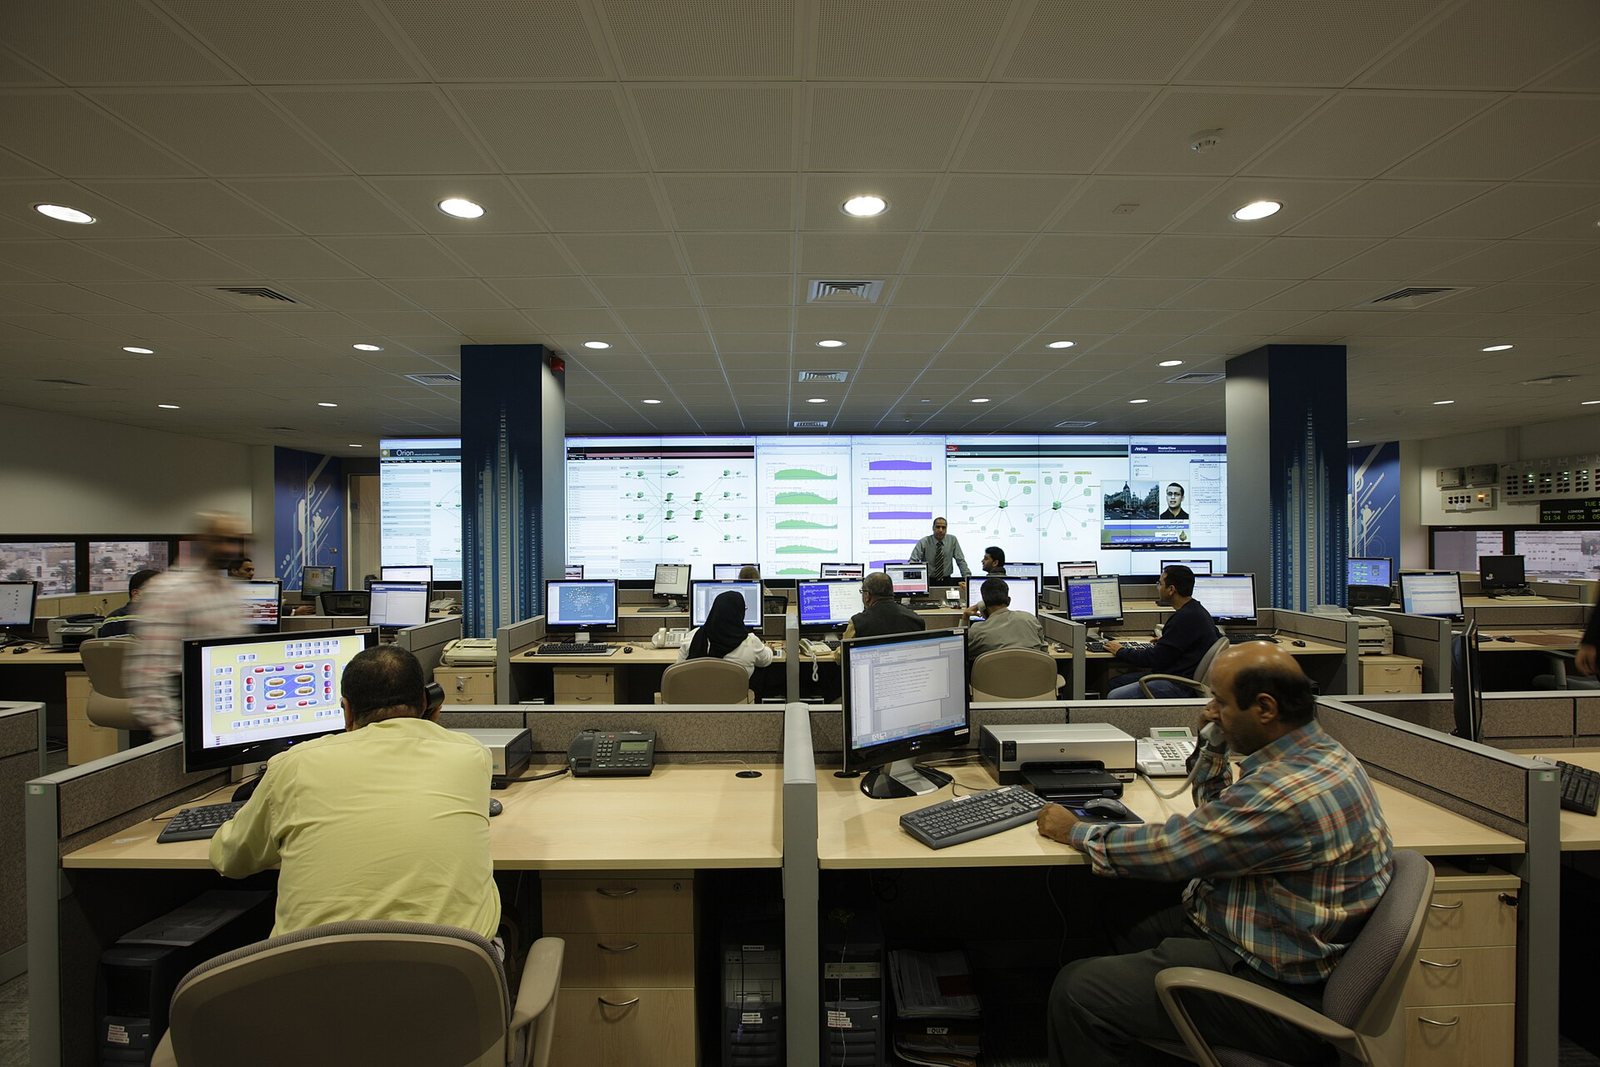
네트워크 관제실(NOC) — 24시간 지켜보는 곳
대형 화면에 전체 상태를, 개별 자리에서 상세를 본다. AI 클러스터 운영도 결국 같은 형태로 수렴한다 — 다만 보는 지표가 회선 상태가 아니라 GPU 활용률, 잡 진행률, SLO 위반율이다.
출처: MasdestructiveCC BY-SA 3.0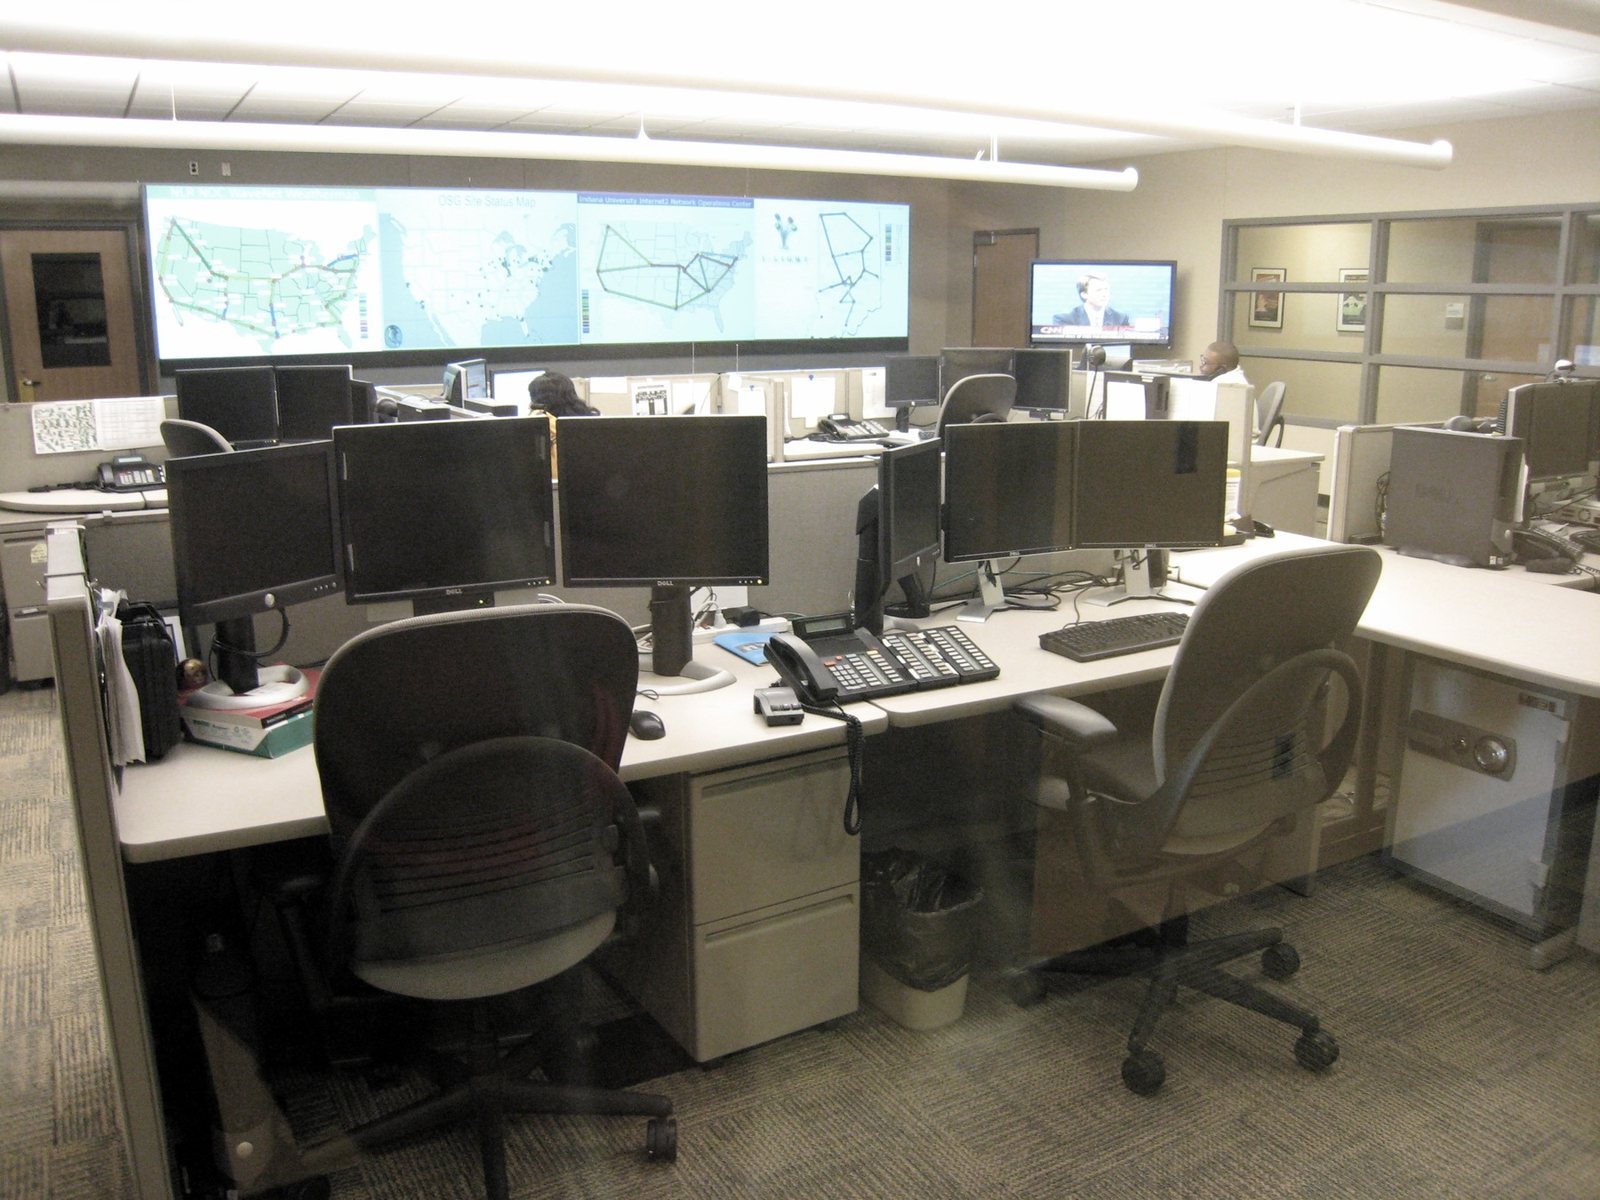
대학 기관의 관제실 — 자리가 비어 있다
벽에 미국 전역의 회선 지도가 걸려 있고 책상마다 모니터가 두세 대씩 놓였는데 의자가 전부 비어 있다. 앞의 Batelco 사진과 정확히 대비되는 지점이다. 상주 인력이 몇 명 안 되는 규모에서는 자동 알림 설계가 훨씬 중요하다. 사람이 화면을 계속 보는 것이 아니라, 「어떤 조건에서 누구에게 알릴 것인가」를 미리 정해 두는 방식으로 운영한다. 17장 설계서에 운영 인력 계획을 넣어야 하는 이유이기도 하다.
출처: Alan Levine from United StatesCC BY 2.0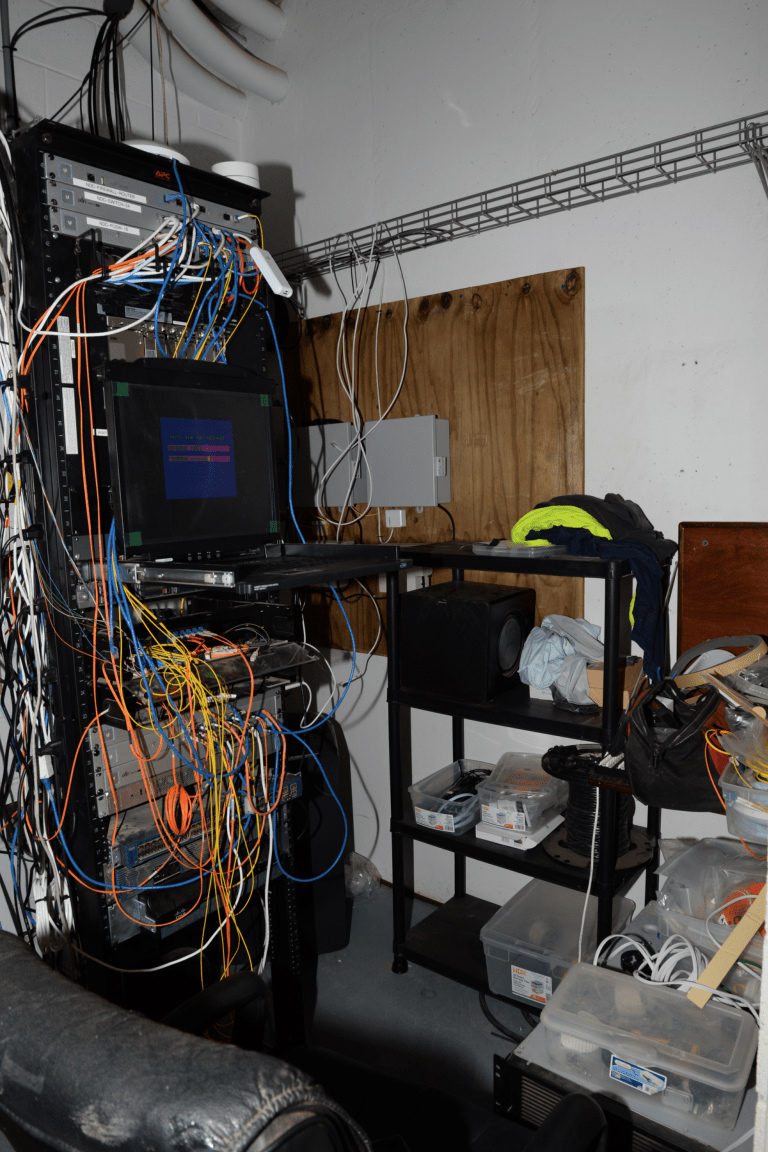
그 반대편 — 파랑·주황 케이블이 랙 앞면을 덮은 서버실
랙 앞면이 파랑·주황 케이블 다발에 통째로 덮여 있고, 그 앞 간이 선반에 플라스틱 수납함과 가방이 쌓여 있다. 벽에는 합판이 대어져 있고 모니터 한 대가 랙 사이에 끼어 있다. 케이블이 뒤엉키면 어느 것이 어디로 가는지 알 수 없고, 장애가 났을 때 원인을 찾는 데 몇 배의 시간이 걸린다. 앞면이 막혔으니 기류도 막혀 냉각이 나빠진다. 이 과목에서 계산한 모든 성능 수치는 「제대로 설치했을 때」를 전제하며, 그 전제가 깨지면 계산은 의미가 없다. 17장 설계 프로젝트에서 배선·정비 동선을 언급하는 것이 감점이 아니라 가점인 이유다.
출처: Federal Bureau of InvestigationPublic domainGPU를 나눠 쓰기
- MIG (Multi-Instance GPU) — 하나의 GPU를 하드웨어 수준에서 격리된 조각으로 나눈다. 여러 사용자의 작은 잡을 안전하게 태울 때.
- 시분할 공유 · MPS — 격리는 약하지만 유연하다.
- 교육 기관에서는 수업용 소규모 잡이 대부분이므로 분할이 가동률을 크게 올린다. 아래 경제성 계산과 직결된다.
장애를 전제로 한 운영
수만 개의 부품으로 이루어진 시스템에서 아무것도 고장 나지 않는 시간은 없다. 운영의 목표는 「고장을 막는 것」이 아니라 「고장이 나도 서비스와 학습이 계속되게 하는 것」이다.
| 무엇이 고장 나나 | 얼마나 자주 | 증상 | 대응 |
|---|---|---|---|
| GPU 메모리 오류 | 가장 흔하다 | ECC 정정 가능 오류 → 누적되면 교체 신호 | DCGM으로 추세 감시, 임계 넘으면 사전 교체 |
| GPU 자체 실패 | 수천 장 규모에서 주 단위 | XID 오류, 잡 크래시 | 노드 격리 후 체크포인트에서 재시작 |
| 광 트랜시버 · 케이블 | 개수에 비례 | 링크 다운 또는 성능만 저하 | 성능 저하형이 특히 찾기 어렵다 — 링크 오류율 감시 |
| 전원 · 냉각 | 드물지만 영향이 크다 | 랙 단위 정지 | 이중화, 그리고 도메인 분할 설계 |
| 소프트웨어 행(hang) | 생각보다 잦다 | 잡이 멈춰 있는데 죽지도 않는다 | 워치독, 진행 상황 기반 타임아웃 |
완전히 죽는 고장은 오히려 다루기 쉽다. 감지되고, 격리하고, 재시작하면 된다.
낙오 노드(straggler) — 한 노드만 느려지는 경우가 훨씬 어렵다. 동기 학습에서는 전체가 그 노드를 기다리므로 클러스터 전체 속도가 그 노드에 맞춰진다. 원인은 링크 오류로 인한 재전송, 열 스로틀링, 다른 잡의 간섭 등 다양하고, 증상만 봐서는 어느 노드인지도 알기 어렵다.
대책은 노드별 스텝 시간을 항상 기록해 두는 것이다. 분포에서 튀는 노드가 보이면 즉시 격리한다. 관측 없이는 이런 고장을 찾을 수 없다 — 앞 절의 관측 지표가 필요한 실제 이유다.
Goodput을 실제로 계산해 보기
한 달(720시간) 동안 4,096 GPU 클러스터를 돌렸다고 하자.

  예약된 시간                       720 h
  - 계획 정비                      -  8 h
  - 장애로 인한 정지               - 22 h
  - 체크포인트 쓰기 (동기 부분)    -  6 h
  - 재시작 후 되감기로 날린 시간   - 14 h
  - 낙오 노드로 인한 감속 손실     - 30 h  (환산)
  ─────────────────────────────────────────
  유효 학습 시간                    640 h
  Goodput = 640 / 720 ≈ 89 %

  같은 조건에서 Goodput 이 70% 라면?
  → 장비를 27% 더 사는 것과 같은 효과. 운영 개선이 곧 예산이다.
여러 사용자가 나눠 쓰는 클러스터
학교나 연구기관의 클러스터는 대개 여러 팀이 나눠 쓴다. 이때 생기는 문제는 기술이 아니라 정책에 가깝다.
| 문제 | 증상 | 대응 수단 |
|---|---|---|
| 독점 | 한 사람이 전체를 몇 주 동안 잡고 있다 | 잡 시간 상한, 큐 우선순위, 공정 공유(fair-share) |
| 낭비 | GPU를 잡아 놓고 실제로는 안 쓴다 | 사용률 감시 후 자동 회수, 유휴 타임아웃 |
| 파편화 | 작은 잡들이 흩어져 큰 잡이 들어갈 자리가 없다 | 백필(backfill) 스케줄링, 예약(reservation) |
| 소규모 잡 과다 | GPU 한 장도 다 못 쓰는 잡이 대부분 | MIG 분할 — 한 장을 여러 조각으로 |
| 우선순위 다툼 | 수업 · 연구 · 외부 과제가 경합 | 파티션 분리, 시간대별 정책 |
수업용 실습은 짧고 작고 예측 가능한 잡이 대부분이다. GPU 한 장을 통째로 주면 대부분의 시간이 낭비된다.
MIG로 한 장을 4~7개로 나누면 같은 장비로 훨씬 많은 학생을 받을 수 있다. 아래 경제성 계산에서 「가동률」이 지배적이라는 것을 보게 되는데, 교육 기관에서 가동률을 올리는 가장 확실한 수단이 이 분할이다.
그리고 연구용 큰 잡과 수업용 작은 잡을 시간대로 분리하는 것도 효과가 크다. 수업 시간에는 분할 모드로, 야간과 주말에는 통짜로 — 이런 정책이 실제로 쓰인다.
토큰 경제성 — 성능을 돈으로 환산하기
랙 한 대의 연간 비용과 토큰 생산량으로 단가를 구하는 구조. 숫자는 예시다.
직접 제작 도해 · 자유 사용「3배 성능 = 랙 수 1/3」이 성립하려면
새 세대가 3배 빠르다는 발표를 보고 랙 수를 3분의 1로 줄일 수 있다고 계산하는 것은 위험하다. 다음 조건이 전부 맞아야 성립한다.
- 그 3배가 내 워크로드에서도 3배인가 — 정밀도·모델·배치가 발표 조건과 같은가?
- 랙 전력도 3배가 안 늘었는가 — 성능이 3배인데 전력도 3배면 전력비는 그대로다.
- 부하가 그만큼 있는가 — 랙을 3분의 1로 줄여도 그 랙을 꽉 채울 수요가 있어야 한다.
- 그 사이 다른 것이 병목이 되지 않는가 — GPU가 3배 빨라지면 스토리지·네트워크가 먼저 막힐 수 있다.
tokens/s 는 비교 지표가 아니다. 반드시 tokens/$ 또는 tokens/W로 환산해야 한다. 칩 수와 전력을 밝히지 않은 tokens/s 는 「돈을 얼마든 써도 된다면」이라는 전제가 숨어 있다.
7장에서 추론 특화 하드웨어를 볼 때 이미 같은 말을 했다. 여기서 그것을 계산으로 확인한다.
벤치마크 읽는 법
MLPerf는 현재 가장 신뢰할 만한 공개 벤치마크다. 조건이 규정돼 있고, 결과가 검증을 거치며, 제출 구성이 공개된다.
| 무엇을 재는가 | 읽을 때 확인할 것 | |
|---|---|---|
| MLPerf Training | 정해진 모델을 목표 정확도까지 학습하는 시간 | 몇 개의 가속기를 썼는가 — 시간만 보면 안 된다 |
| MLPerf Inference | 정해진 SLO 아래에서의 처리량 | Closed(모델 고정)인가 Open(변형 허용)인가 |
| 벤더 자체 측정 | 자사 유리한 조건 | 기준선이 무엇인가 · 정밀도 · 배치 · 희소성 가정 |
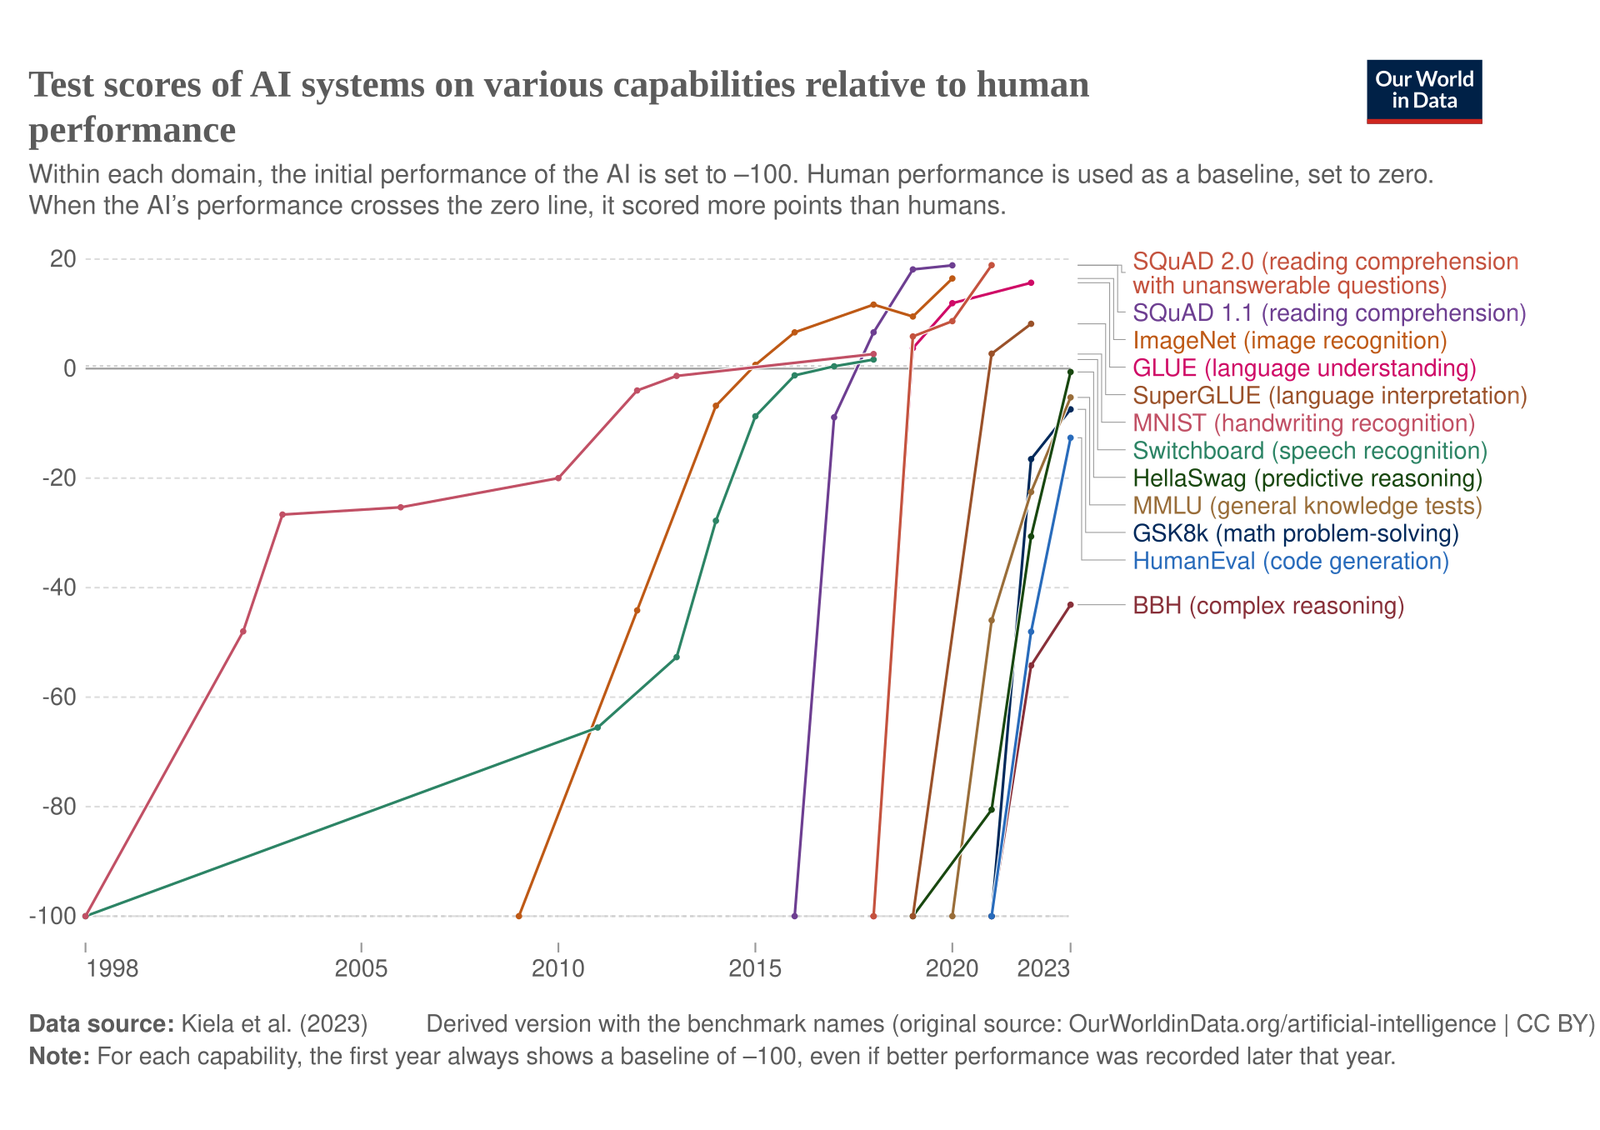
벤치마크 점수의 시간 추이 — 이런 그래프를 읽는 법
세로축이 무엇인지, 기준선(사람 성능 등)이 어떻게 정의됐는지, 같은 조건에서 잰 것인지를 먼저 확인해야 한다. 특히 벤치마크가 학습 데이터에 섞였을 가능성(오염)은 이런 그래프에서 잘 드러나지 않는다. 성능 주장은 항상 「무엇을 어떻게 쟀는가」와 함께 읽어야 한다.
출처: AlenoachCC BY 4.0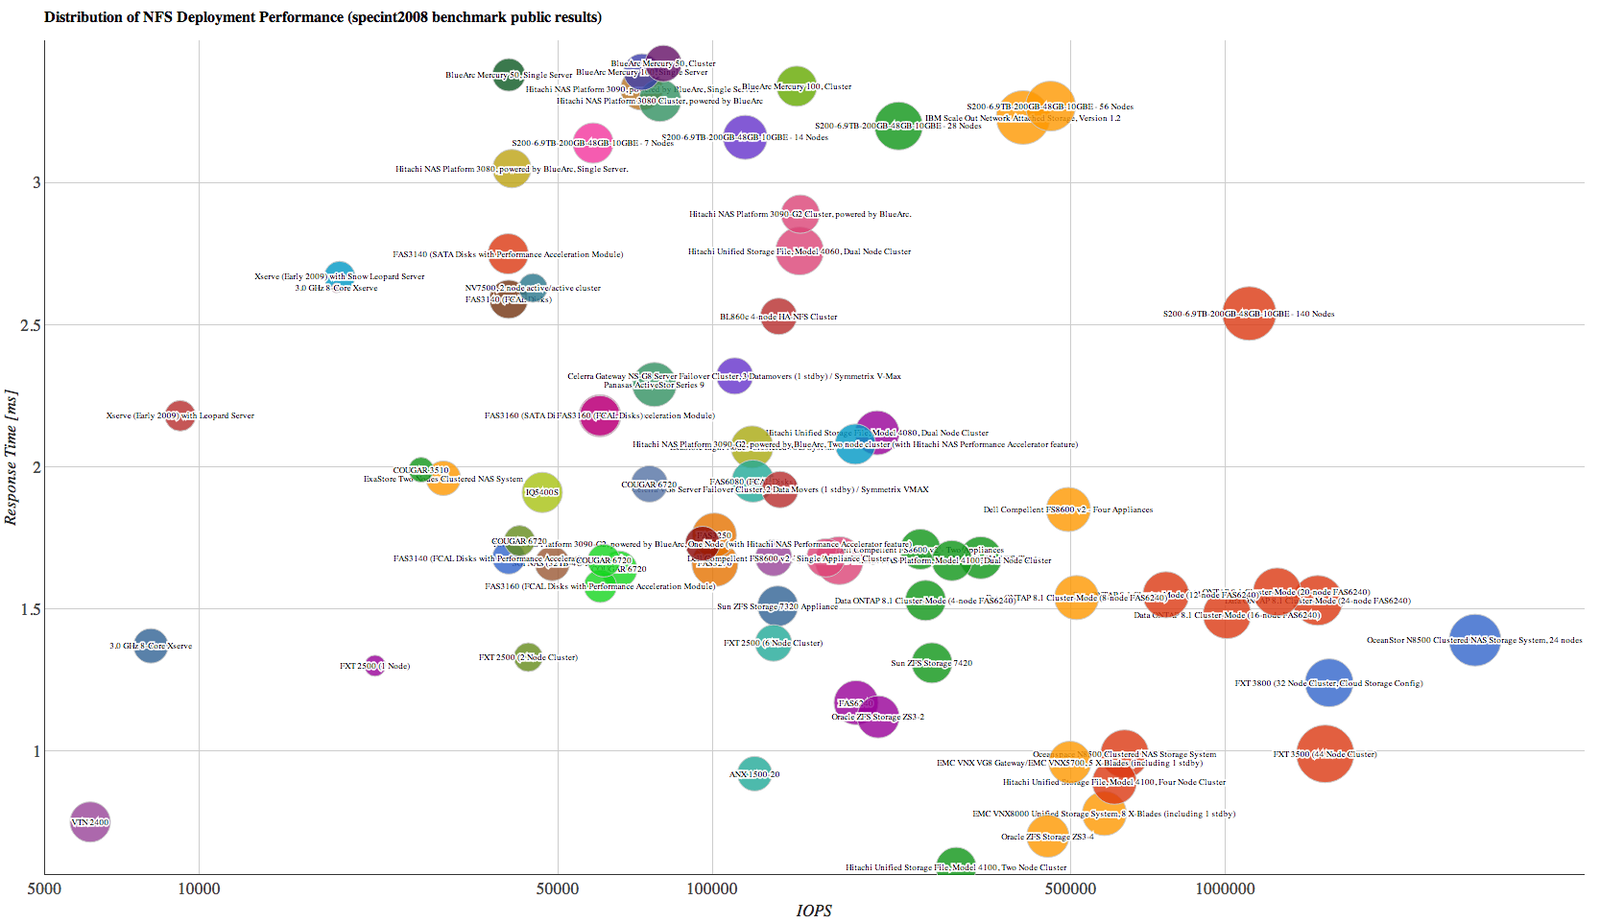
성능 측정 그래프의 전형 — 부하를 올리며 응답을 기록
가로축 부하, 세로축 응답 시간. 14장에서 본 포화 곡선과 같은 모양이 나온다. 어느 지점에서 꺾이는지가 그 시스템의 실제 용량이며, 이런 그래프를 직접 그려 보는 것이 벤더 수치를 검증하는 가장 확실한 방법이다.
출처: Kyle.R.DunnCC BY-SA 3.0체크리스트 — 어떤 성능 수치를 만나든
- 무엇 대비 몇 배인가? 기준선이 구세대인가, 경쟁사인가, 최적화 전인가?
- 정밀도는? FP4와 FP8을 비교하면 당연히 2배가 나온다.
- 희소성(sparsity)을 가정했는가? 가정하면 숫자가 2배가 된다.
- 칩 단위인가 랙 단위인가? 랙에 칩이 더 많으면 랙 성능은 당연히 높다.
- SLO 조건이 있는가? 지연 제약 없이 잰 처리량은 서비스에 쓸 수 없다.
- 전력과 칩 수가 명시되어 있는가? 없으면 tokens/W를 계산할 수 없다.
Hot Chips 등에서 제3자 추론 벤치마크의 방법론을 두고 논쟁이 벌어지는 것은 위 항목들에 대한 합의가 아직 없기 때문이다. 수치를 못 믿겠다는 뜻이 아니라, 조건을 함께 읽어야 한다는 뜻이다.
실습 — 우리 학교 미니 AI데이터센터 운영비 모델링
목표: 학교 규모의 AI 데이터센터 운영비를 시나리오별로 모델링하고, 무엇이 단가를 지배하는지 확인한다. 17장 설계 프로젝트의 재무 근거가 된다.
1단계 — 전제 정하기
| 항목 | 값 | 근거 |
|---|---|---|
| 도입 장비 · 수량 | ||
| 취득가 (추정) | ||
| 감가상각 기간 | ||
| 랙 전력 (kW) | ||
| PUE | ||
| 전기 요금 (원/kWh) | 실제 학교 요금제 확인 권장 | |
| 상면 · 인건 · 유지보수 |
2단계 — 시나리오
가동률과 워크로드 구성을 바꿔 가며 100만 토큰당 단가를 계산한다.
| 시나리오 | 가동률 | 주 워크로드 | 연간 비용 | 연간 토큰 | 100만 토큰당 |
|---|---|---|---|---|---|
| A · 수업 시간만 | 20 % | 실습·소규모 추론 | |||
| B · 연구실 상시 | 50 % | 학습 + 추론 혼합 | |||
| C · 대외 서비스 포함 | 85 % | 추론 위주 |
3단계 — 민감도 분석
아래 항목을 각각 ±30% 바꿨을 때 단가가 몇 % 움직이는지 계산해 표로 만들어라. 가장 민감한 항목이 여러분이 관리해야 할 것이다.
- 장비 취득가
- 전기 요금
- 가동률
- PUE
- 모델 처리량(양자화·최적화 효과)
4단계 — 상용 API와 비교
- 같은 모델급의 상용 API 가격과 비교하면 어느 시나리오에서 자체 운영이 유리한가?
- 자체 운영이 유리해지는 손익분기 가동률은 몇 %인가?
- 그 가동률을 실제로 달성할 수 있는가? 어떻게 하면 올릴 수 있는가? (MIG 분할, 야간 배치 작업, 교외 개방 등)
- 돈으로만 따질 수 없는 요소는 무엇인가? (데이터 주권, 교육 목적, 연구 자유도) 그것을 의사결정에 어떻게 반영하겠는가?
제출물
수식이 살아 있는 스프레드시트 + 민감도 표 + 결론 1장. 모든 가정에 출처나 근거를 달 것.
- 가동률을 올리는 것과 장비를 좋은 것으로 바꾸는 것 중 어느 쪽이 쉬운가? 왜 사람들은 후자를 먼저 생각하는가?
- GPUaaS 사업(국내 2조 원 규모)의 수익 모델을 이 계산으로 설명해 보라. 그들은 무엇으로 돈을 버는가?
- 「우리도 GPU를 사야 한다」는 요구에 대해, 이 장의 내용으로 어떤 질문을 되던지겠는가?
참고 자료
- MLCommons — MLPerf Training · MLPerf Inference
- NVIDIA DCGM 문서 — 클러스터 관측 지표
- SemiAnalysis — AI 데이터센터 TCO 분석
- 과기정통부 · NIPA GPUaaS 사업 공고 — 국내 사업 모델 사례