가속기 마이크로아키텍처와 메모리
1장에서 「디코드는 대역폭에 묶인다」는 것을 봤다. 그렇다면 칩 설계자는 무엇을 할 수 있는가? 선택지는 세 가지뿐이다 — 연산 유닛을 늘리거나, 메모리를 넓히거나, 읽어야 할 바이트 자체를 줄이거나. 2026년의 주요 제품은 이 셋 중 어디에 걸었는지가 전부 다르다.
이 장을 마치면
- 시스톨릭 어레이가 왜 행렬 곱셈에 유리한지, 텐서코어/MXU가 그 변형인 이유를 설명할 수 있다.
- FP32부터 FP4까지 수치형식의 비트 구성을 읽고, 블록 스케일링(MXFP4·NVFP4)의 차이를 말할 수 있다.
- HBM의 구조와 대역폭이 나오는 원리, 온칩 SRAM과의 역할 분담을 설명할 수 있다.
- 칩렛·2.5D/3D 패키징이 왜 필수가 되었는지 공정 미세화의 한계와 연결해 설명할 수 있다.
- 주요 벤더가 「용량 · 대역폭 · SRAM」 중 무엇에 걸었는지 비교표로 정리하고 근거를 댈 수 있다.
연산 코어 — 시스톨릭 어레이라는 오래된 아이디어
LLM 연산의 대부분은 행렬 곱셈이다. 행렬 곱셈만 잘하면 되는 하드웨어를 만들려면 어떻게 해야 하는가? 답은 1970년대에 이미 나와 있었다 — 시스톨릭 어레이다.
핵심 아이디어는 간단하다. 연산 유닛을 격자로 늘어놓고, 데이터를 격자 사이로 흘려보내면서 각 유닛이 지나가는 값을 곱하고 더한다. 값이 유닛에서 유닛으로 직접 전달되므로 중간 결과를 메모리에 쓸 필요가 없다. 1장의 언어로 말하면, 연산 강도를 하드웨어 구조로 끌어올리는 것이다.
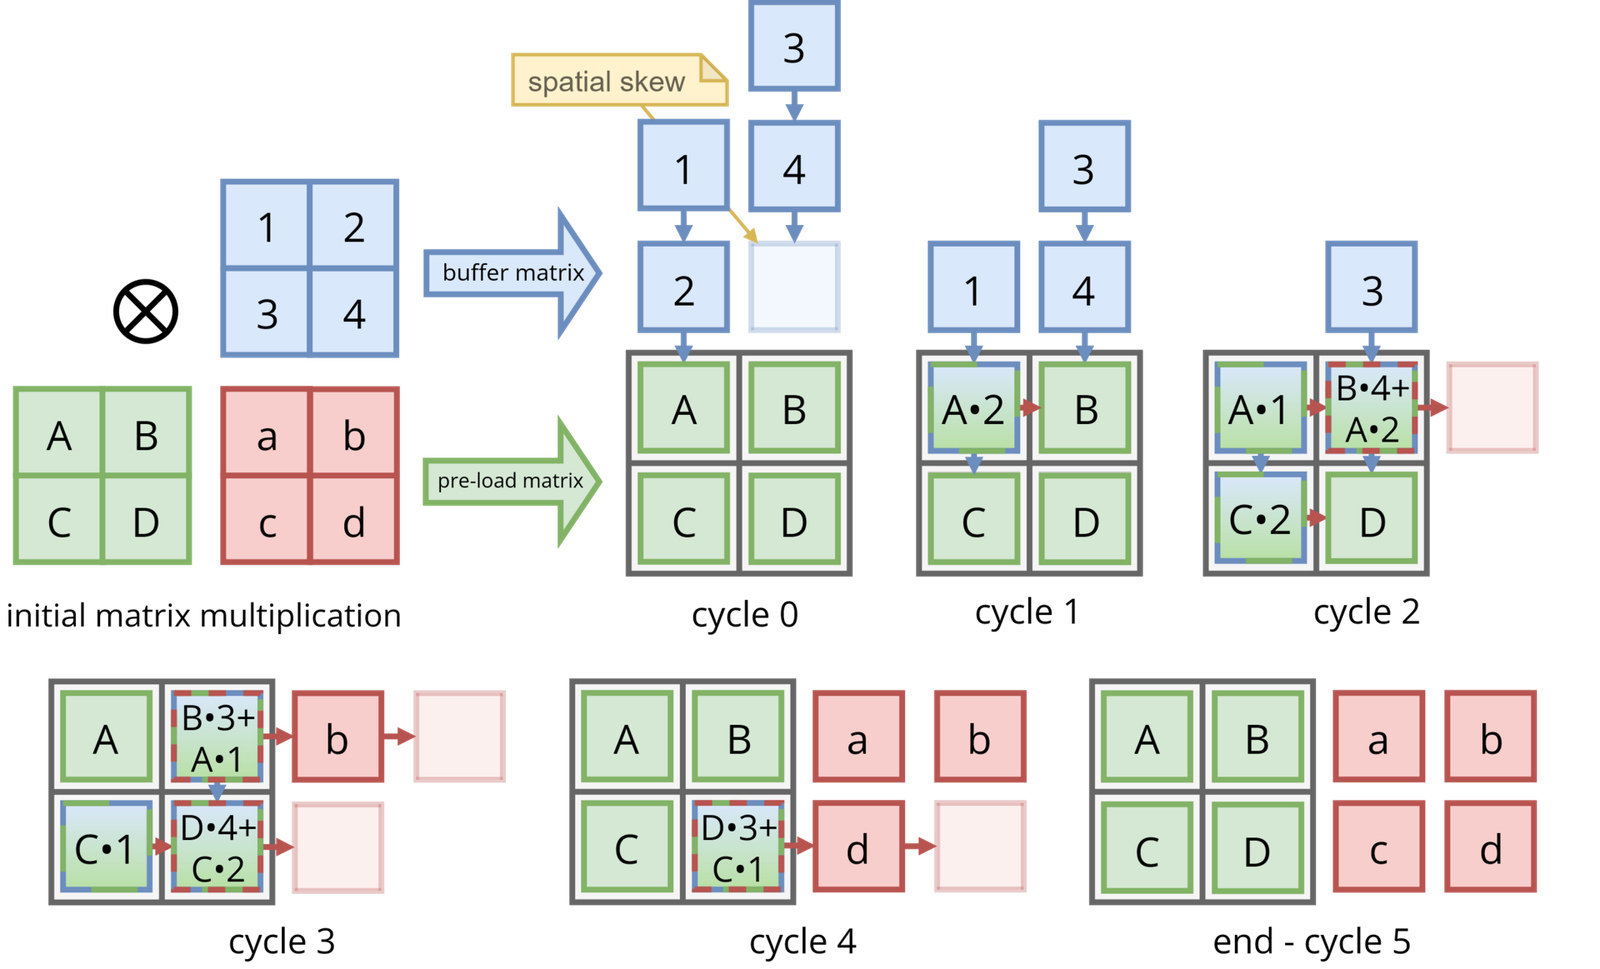
가중치 고정(weight stationary) 방식. 가중치를 격자에 미리 실어두고 활성값을 흘려보낸다. 가중치를 반복해서 읽지 않아도 되므로 프리필처럼 같은 가중치를 여러 토큰에 쓸 때 유리하다.
출처: EMJzeroCC0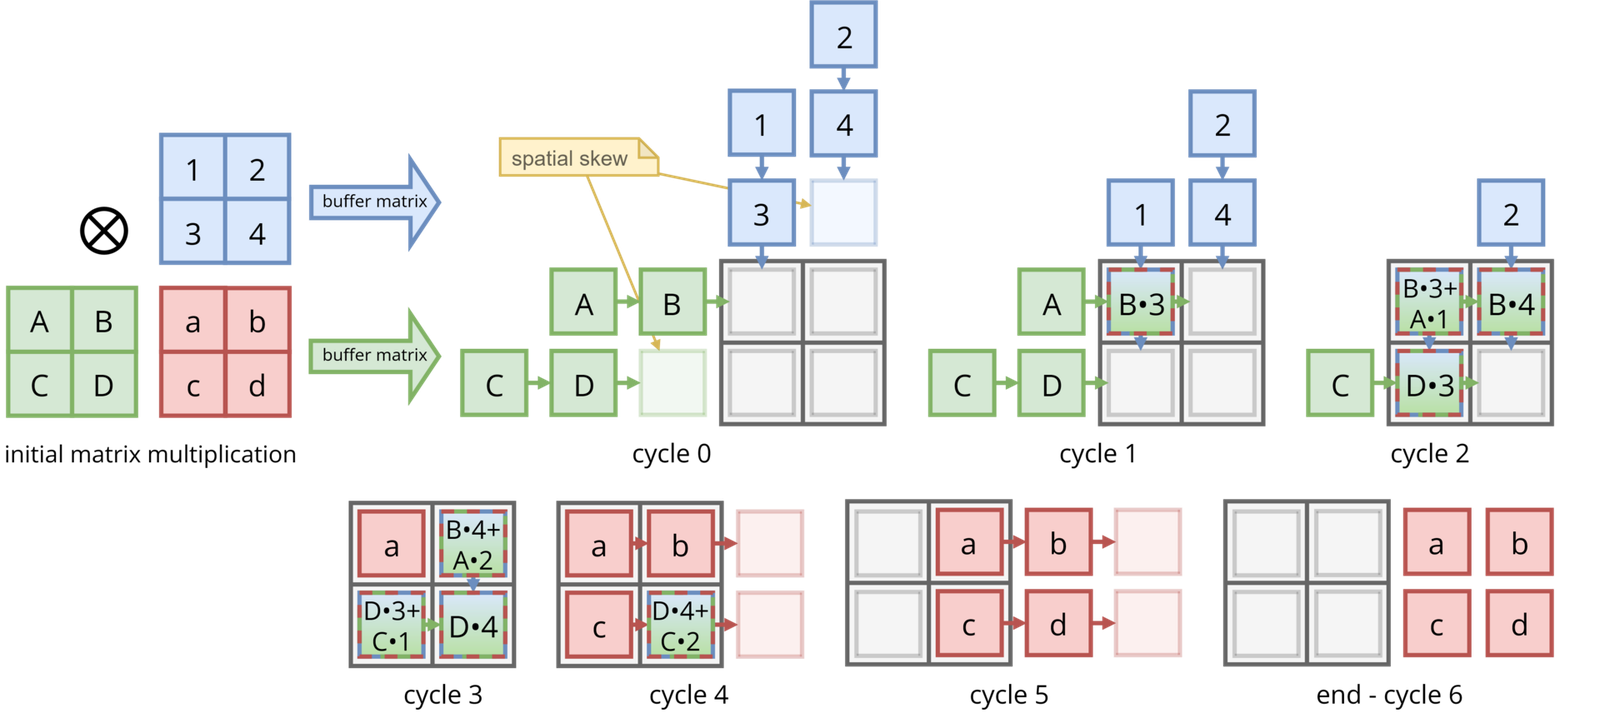
출력 고정(output stationary) 방식. 누산기를 제자리에 두고 입력과 가중치를 양쪽에서 흘린다. 누산 결과를 밖으로 쓰는 횟수가 줄어든다.
출처: EMJzeroCC0어떤 값을 「고정」하느냐가 그 칩이 어떤 워크로드를 겨냥했는지를 드러낸다. Google TPU의 MXU는 전통적으로 가중치 고정에 가깝고, NVIDIA 텐서코어는 SM 안에 있는 작은 행렬 유닛들을 소프트웨어가 유연하게 조합하는 쪽이다. 유연성을 버릴수록 효율은 올라가고 범용성은 떨어진다 — 이 트레이드오프가 6~7장 제품 비교의 축이 된다.
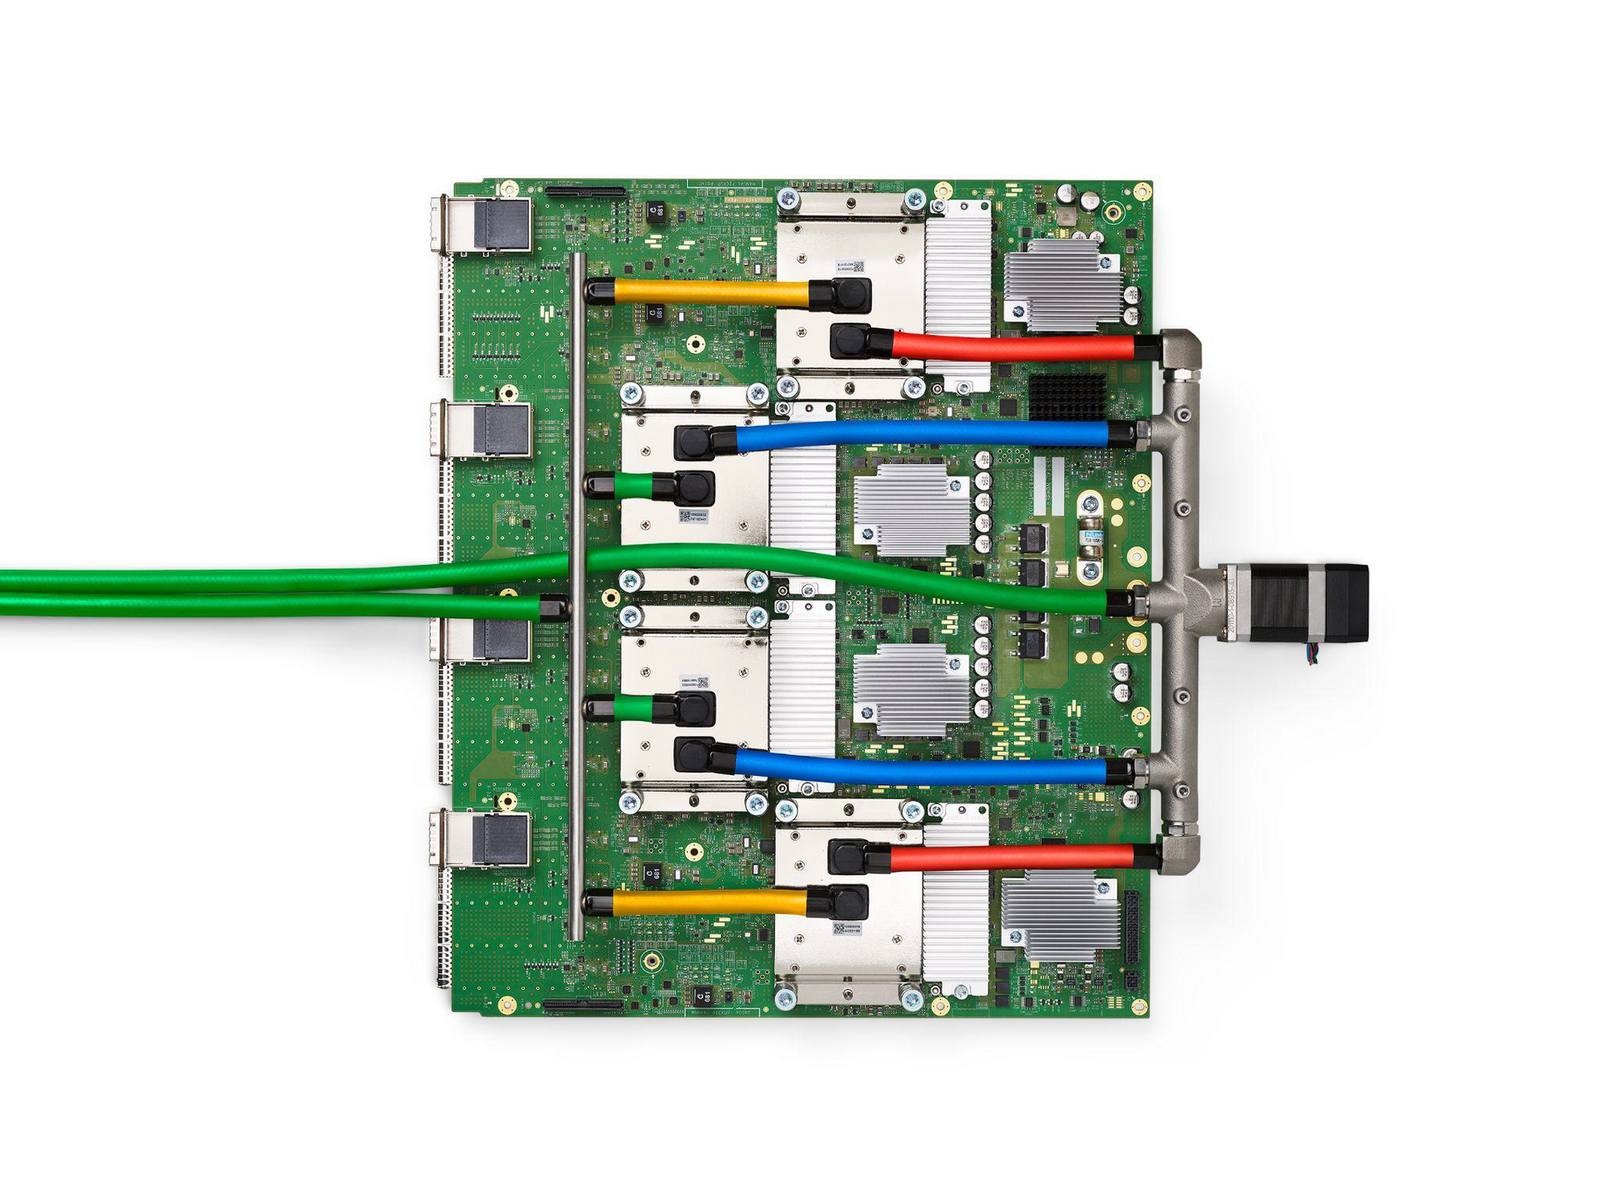
Google TPU v4 보드 — 도메인 특화 가속기의 전형
MXU(행렬 유닛)를 중심으로 설계되어 있다. 범용 CPU와 달리 분기 예측기, 대형 캐시 계층, 복잡한 아웃오브오더 로직이 없다. 그 면적을 전부 곱셈-누산기와 메모리 인터페이스에 쓴다. 「유연성을 버리고 효율을 산다」는 6장의 논리가 실리콘 위에 그대로 드러난 모습이다.
출처: Norman P. Jouppi, George Kurian, Sheng Li, Peter Ma, Rahul Nagarajan, CC BY 4.0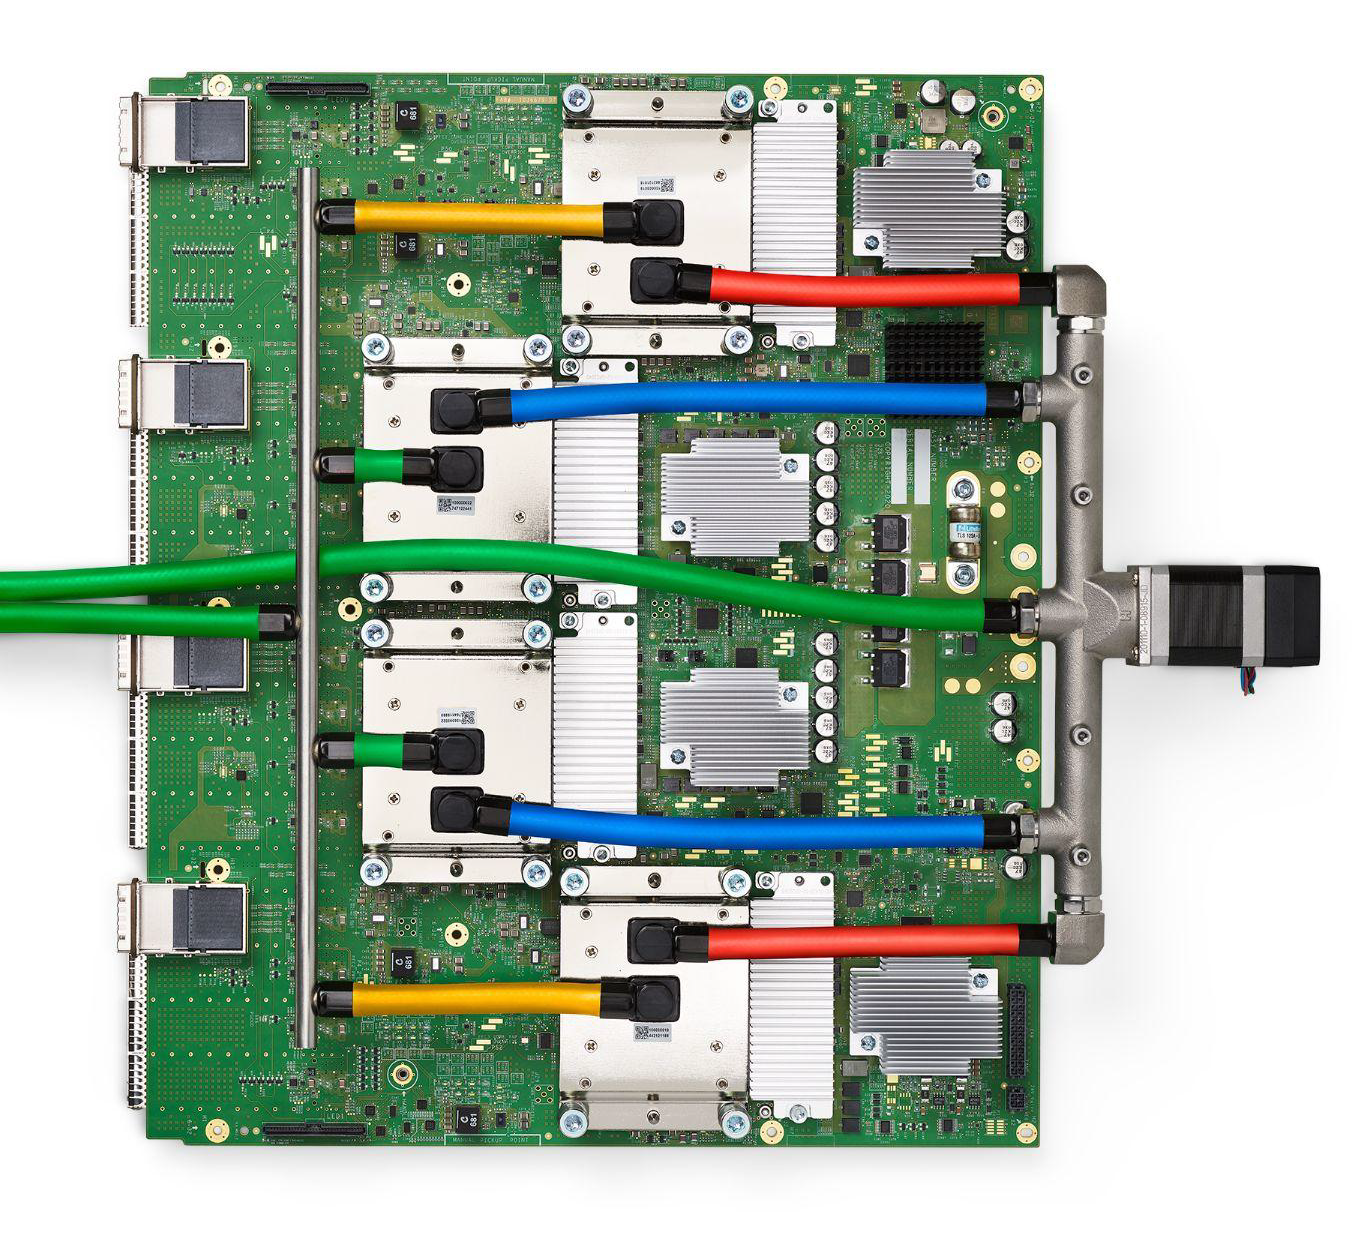
같은 보드를 확대한 것 — 칩과 주변 부품의 배치
칩 주위를 둘러싼 전원부와 냉각 인터페이스가 차지하는 면적을 보자. 가속기 하나를 동작시키려면 연산 다이보다 넓은 면적의 지원 회로가 필요하다. 11장에서 랙 전력이 오를수록 이 부분이 커진다는 것을 다시 보게 된다.
출처: Norman P. Jouppi, George Kurian, Sheng Li, Peter Ma, Rahul Nagarajan, CC BY 4.0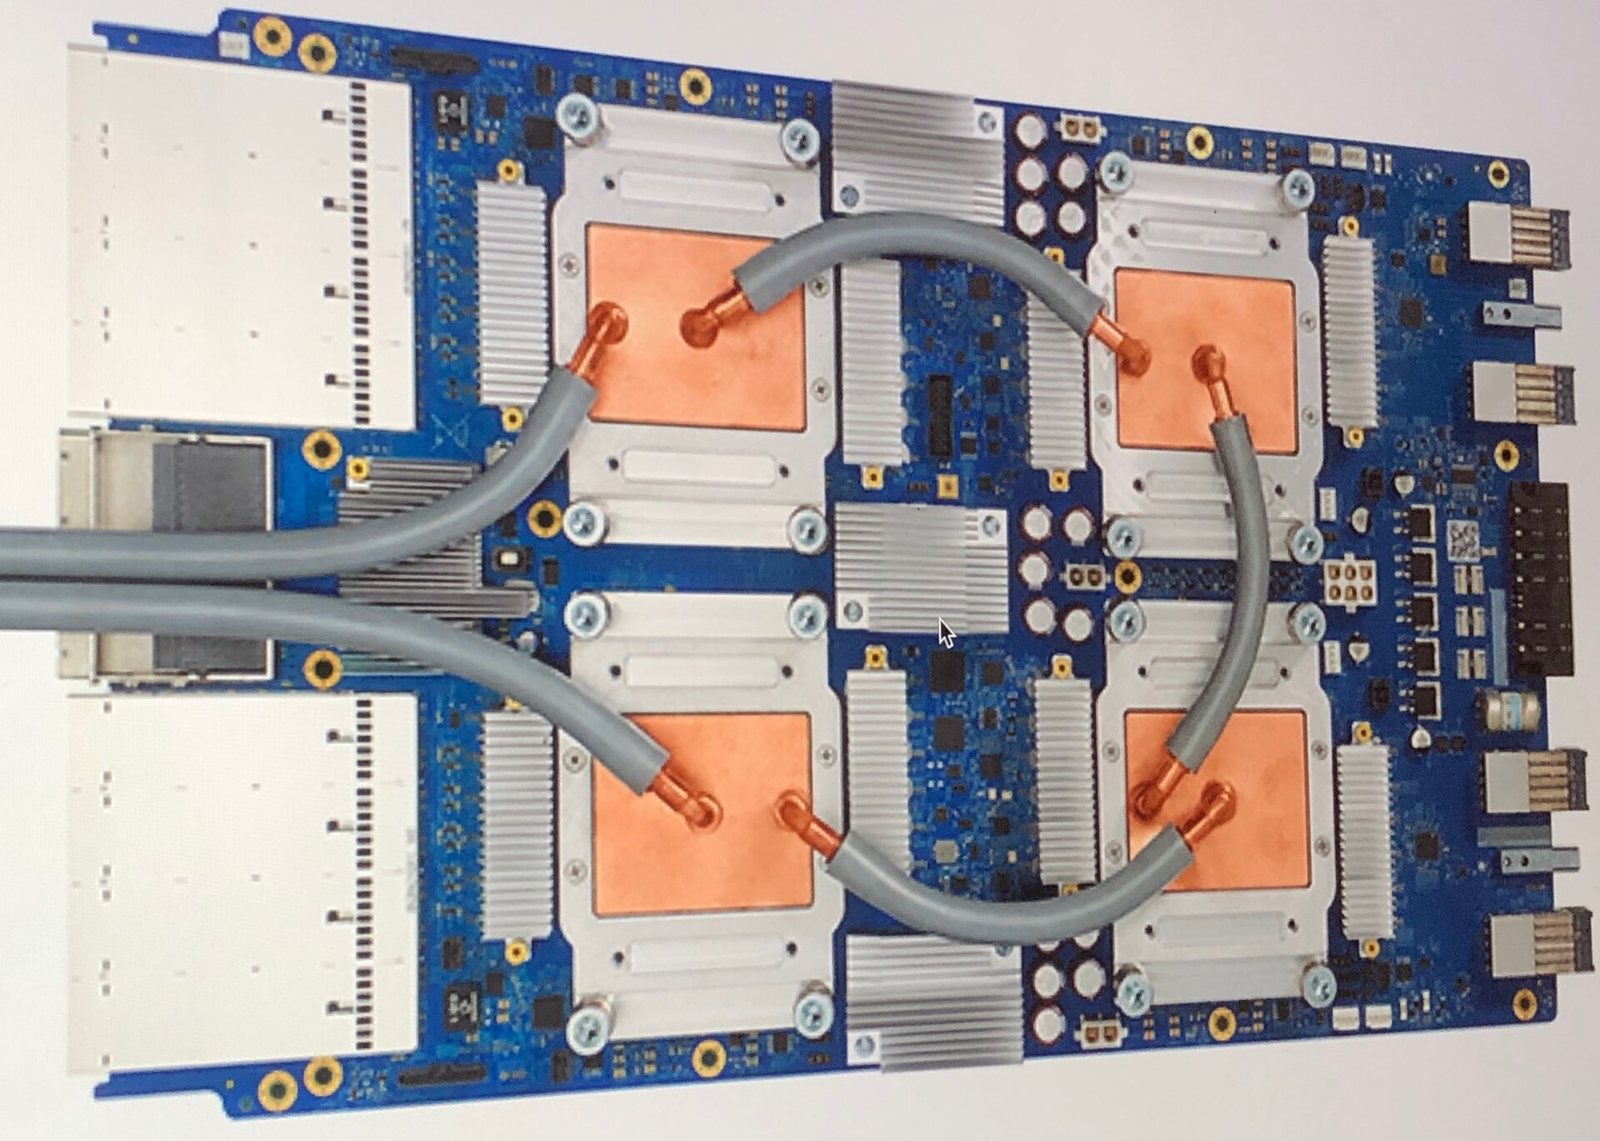
TPU v3 보드 — 액체냉각이 이미 적용된 세대
칩 위에 얹힌 냉각 블록과 배관이 보인다. Google은 일찍부터 액체냉각을 표준으로 가져갔다. 자기가 쓰는 하드웨어라 데이터센터 설계까지 함께 통제할 수 있었기 때문인데, 11장에서 볼 액체냉각 전환이 NVIDIA 진영에서는 GB200 세대에 와서야 표준이 된 것과 대비된다.
출처: ZinskaufCC BY-SA 4.0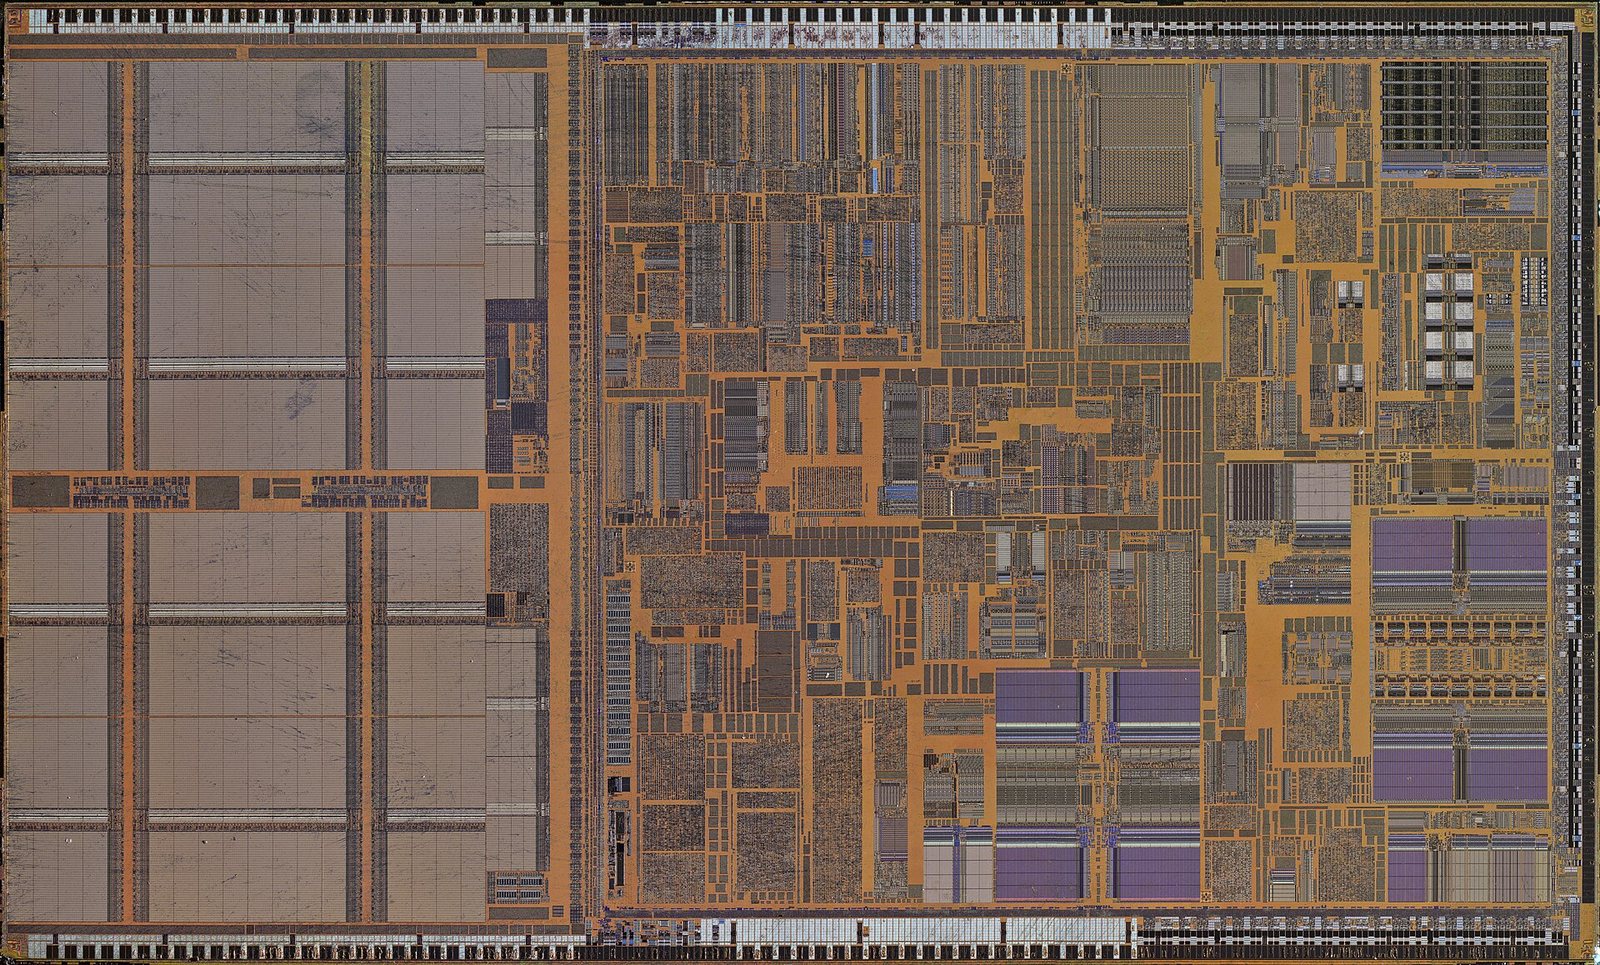
비교 — 범용 CPU 다이샷 (Pentium II)
면적의 상당 부분이 캐시와 제어 로직이다. 범용 CPU는 「무슨 코드가 올지 모른다」는 전제 위에 설계되므로 예측과 캐싱에 면적을 써야 한다. 가속기는 그 전제를 버리는 대신 그 면적을 연산에 쓴다.
출처: Martijn BoerPublic domain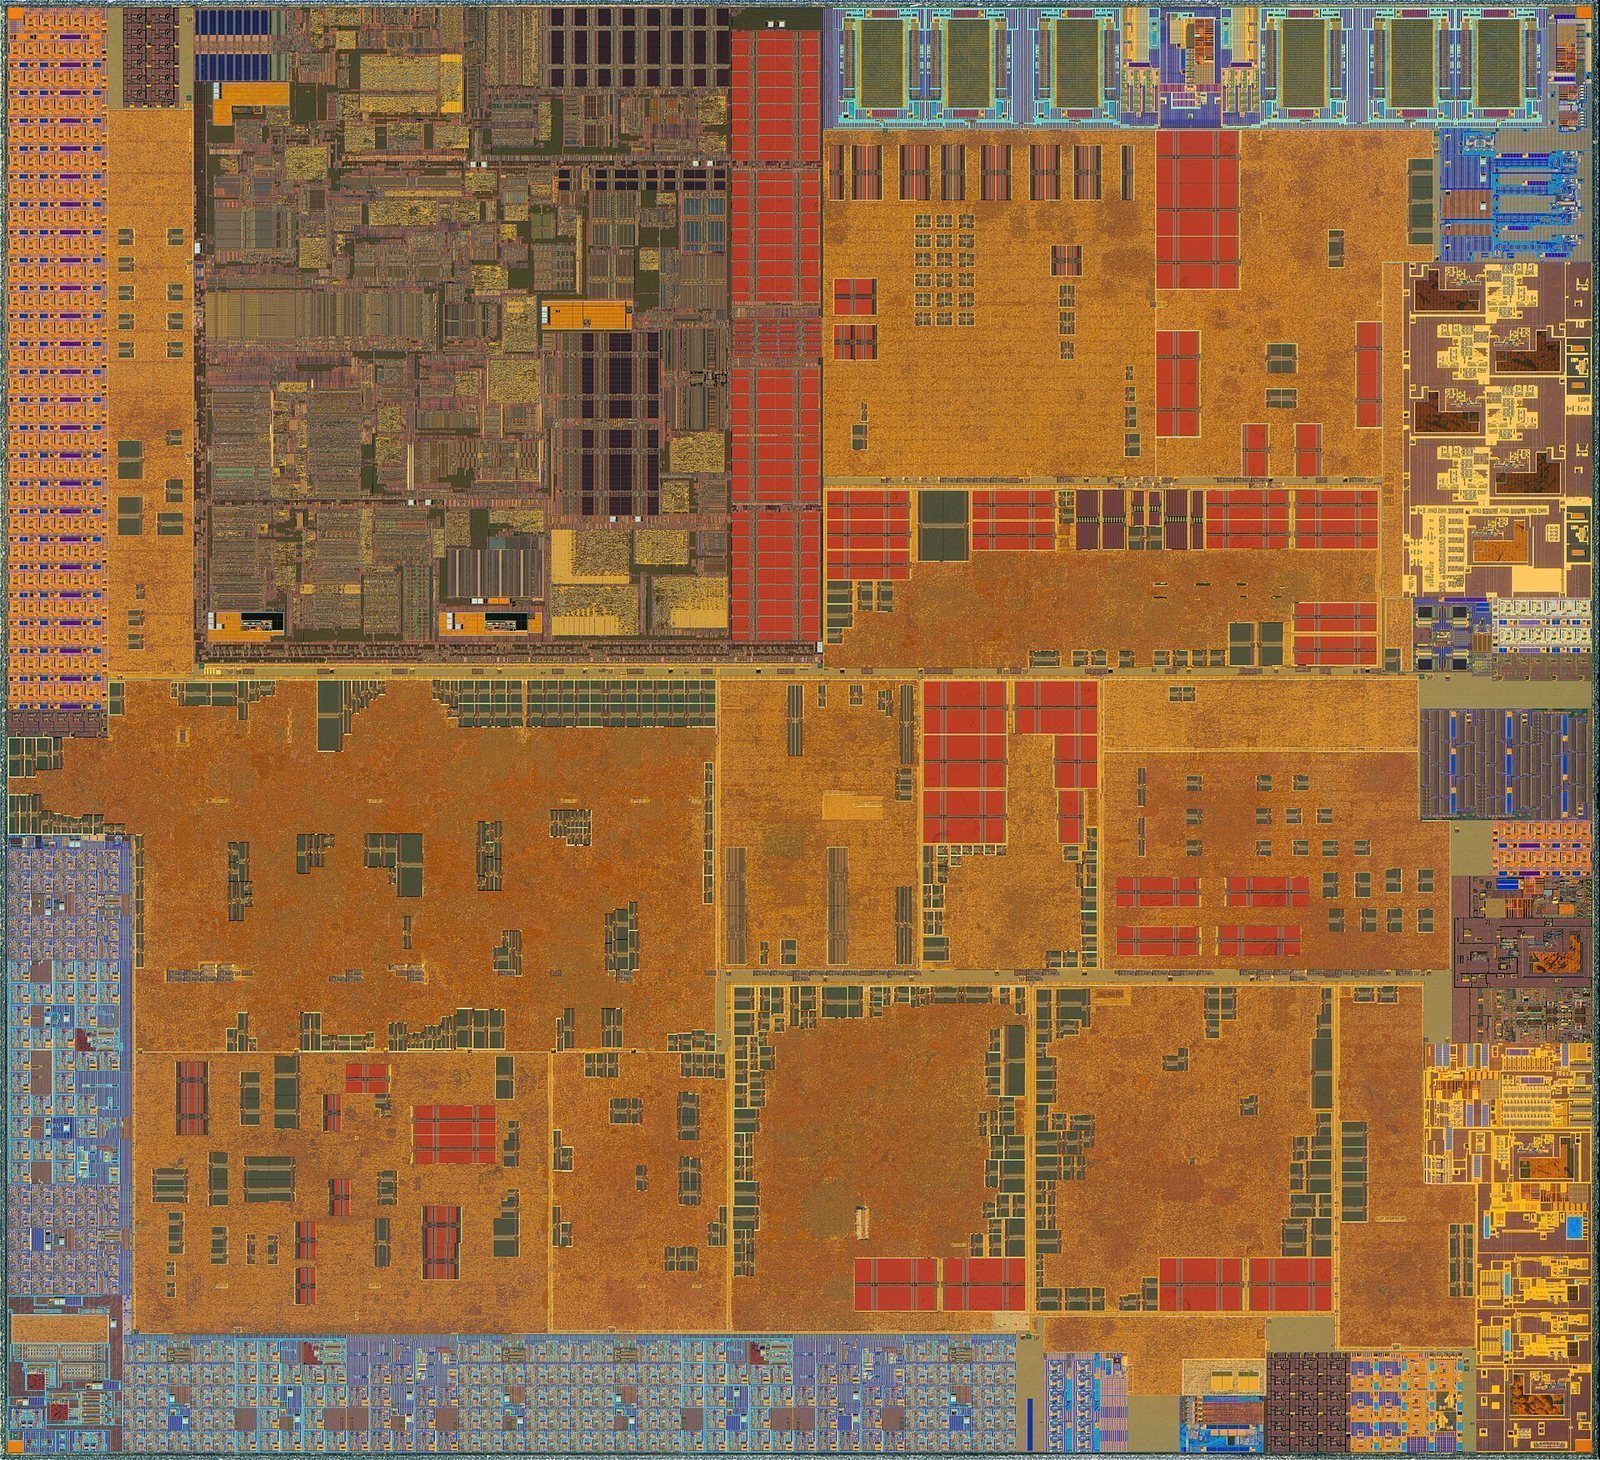
SoC 다이샷 — 여러 기능 블록이 한 칩에 모인 형태
CPU 코어, 그래픽, 비디오 디코더, I/O가 한 다이에 들어 있다. 블록마다 회로의 규칙성이 다른 것이 눈에 보인다 — 규칙적으로 반복되는 부분이 메모리·연산 어레이, 어지러운 부분이 제어 로직이다. 이 시각을 가지고 7장의 Groq LPU 다이샷을 보면 그 칩이 무엇에 면적을 몰아넣었는지 바로 읽힌다.
출처: Cole LCC BY-SA 2.0저정밀 수치형식 — 읽을 바이트를 줄이는 정공법
1장 계산을 다시 보자. 디코드 속도의 상한은 HBM 대역폭 ÷ 가중치 크기 였다. 대역폭은 물리적으로 늘리기 어렵다. 그렇다면 분모를 줄이면 된다. 이것이 저정밀 수치형식의 진짜 동기다. FP16 → FP8 → FP4로 갈 때마다 가중치 크기가 절반이 되고, 디코드 상한이 두 배가 된다.
수치형식의 비트 구성. 부호·지수·가수에 비트를 어떻게 배분하느냐가 「표현 범위」와 「정밀도」의 트레이드오프를 결정한다.
직접 제작 도해 · 자유 사용왜 BF16이 학습의 기본이 되었는가
FP16과 BF16은 둘 다 16비트지만 성격이 정반대다. FP16은 가수 10비트로 정밀하지만 지수가 5비트뿐이라 표현 범위가 좁다 — 학습 중 그래디언트가 작아지면 0으로 죽어버린다(그래서 loss scaling이 필요했다). BF16은 가수를 7비트로 줄이는 대신 지수를 FP32와 똑같이 8비트로 유지해서, 범위 문제 없이 그냥 돌아간다. 정밀도보다 범위가 중요했던 것이다.
FP4가 실제로 쓰이는 방법
FP4는 값 하나로 16단계밖에 표현하지 못한다. 그대로 쓰면 모델이 망가진다. 그래서 값 여러 개를 블록으로 묶고 블록마다 공유 스케일을 따로 둔다. 위 도해 아래쪽에 MXFP4와 NVFP4의 차이를 정리했다 — 블록 크기(32 vs 16)와 스케일 형식(E8M0 vs E4M3)이 다르다.
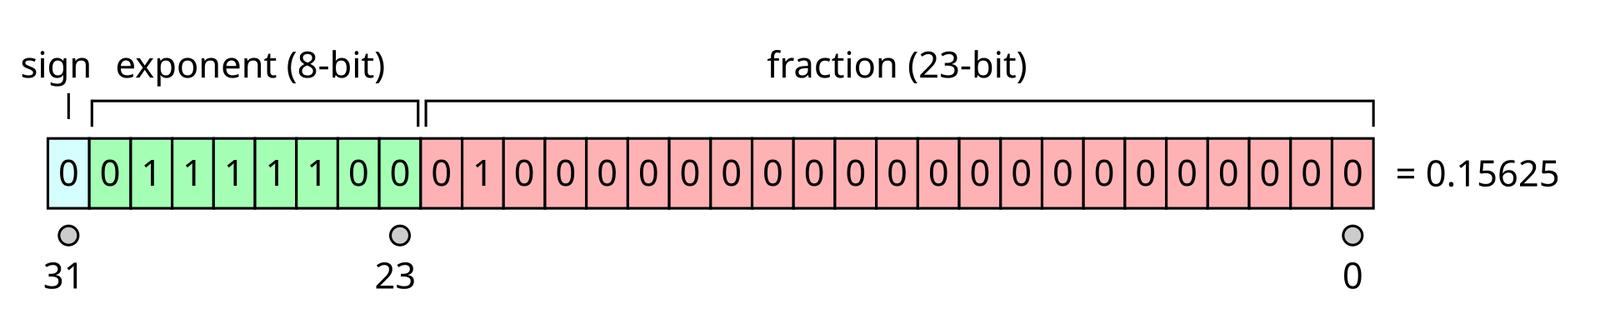
IEEE 754 단정밀도(FP32)의 비트 배치 — 모든 부동소수점 형식의 원형
맨 왼쪽 1비트가 부호, 다음 8비트가 지수, 나머지 23비트가 가수다. 위 도해의 모든 저정밀 형식은 이 세 칸의 크기를 바꾼 변형일 뿐이다. 지수를 줄이면 표현할 수 있는 수의 범위가 좁아지고, 가수를 줄이면 촘촘함이 떨어진다. 어느 쪽을 깎을지가 곧 그 형식이 겨냥한 용도를 말해 준다.
출처: CodekaizenCC BY 3.0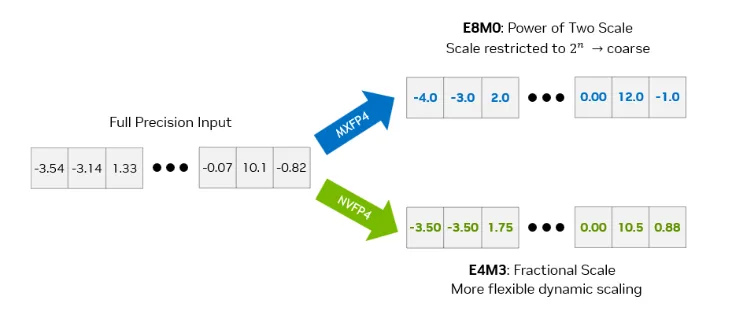
같은 값을 MXFP4와 NVFP4로 양자화했을 때의 차이
원본 -3.54 · -3.14 · 1.33 … 을 두 방식으로 표현한 결과를 나란히 놓았다. MXFP4(E8M0)는 스케일이 2의 거듭제곱뿐이라 -4.0 · -3.0 · 2.0 처럼 거칠게 떨어지고, NVFP4(E4M3)는 스케일에 소수부가 있어 -3.50 · -3.50 · 1.75 처럼 원본에 더 가깝다. 오른쪽 0.00 / 12.0 / -1.0 과 0.00 / 10.5 / 0.88 을 비교하면 차이가 더 뚜렷하다. NVIDIA가 NVFP4의 근거로 제시하는 그림이며, 벤더 자료임을 감안해 읽어야 한다.
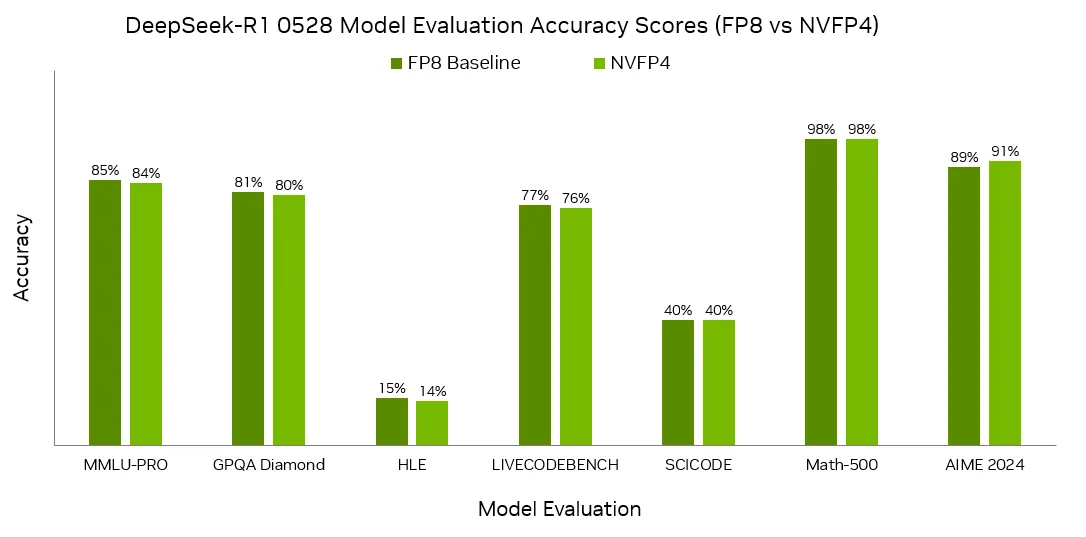
DeepSeek-R1을 FP8과 NVFP4로 서빙했을 때의 벤치마크 점수
MMLU-PRO 85→84, GPQA 81→80, Math-500 98→98, SciCode 40→40 으로 대부분 유지된다. 그런데 LiveCodeBench는 77 → 70 으로 7%p 떨어진다. 본문에서 「긴 컨텍스트나 수학·코딩처럼 오차가 누적되는 태스크에서 먼저 무너진다」고 했는데, 벤더 자료 안에서도 그 경향이 보인다. 평균만 보고 「정확도가 유지된다」고 결론 내리면 안 되는 이유가 이 한 칸에 있다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)
Blackwell 세대 패키지 — 두 개의 다이가 하나로
레티클 한계를 넘기 위해 큰 다이 두 장을 나란히 붙여 하나의 GPU로 동작시킨다. 아래 「공정과 패키징」 절에서 볼 칩렛 전략의 가장 공격적인 형태다. 두 다이 사이를 잇는 링크가 충분히 빨라야 소프트웨어가 하나로 볼 수 있는데, 그 링크를 만드는 것이 패키징 기술의 핵심이다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)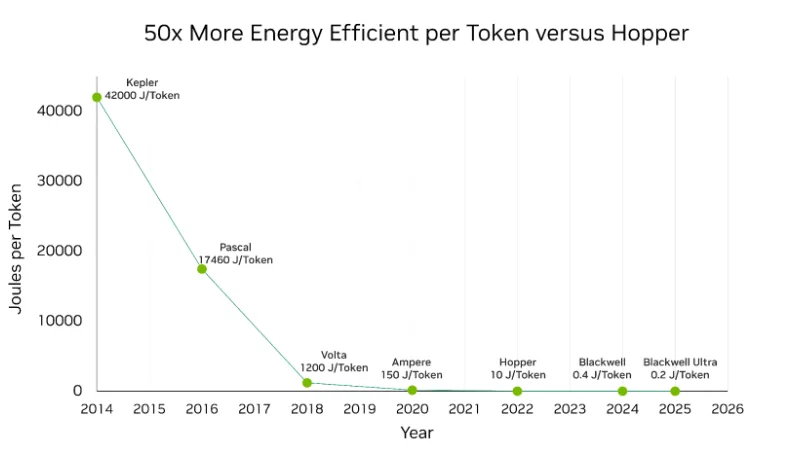
토큰 하나를 만드는 데 드는 에너지 — 2014년 이후
세로축이 토큰당 줄(J)이다. Kepler 42,000 J → Pascal 17,460 → Volta 1,200 → Ampere 150 → Hopper 10 → Blackwell 0.4 → Blackwell Ultra 0.2 J/token. 10년 남짓에 20만 배라는 주장이다. 정밀도가 세대마다 다르므로(첫 그래프에서 본 문제) 그대로 믿을 수는 없지만, 추세의 방향과 크기는 의미가 있다 — 이것이 없었다면 지금의 LLM 서비스는 성립하지 않았다. 15장에서 tokens/W를 계산할 때 이 곡선의 어느 지점에 있는 장비인지가 결과를 지배한다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)양자화는 「공짜 2배」가 아니다. 모델·태스크·보정 방식에 따라 정확도 손실이 크게 달라지고, 특히 긴 컨텍스트나 수학·코딩처럼 오차가 누적되는 태스크에서 먼저 무너진다. 아래 실습에서 처리량뿐 아니라 정확도도 같이 측정하는 이유다.
메모리 — HBM과 온칩 SRAM
HBM(High Bandwidth Memory)은 DRAM 다이를 여러 층으로 쌓고 TSV(실리콘 관통 전극)로 수직 연결한 뒤, 프로세서 옆에 아주 가깝게 붙인 메모리다. 대역폭이 나오는 원리는 클럭이 빨라서가 아니라 핀 수가 압도적으로 많아서다 — 스택당 1,024비트 이상의 폭으로 동시에 읽는다.
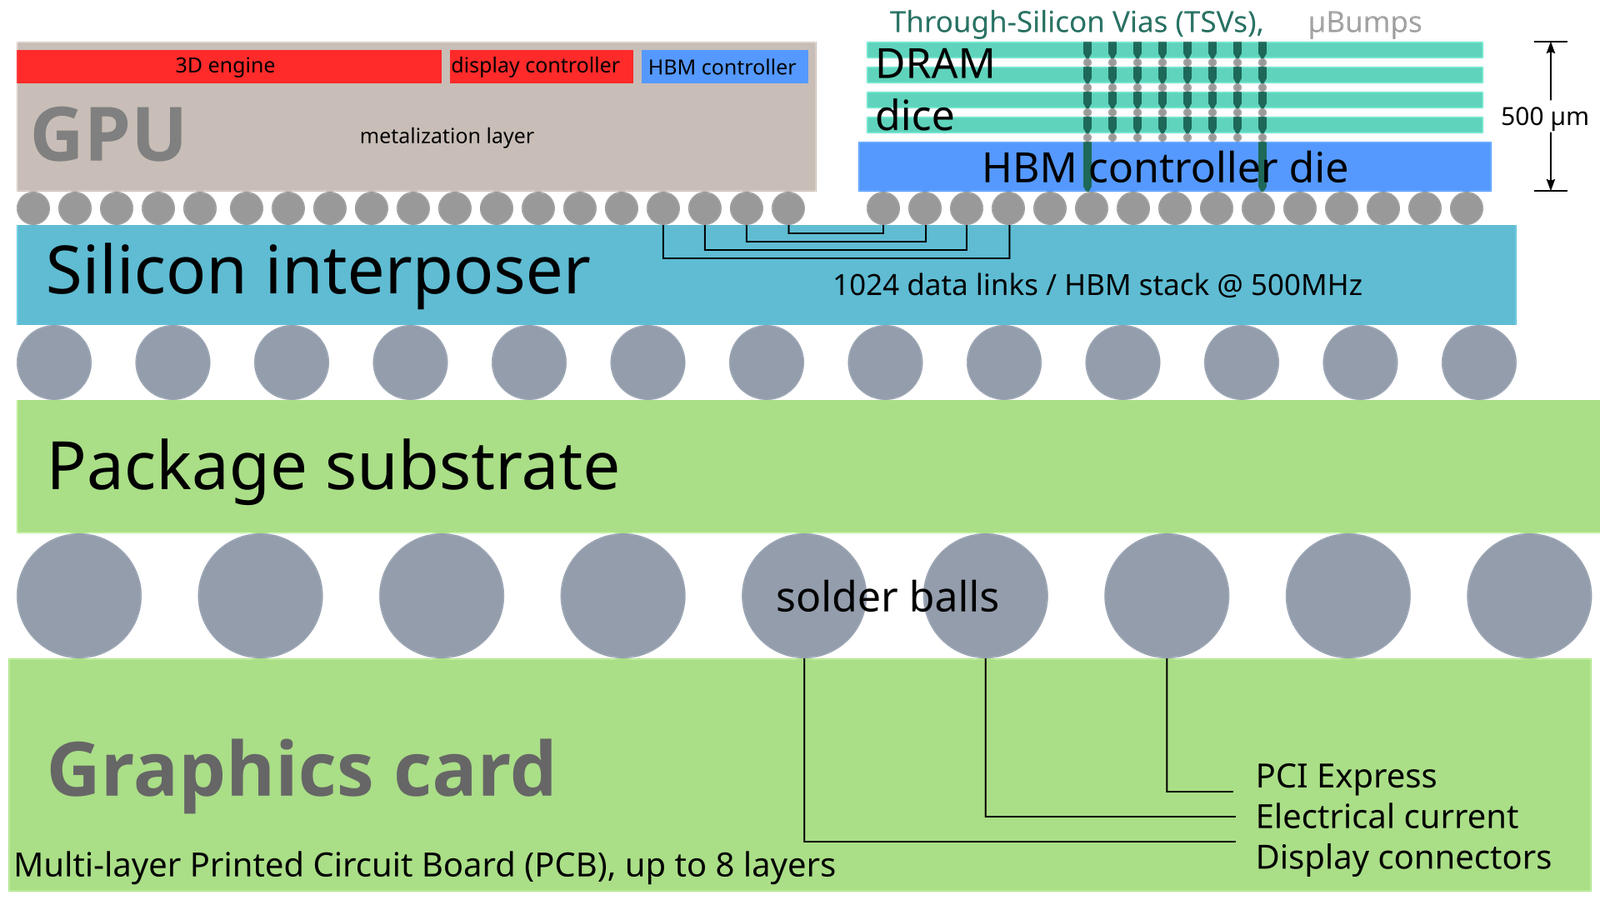
HBM 구조도. DRAM 다이를 쌓아 TSV로 연결하고, 인터포저를 통해 프로세서와 짧고 넓은 배선으로 이어진다.
출처: ScotXWCC BY-SA 4.0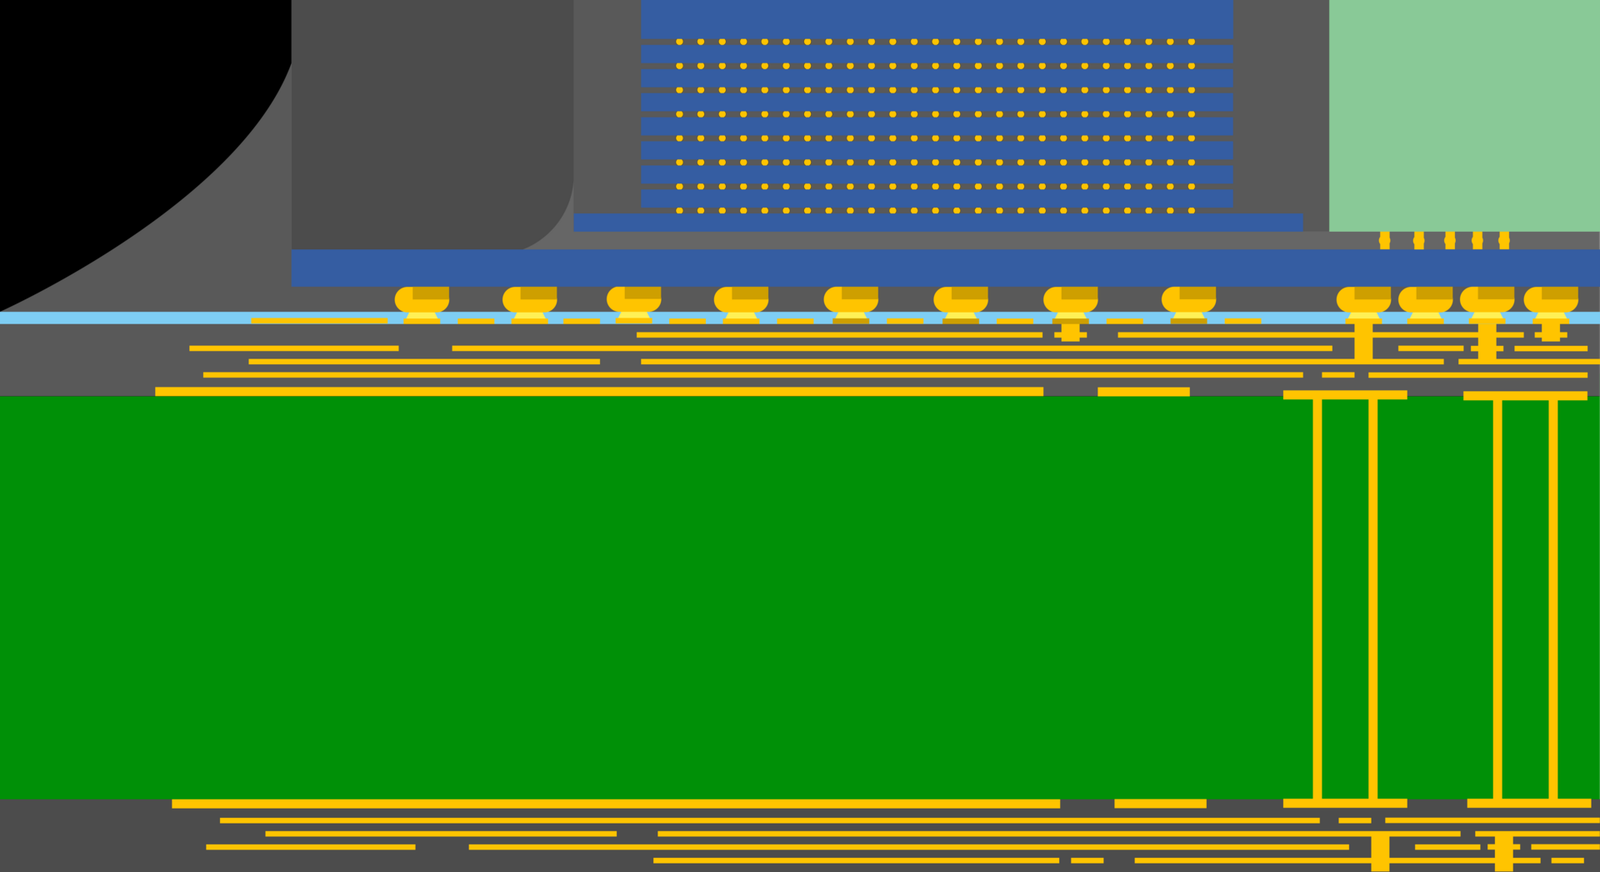
HBM 단면 개념도. 물리적 거리가 짧아야 넓은 버스를 낮은 전력으로 돌릴 수 있다.
출처: 思考的苇丛CC BY-SA 4.0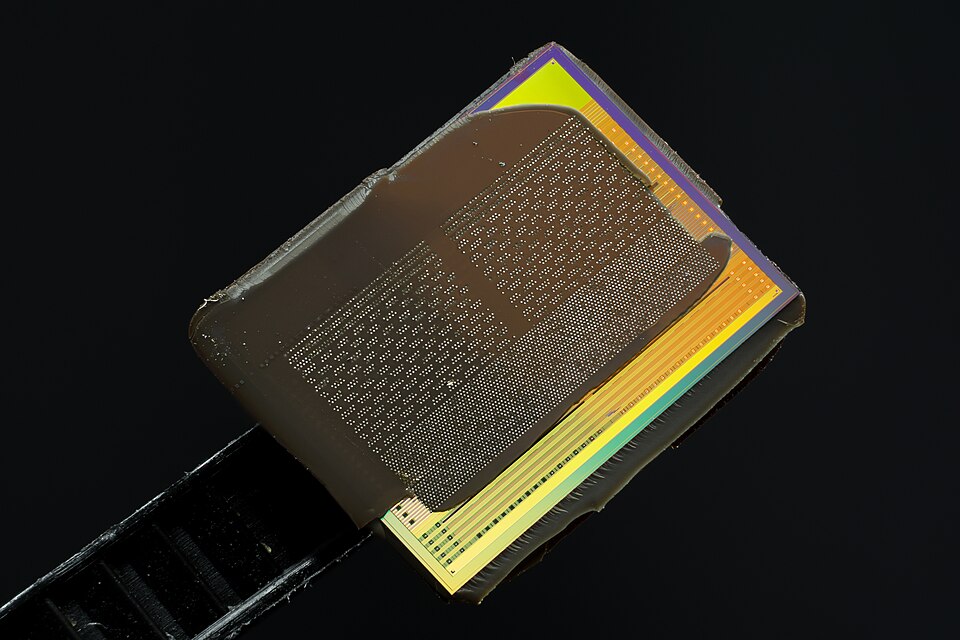
실제 패키지 사진(AMD Fiji). 가운데 큰 다이가 GPU, 그 주위를 둘러싼 작은 사각형들이 HBM 스택이다. 이 「GPU 다이 + 주변 HBM」 배치는 2026년 최신 제품까지 그대로 이어진다.
출처: en.wikipedia.org© en.wikipedia.org (교육 목적 인용)HBM 세대 전환(HBM3e → HBM4)은 단순한 속도 향상이 아니다. 스택당 용량과 폭이 함께 늘어나면서 인터포저 면적과 패키징 난이도, 그리고 공급망이 제품 출하 시점을 결정하는 요인이 된다. 5~6장에서 각 제품의 HBM 선택을 비교한다.
그런데 왜 SRAM인가
HBM도 결국 칩 밖에 있다. 칩 안의 SRAM은 대역폭이 HBM보다 한 자릿수 이상 높고 지연도 훨씬 낮다. 문제는 용량이다 — 같은 면적에 담을 수 있는 비트 수가 DRAM보다 훨씬 적고, 미세공정이 진행돼도 SRAM 면적은 잘 줄어들지 않는다.
메모리 계층. 추론 서빙에서는 KV 캐시가 이 계단을 오르내리며, 어느 계층까지 내려보낼지가 곧 설계 결정이 된다.
직접 제작 도해 · 자유 사용- 대역폭에 건다 — HBM 세대를 앞서가고 스택 수를 늘린다 (NVIDIA Rubin).
- 용량에 건다 — 같은 세대라도 스택을 더 얹어 큰 모델을 한 칩에 (AMD MI455X).
- SRAM에 건다 — HBM을 아예 우회하거나 보조로만 쓴다 (Groq, Cerebras, TPU 추론칩).
아래 토론 주제이자, 6~7장 제품 비교의 핵심 축이다.
공정과 패키징 — 하나의 큰 칩이 불가능해진 시대
연산 유닛을 늘리려면 다이를 키우면 된다. 그런데 다이는 무한정 커질 수 없다. 노광 장비가 한 번에 찍을 수 있는 면적(레티클 한계)이 정해져 있고, 다이가 커질수록 결함 하나로 통째로 버려질 확률이 급격히 올라간다(수율).
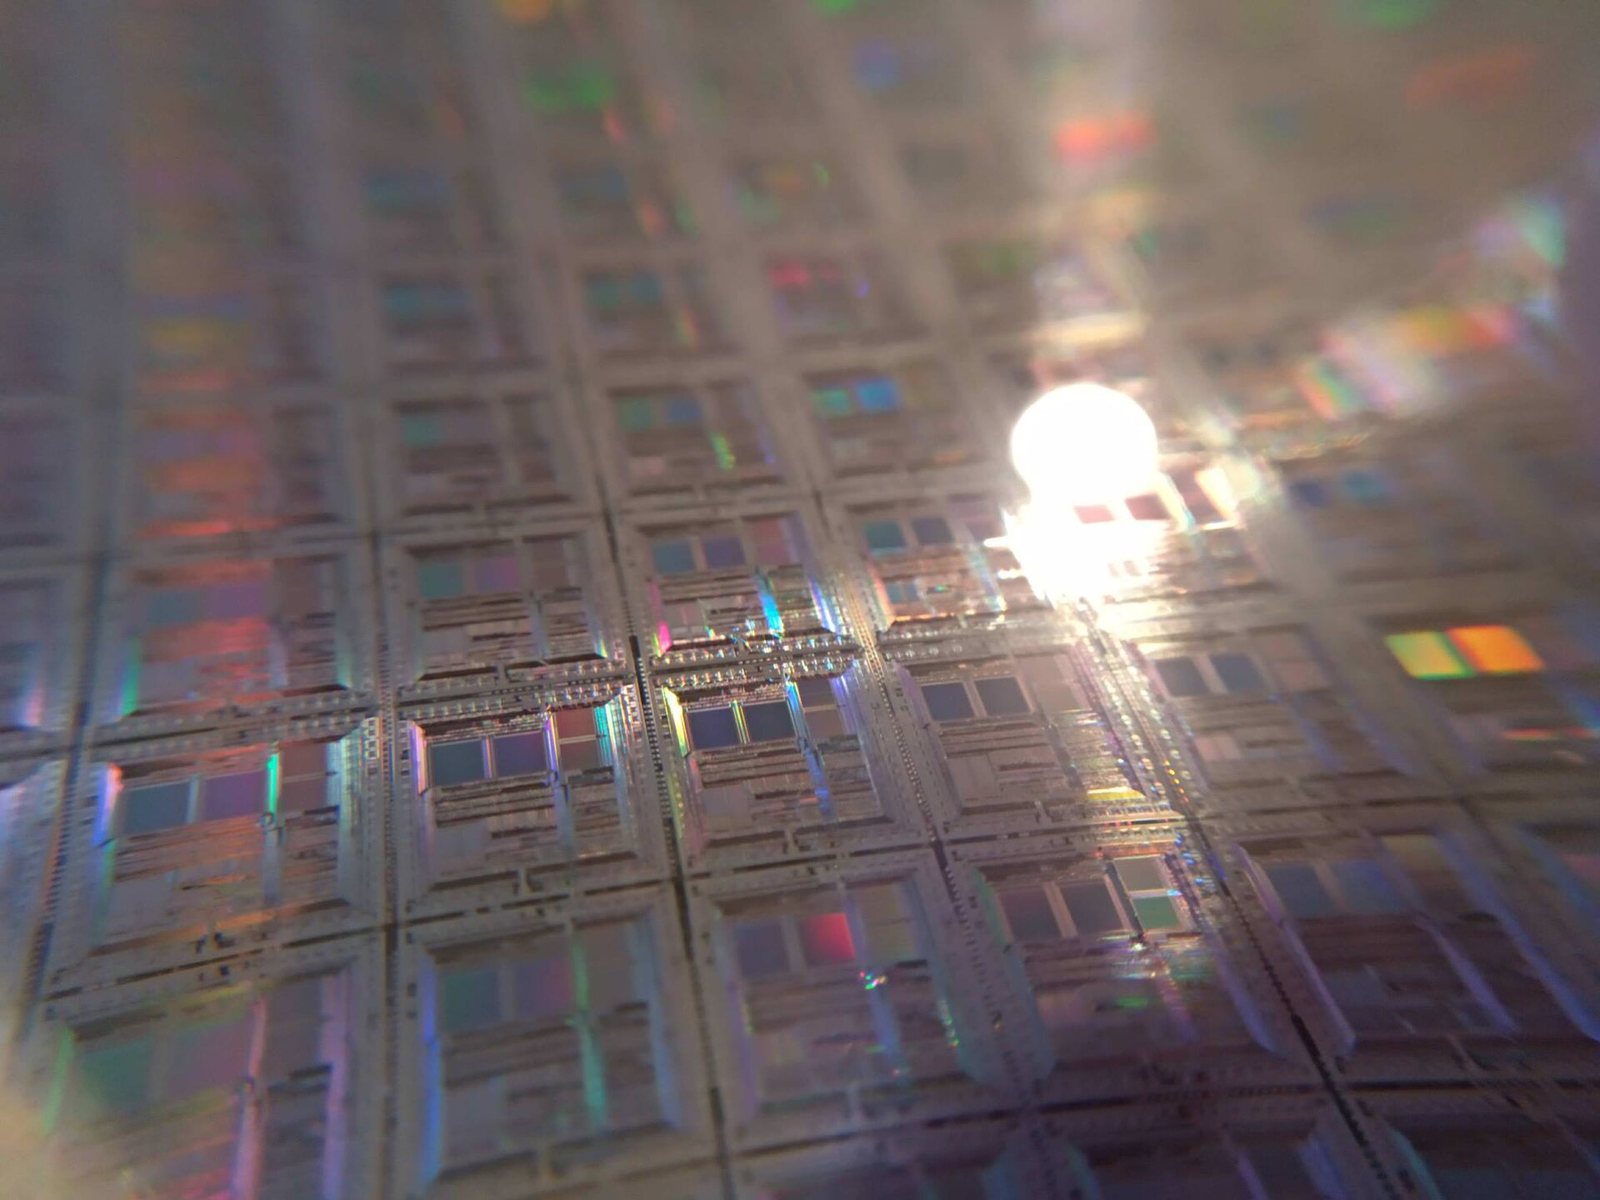
웨이퍼 위에 반복적으로 찍힌 다이들. 다이가 클수록 웨이퍼 한 장에서 나오는 개수가 줄고, 결함 하나가 버리는 면적이 커진다.
출처: Le hollandais volantCC BY 4.0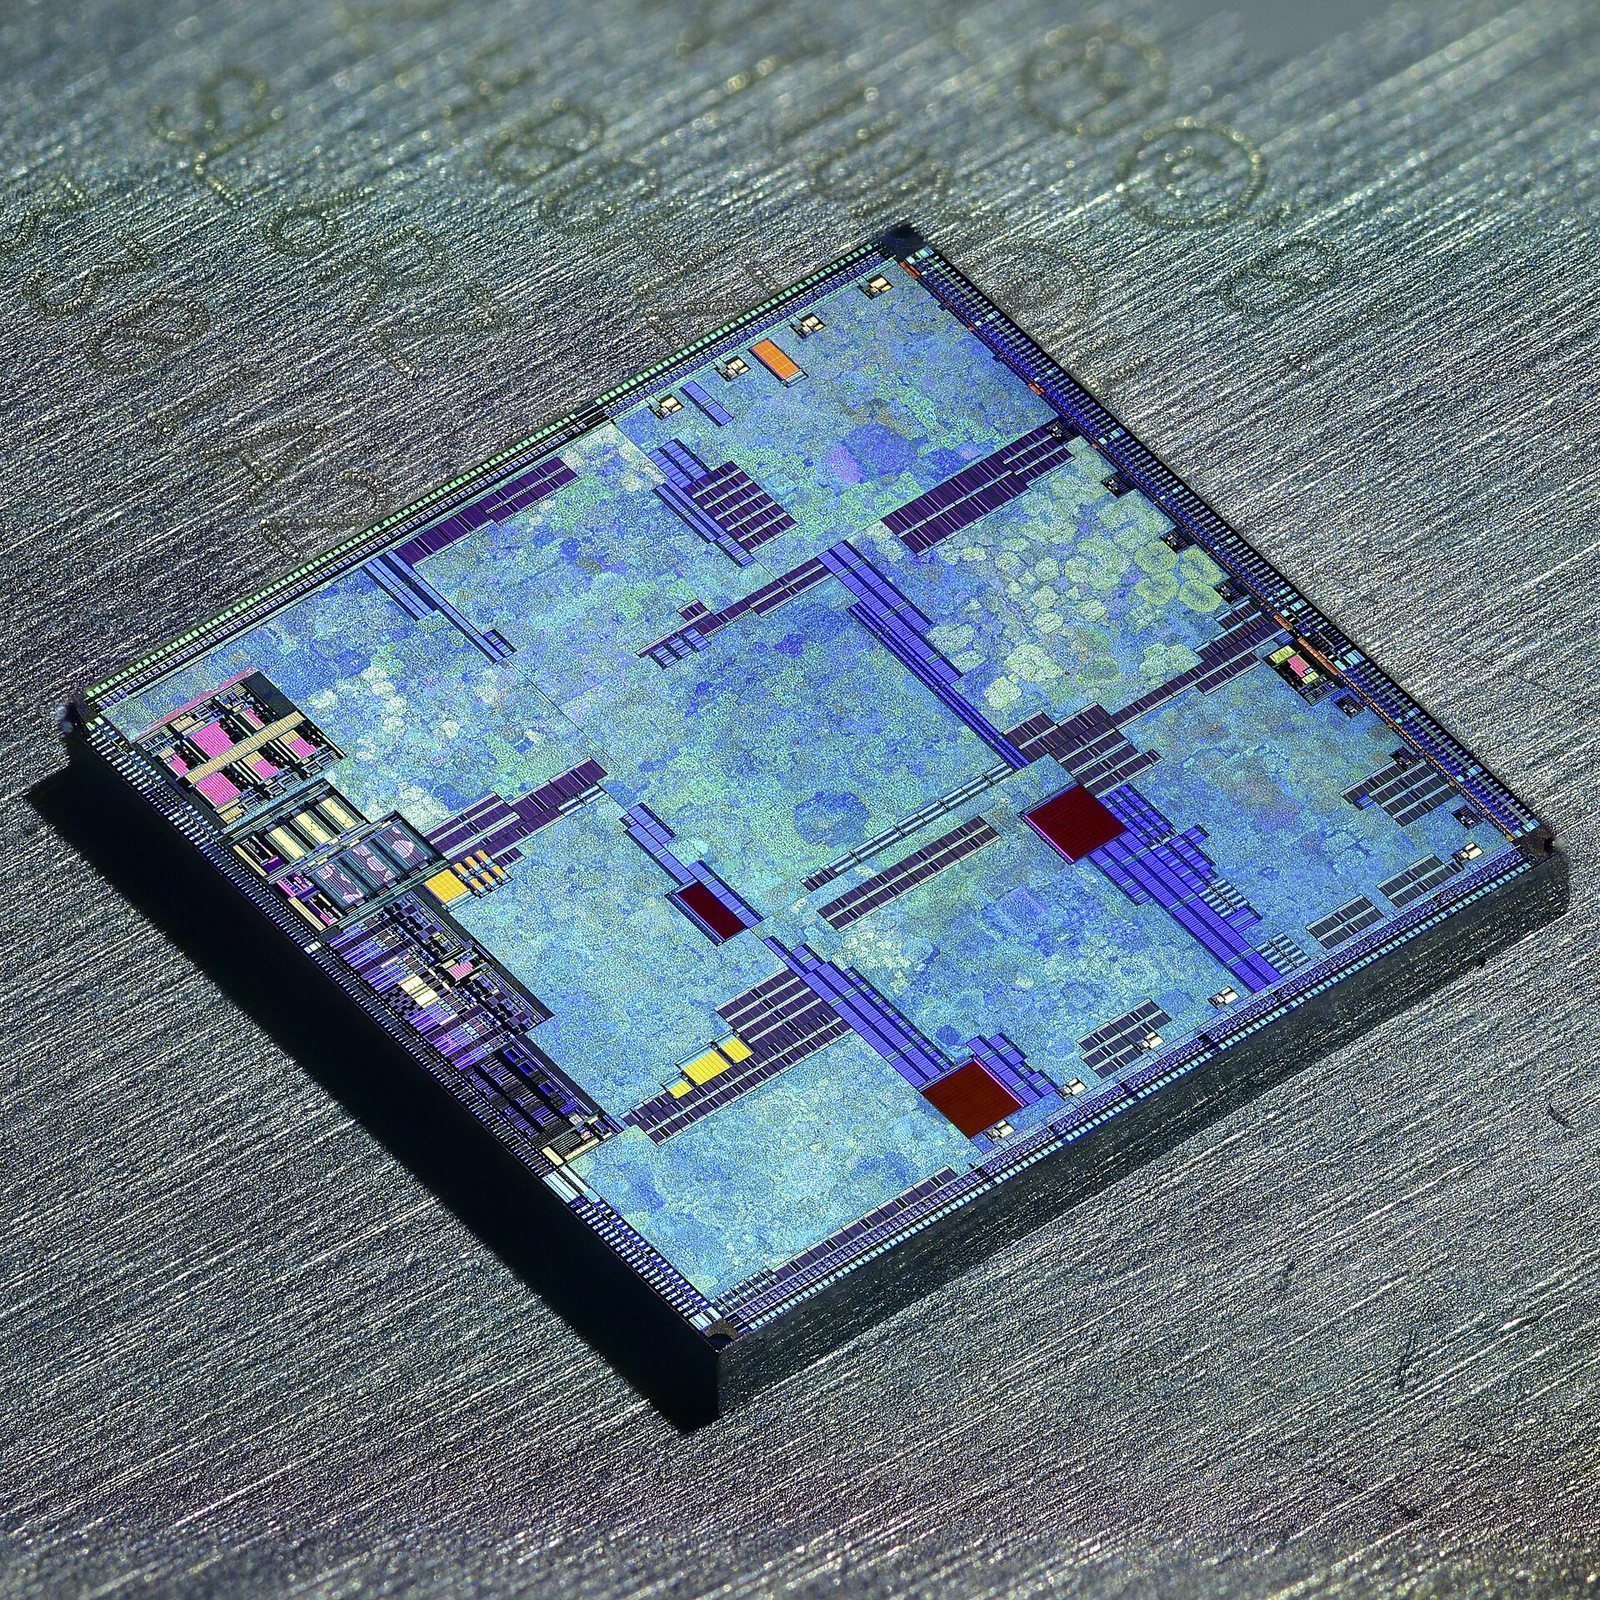
GPU 다이샷. 규칙적으로 반복되는 연산 블록과 가장자리의 I/O 영역이 보인다.
출처: Martijn BoerPublic domain그래서 나온 답이 칩렛(chiplet) 이다. 큰 칩 하나 대신 작은 다이 여러 개를 만들어 패키지 안에서 고속으로 연결한다. 연산부는 최신 공정, I/O는 성숙한 저렴한 공정으로 나눠 만들 수도 있다.
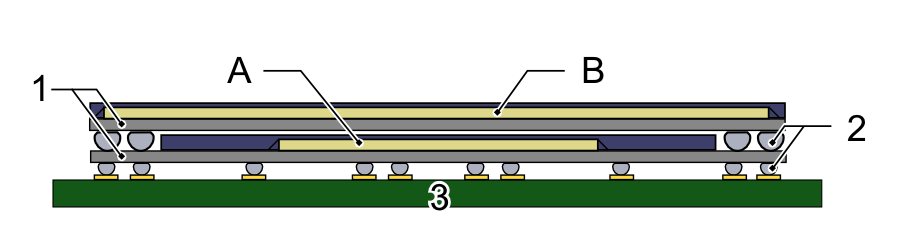
패키지 적층의 기본 개념. 수직으로 쌓아 배선 거리를 줄인다.
출처: TosakaCC BY 3.0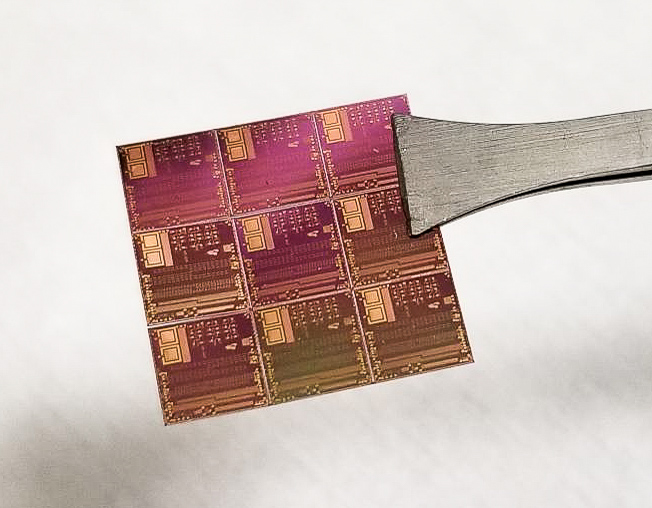
다이를 격자로 이어붙이는 패키징 연구 사례. 상용 제품에서는 CoWoS(TSMC), Foveros(Intel) 같은 방식이 쓰인다.
출처: JacksontluCC BY-SA 4.0| 용어 | 무엇인가 | 왜 중요한가 |
|---|---|---|
| CoWoS | TSMC의 2.5D 패키징. 실리콘 인터포저 위에 로직 다이와 HBM을 나란히 올린다 | 고성능 AI 칩 대부분이 여기에 의존한다 → 공급 병목이 곧 출하량 상한 |
| Foveros | Intel의 3D 적층. 다이를 수직으로 쌓는다 | 전력·면적 효율, 다만 열 배출이 과제 |
| UCIe | 칩렛 간 인터페이스 표준 | 서로 다른 회사의 칩렛을 조립할 수 있게 됨 → 개방형 진영의 무기 |
| TSV | 실리콘 관통 전극 | HBM 적층과 3D 패키징의 물리적 기반 |
공정 노드 이름(3nm, 2nm)은 실제 물리적 치수가 아니라 마케팅 명칭에 가깝다. 제품을 비교할 때는 노드 이름보다 트랜지스터 수, 다이 면적, 전력당 성능을 보는 편이 정확하다.
칩 단위 비교 — 같은 문제, 다른 답
아래 표는 커리큘럼 기준 시점의 주요 제품을 칩 단위로 정리한 것이다. 숫자 자체보다 각 벤더가 어디에 비중을 뒀는지를 읽는 것이 목적이다.
| 제품 | 메모리 | 대역폭 | 저정밀 성능 | 공정·규모 | 설계가 겨냥한 것 |
|---|---|---|---|---|---|
| NVIDIA Rubin GPU | HBM4 288 GB | 22 TB/s | FP4 약 50 PF | 3nm · 약 3,360억 tr | 대역폭과 연산을 동시에 밀어붙이는 정면 승부 |
| AMD MI455X (CDNA5) | HBM4 432 GB | — | — | 약 3,200억 tr | 용량 우위 — 큰 모델을 더 적은 칩에 얹기 |
| Google TPU 8i (추론) | HBM 288 GB + SRAM 384 MB | — | — | — | 온칩 SRAM으로 디코드 지연을 정면 공략 |
| AWS Trainium3 | HBM3e 144 GB | — | FP8 2.52 PF | 3nm | 자사 워크로드에 맞춘 비용 최적화 |
- 빈칸은 「없다」가 아니라 공개 자료에서 확인하지 못했다는 뜻이다. 수업 전 최신 자료로 채울 것.
- 저정밀 성능(PF)은 정밀도 정의·희소성 가정·칩 단위/랙 단위가 벤더마다 달라 그대로 비교하면 안 된다.
- 커리큘럼 기준 시점에 아직 출하되지 않은 제품의 수치는 전부 벤더 발표값이다.
주제: 「메모리 용량 vs 대역폭 vs SRAM」 — 각 벤더는 왜 다른 선택을 했는가?
- AMD가 용량(432GB)을 앞세우는 것은 어떤 고객·워크로드를 겨냥한 것인가? 「한 칩에 다 들어간다」가 왜 비용 우위로 이어지는가?
- Google이 학습칩(TPU 8t)과 추론칩(TPU 8i)을 분리하고 추론칩에만 대용량 SRAM을 넣은 이유는? 이것이 1장 루프라인과 어떻게 연결되는가?
- NVIDIA는 왜 분리하지 않고 하나의 GPU로 학습·추론을 모두 커버하려 하는가? 그 전략의 강점과 약점은?
- 우리 학교가 칩을 하나 설계한다면 어디에 걸겠는가? 그 선택의 전제 조건은 무엇인가?
실습 — 정밀도를 바꾸면 무엇이 얼마나 바뀌는가
목표: 같은 모델을 FP16 / FP8 / NVFP4로 돌려 처리량·메모리 사용량·정확도의 삼각 트레이드오프를 직접 측정한다.
측정 항목
| FP16 (기준) | FP8 | NVFP4 | |
|---|---|---|---|
| 가중치 메모리 (GB) | |||
| 디코드 처리량 (tok/s, 배치 1) | |||
| 디코드 처리량 (tok/s, 배치 32) | |||
| TTFT (ms, 프롬프트 2K) | |||
| 정확도 (선택한 벤치마크) | |||
| 긴 컨텍스트에서의 정확도 |
확인할 질문
- 가중치가 절반이 되면 배치 1 처리량도 두 배가 되는가? 안 된다면 무엇이 막고 있는가?
- 배치 32에서는 정밀도를 낮춘 효과가 배치 1보다 크게 나타나는가, 작게 나타나는가? 왜인가?
- 정확도 손실이 먼저 나타나는 태스크는 무엇인가? 그 태스크의 어떤 성질 때문인가?
- 1장에서 계산한 이론 상한과 비교하면, 정밀도를 낮춘 효과는 예측대로였는가?
장비에서 NVFP4가 지원되지 않으면 INT8/INT4나 지원되는 최저 정밀도로 대체하되, 보고서에 무엇으로 대체했고 그것이 결과 해석에 어떤 영향을 주는지 명시할 것.
참고 자료
- NVIDIA — NVFP4 소개 글 : 이 페이지의 양자화 그림 출처
- OCP Microscaling (MX) Formats 규격 — MXFP4/MXFP6/MXFP8의 공식 정의
- Jouppi et al., In-Datacenter Performance Analysis of a Tensor Processing Unit (ISCA 2017) — 시스톨릭 어레이 기반 가속기의 고전
- Wikipedia — High Bandwidth Memory : HBM 구조도 출처
- Hot Chips 발표 슬라이드 (hotchips.org) — 칩 아키텍처 1차 자료