Scale-up 패브릭 — 랙을 하나의 GPU로 만들기
「72개 GPU를 하나처럼 쓴다」는 말은 비유가 아니다. 다른 칩의 메모리를 자기 주소공간처럼 읽는다는 뜻이고, 그러려면 네트워크가 아니라 메모리 버스처럼 동작해야 한다. 이 요구가 얼마나 까다로운지 알면 왜 NVLink가 쉽게 복제되지 않는지도 보인다.
이 장을 마치면
- scale-up 패브릭과 scale-out 네트워크의 차이를 「의미론」 수준에서 설명할 수 있다.
- 스위치형과 메시·토러스 토폴로지의 트레이드오프를 통신 패턴과 연결해 설명할 수 있다.
- UALink·SUE 등 개방형 대안의 규격과 진행 상황을 NVLink와 비교할 수 있다.
- NCCL 대역폭을 실측해 scale-up과 scale-out의 격차를 체감하고 설계에 반영할 수 있다.
메시지를 보내는가, 메모리를 읽는가
5장에서 예고한 구분을 여기서 제대로 짚는다. scale-up과 scale-out의 차이는 속도가 아니라 프로그래밍 모델이다.
| Scale-out (InfiniBand · 이더넷) | Scale-up (NVLink · UALink) | |
|---|---|---|
| 동작 | 메시지를 보낸다 | 메모리를 읽는다 |
| 코드 형태 | send() / recv() / 집합 통신 API | 포인터 역참조 — 로드·스토어 |
| 지연 | µs 단위 | 수백 ns |
| 순서 보장 | 프로토콜이 처리 | 하드웨어가 보장해야 함 |
| 오류 허용 | 재전송 가능 | 재전송하면 이미 늦다 |
| 소프트웨어가 아는가 | 명시적으로 관리 | 몰라도 된다 — 그냥 메모리처럼 보인다 |
텐서 병렬(TP)은 한 행렬 곱을 여러 GPU가 쪼개서 하고 매 레이어마다 결과를 합친다. 이때 통신이 µs 단위면 계산보다 통신이 오래 걸려 병렬화의 의미가 사라진다. 그래서 TP는 반드시 scale-up 도메인 안에 있어야 한다.
반대로 데이터 병렬(DP)은 스텝 끝에 한 번만 그래디언트를 합치므로 µs 지연을 감출 수 있다. 그래서 DP는 scale-out으로 나가도 된다. 12장에서 병렬화를 배치할 때 이 규칙이 지도가 된다.
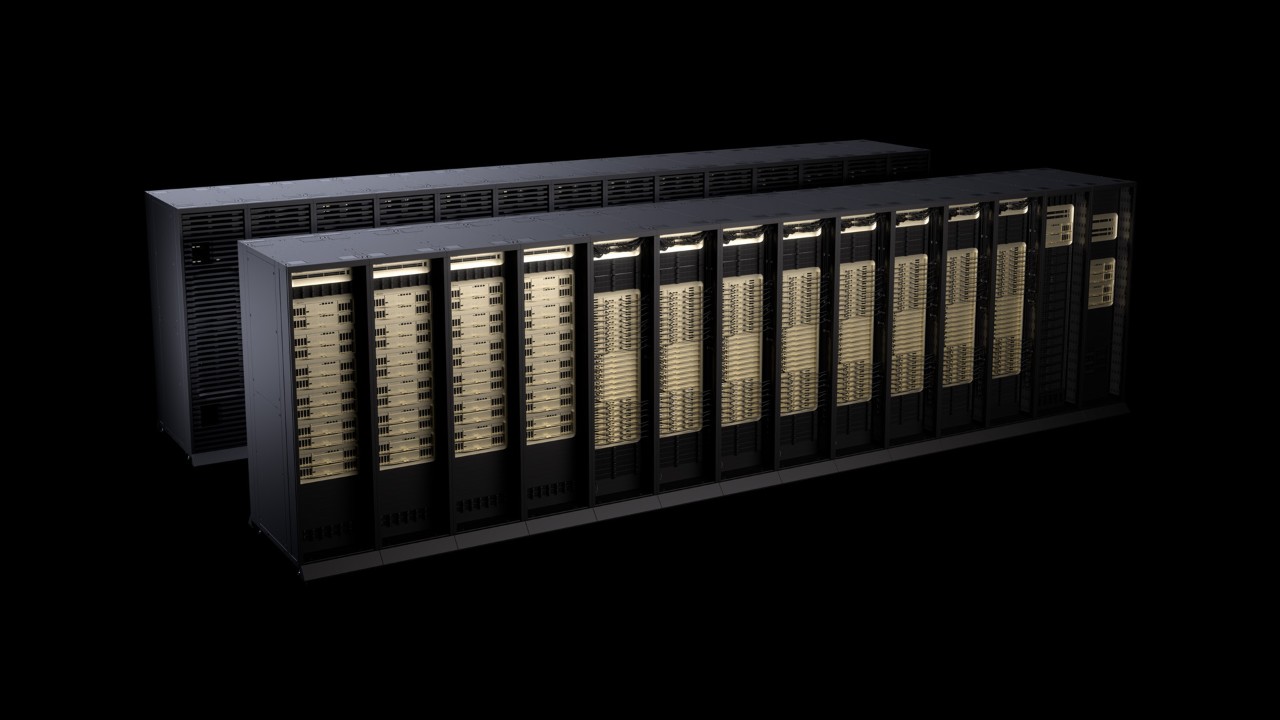
Vera Rubin NVL72 랙이 늘어선 모습 — 제품 렌더
렌더 이미지다. VR200은 2026년 하반기 출하 예정이므로 아직 설치 사진이 없다. 한 캐비닛 안의 GPU 72개가 하나의 메모리 도메인을 이루고, 그 캐비닛이 여러 대 늘어서면 그때부터는 9장의 scale-out 네트워크가 필요해진다. 이 사진에서 「어디까지가 하나의 GPU처럼 동작하는가」의 경계는 캐비닛 하나다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)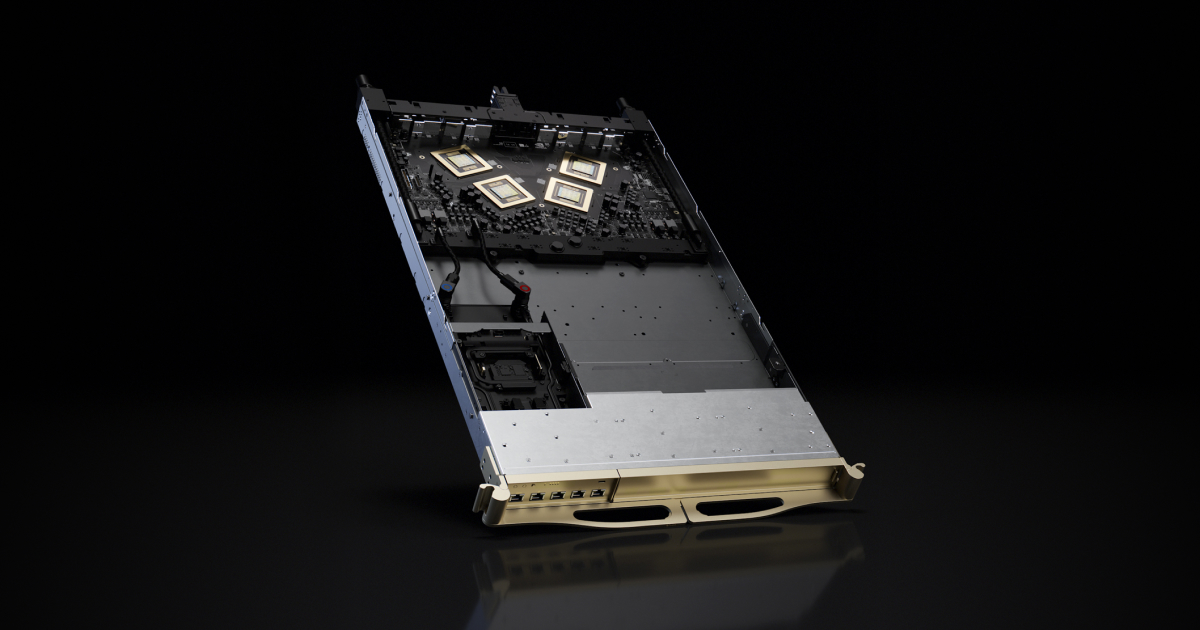
그것을 가능하게 하는 부품. 스위치 트레이가 모든 GPU를 같은 대역폭으로 연결한다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)스위치형과 토러스 — 무엇을 사고 무엇을 파는가
가속기를 묶는 방법은 크게 둘이다. 중앙에 스위치를 두거나, 이웃끼리 직결하거나.
같은 16개 칩을 연결하는 두 방식. 성능의 「성격」이 달라진다.
직접 제작 도해 · 자유 사용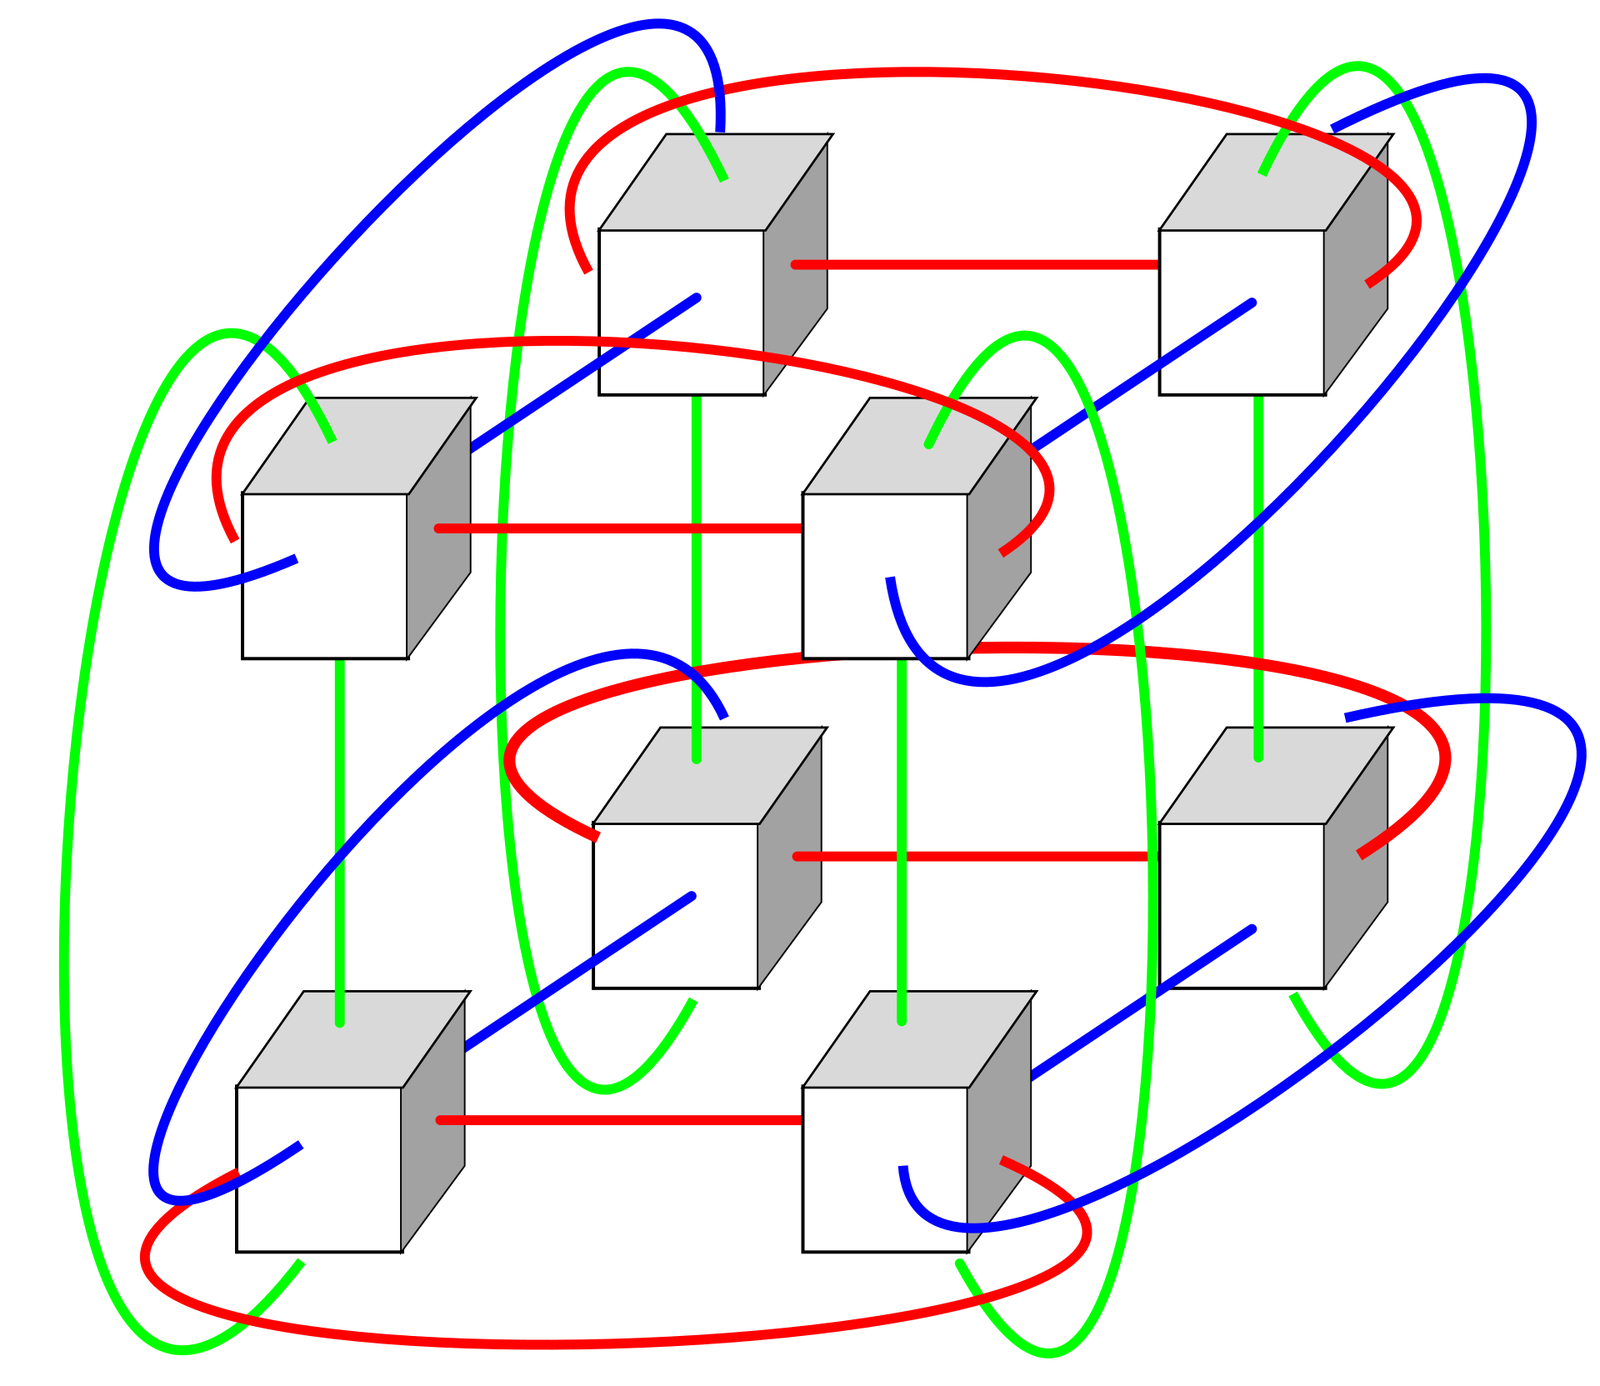
2×2×2 토러스의 구조. 각 축의 끝과 끝이 되감겨 연결된다(색깔 곡선). TPU와 Trainium이 이 계열의 토폴로지를 쓴다.
출처: おむこさん志望CC BY 2.5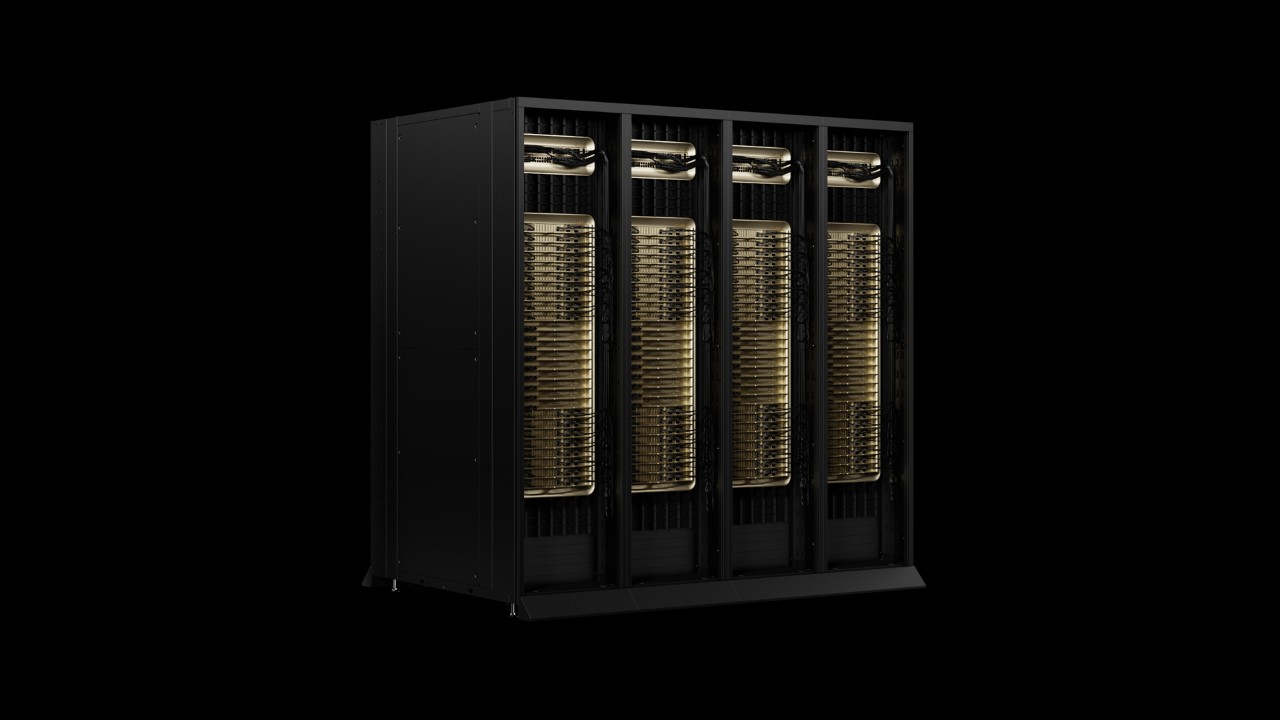
GB300 랙 4대 — 제품 렌더
렌더 이미지이며 실제 설치 사진이 아니다. 그럼에도 읽을 것은 있다 — 랙 앞면이 트레이로 빽빽하게 채워져 있고 빈 공간이 거의 없다. 이것이 밀도를 올린 결과이며, 그만큼 전력과 냉각이 한곳에 몰린다는 뜻이기도 하다(11장).
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)토폴로지의 계보 — 새로운 문제가 아니다
가속기를 어떻게 연결할 것인가는 컴퓨터 네트워크가 오래 고민해 온 문제다. 지금 쓰이는 구조들도 대부분 그때 나온 것이다.
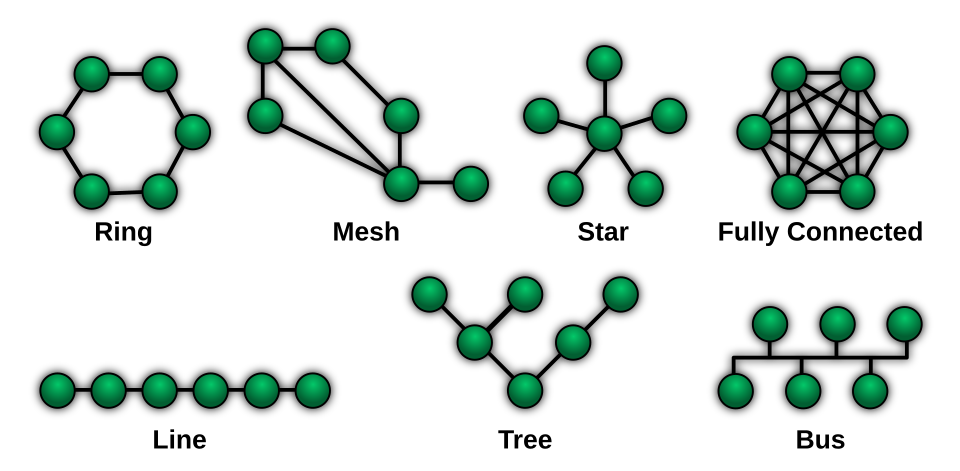
기본 토폴로지들 — 버스·링·스타·메시·트리
AI 클러스터가 쓰는 구조도 이 조합이다. 스위치형은 스타(별)에, 토러스는 링을 여러 차원으로 확장한 것에 해당한다. 9장의 fat-tree는 트리를 굵게 만든 변형이다. 새 이름이 붙어 나올 때 「기본형 중 무엇의 변형인가」를 물으면 이해가 빨라진다.
출처: en.wikipedia.org© en.wikipedia.org (교육 목적 인용)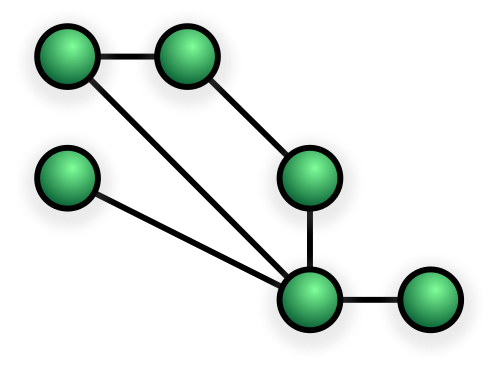
메시 — 이웃끼리 직접 연결
스위치 없이 이웃과만 연결한다. 싸지만 먼 노드끼리는 여러 홉을 거친다. 위 도해의 토러스는 이 메시의 끝과 끝을 이어 붙인 것으로, 그렇게 하면 최대 홉 수가 절반으로 준다.
출처: en.wikipedia.org© en.wikipedia.org (교육 목적 인용)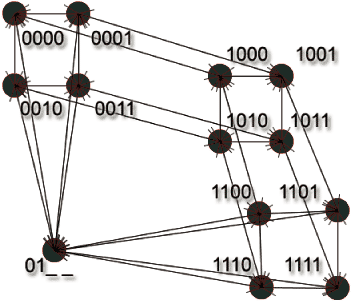
하이퍼큐브 — 차원을 늘려 홉 수를 줄인다
노드 수가 N이면 최대 홉이 log₂N 이 되는 구조다. 메시보다 홉이 훨씬 적지만 노드당 링크 수가 차원에 비례해 늘어난다. 「홉 수와 링크 수의 교환」이라는 이 트레이드오프가 모든 토폴로지 설계의 핵심이며, 8장에서 본 스위치형/토러스 선택도 같은 저울 위에 있다.
출처: Philippe GiabbanelliCC BY 3.0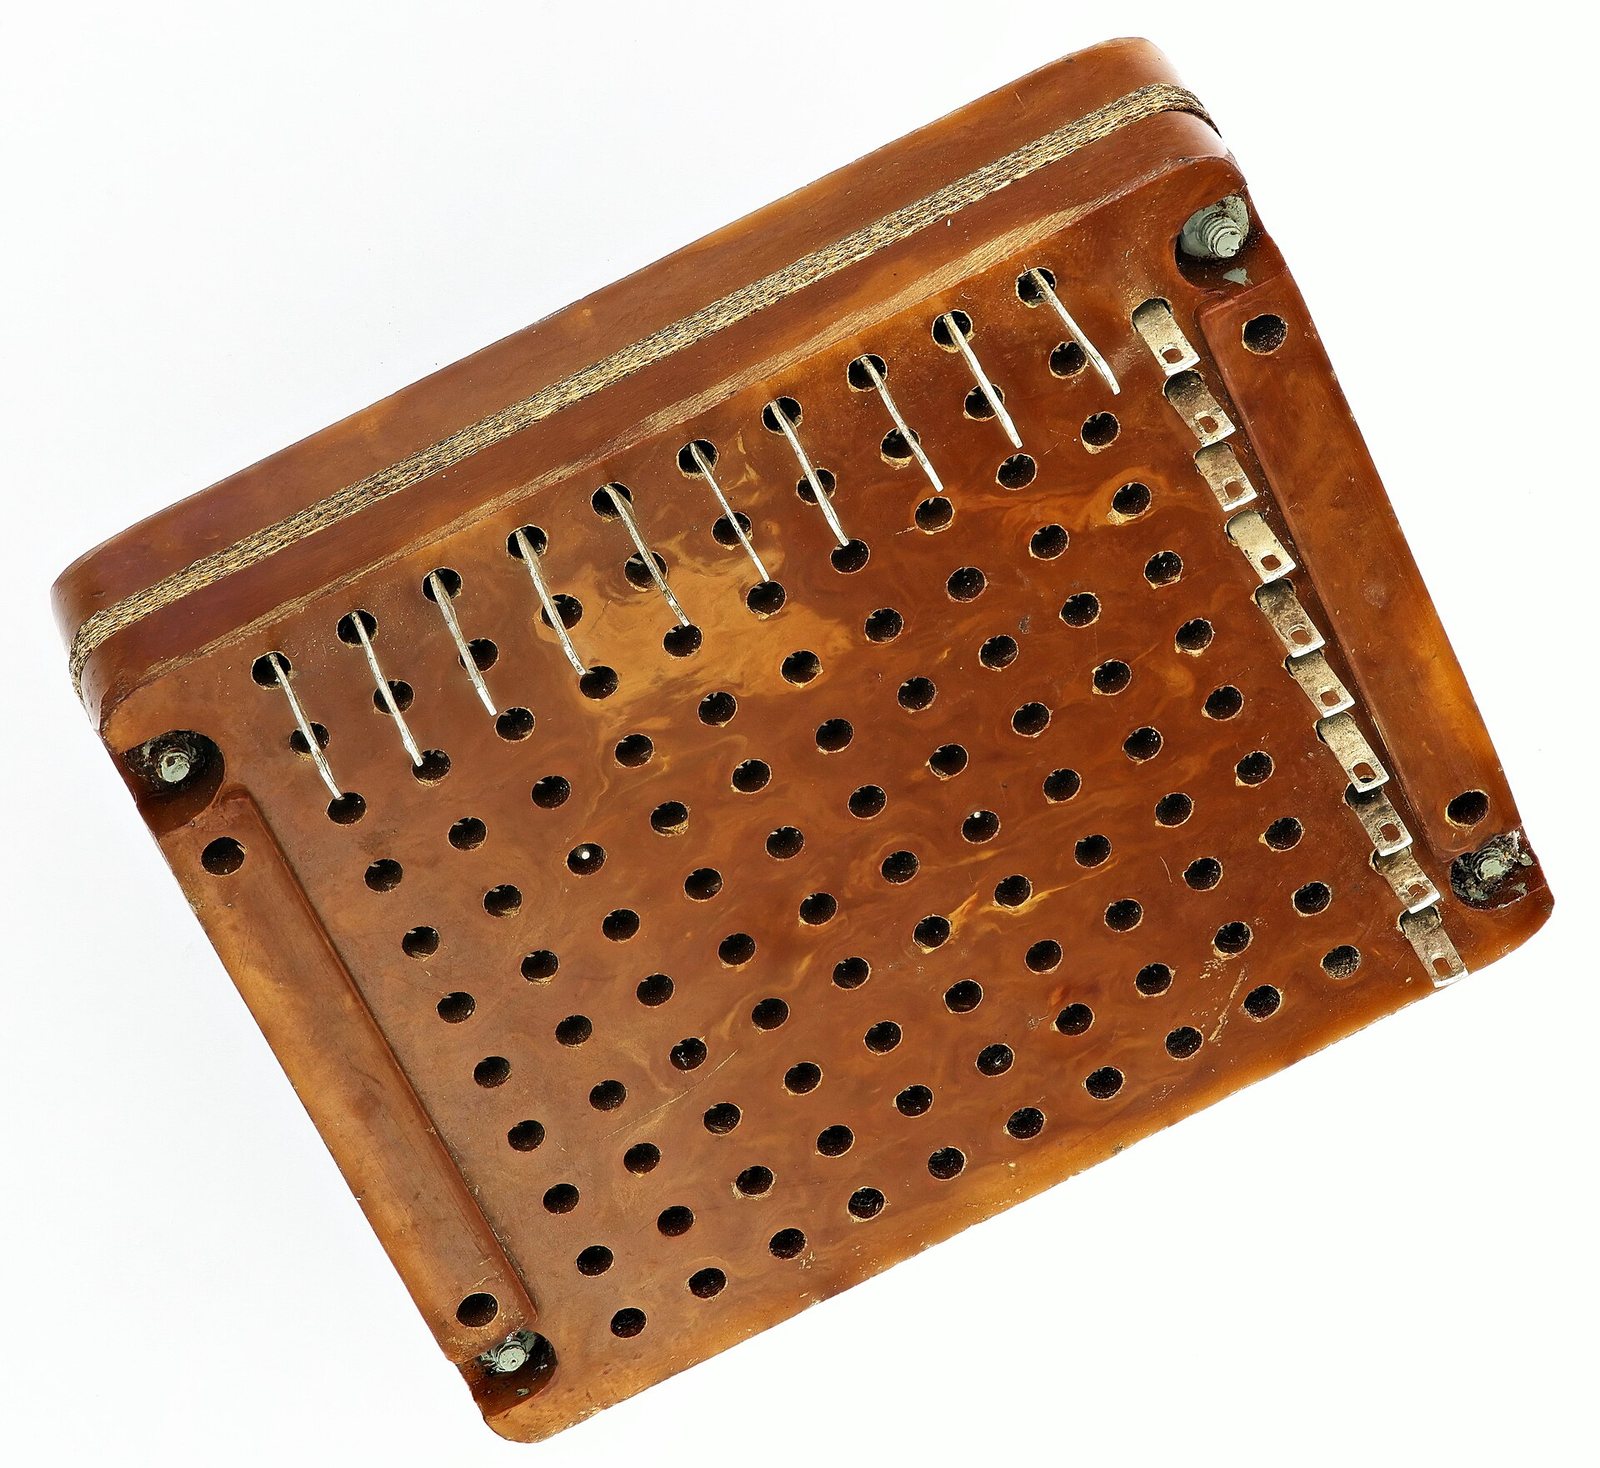
기계식 크로스바 스위치 — 스위치의 원형
가로줄과 세로줄이 교차하는 지점을 물리적으로 접점을 만들어 연결한다. 「어느 입력이든 어느 출력으로 보낼 수 있다」는 크로스바의 성질이 지금 NVSwitch가 하는 일과 개념적으로 같다. 다만 지금은 이 교차점이 수천 개이고 전자적으로 동작한다.
출처: Mister rfCC BY-SA 4.0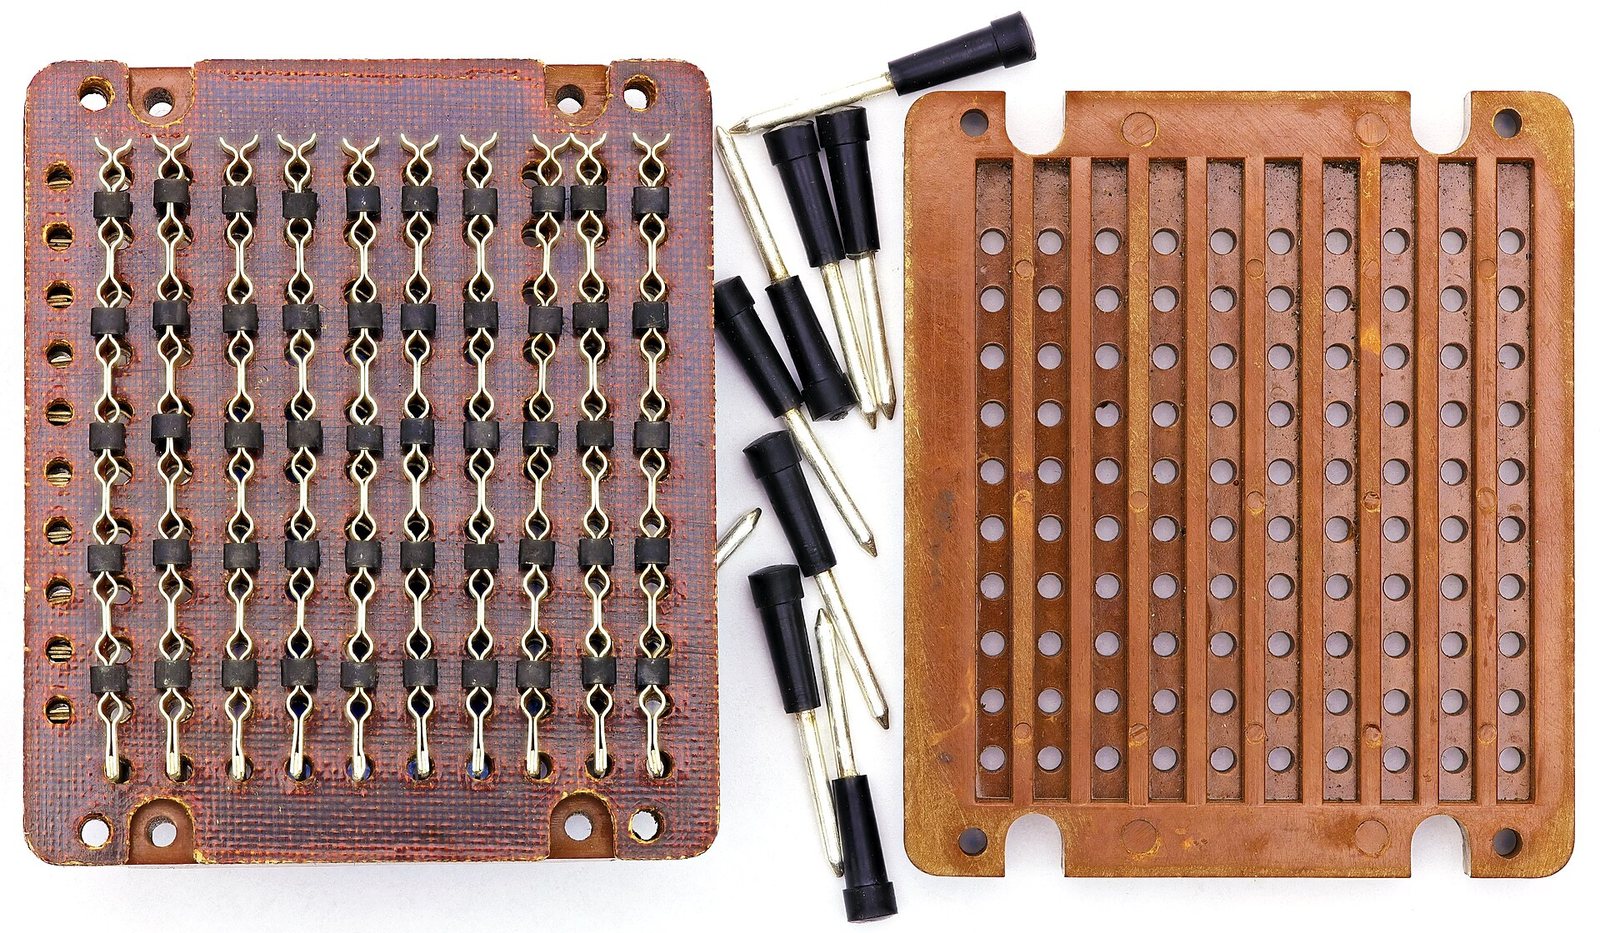
같은 장치의 내부 — 교차점의 수가 곧 비용
입력 N개, 출력 N개면 교차점이 N² 개 필요하다. 이 제곱 증가가 스위치가 비싼 근본 이유이며, 그래서 규모가 커지면 크로스바 하나로 다 붙이지 못하고 9장의 리프–스파인처럼 여러 단으로 쌓게 된다.
출처: Mister rfCC BY-SA 4.0어느 쪽이 옳은가는 누가 소프트웨어를 통제하는가에 달려 있다. 6장에서 본 논리가 여기서 그대로 반복된다 — 남에게 파는 회사는 고객의 통신 패턴을 모르니 균일한 스위치형이 안전하고, 자기가 쓰는 회사는 컴파일러가 배치를 최적화할 수 있으니 스위치를 아끼는 편이 이득이다.
집합 통신 — all-reduce는 실제로 어떻게 도는가
scale-up 패브릭 위에서 실제로 오가는 것은 대부분 집합 통신(collective)이다. 「모든 GPU가 각자 가진 값을 더해서 모두가 그 합을 갖는다」 같은 연산이다. 대역폭 숫자만 봐서는 성능을 알 수 없는 이유가 여기 있다 — 같은 대역폭이라도 어떤 알고리즘으로 도느냐에 따라 걸리는 시간이 몇 배 달라진다.
| 집합 연산 | 무엇을 하는가 | 어디에 쓰이는가 |
|---|---|---|
| all-reduce | 모든 GPU의 값을 합쳐 모두에게 돌려준다 | 데이터 병렬의 그래디언트 합산 (12장) |
| all-gather | 각자 가진 조각을 모아 모두가 전체를 갖게 한다 | FSDP에서 가중치 복원 |
| reduce-scatter | 합치되 각자 자기 조각만 갖는다 | FSDP에서 그래디언트 분배 |
| all-to-all | 각자가 각자에게 다른 데이터를 보낸다 | MoE의 전문가 라우팅 — 가장 까다롭다 |
| broadcast | 한 GPU의 값을 모두에게 | 파라미터 초기화, 체크포인트 복원 |
링(ring)과 트리(tree) — 두 가지 도는 방식
N개의 GPU가 all-reduce를 한다고 하자. 방법이 여럿이다.
| 방식 | 어떻게 도는가 | 통신량 | 지연 | 언제 유리한가 |
|---|---|---|---|---|
| Ring | GPU들을 고리로 잇고 데이터를 한 바퀴 돌린다 | GPU당 2(N-1)/N × 데이터 — N과 거의 무관 | N에 비례해 늘어남 | 데이터가 클 때 (대역폭 지배) |
| Tree | 이진 트리로 합치고 다시 뿌린다 | 더 많음 | log N 에 비례 — 훨씬 짧다 | 데이터가 작을 때 (지연 지배) |
| 하이브리드 | 노드 안은 트리, 노드 밖은 링 등 계층별로 다르게 | — | — | 실제 구현체가 쓰는 방식 |
NCCL 같은 통신 라이브러리는 메시지 크기와 토폴로지를 보고 알고리즘을 자동으로 고른다. 그래서 8장 실습에서 메시지 크기별로 대역폭을 재라고 한 것이다 — 작은 메시지와 큰 메시지에서 나오는 값이 다른 알고리즘의 결과다.
그리고 이것이 토폴로지 인식 스케줄링이 필요한 이유이기도 하다(12장). 같은 잡의 GPU가 랙 안에 몰려 있으면 링이 짧아지고, 여러 랙에 흩어져 있으면 랙 경계를 여러 번 넘어야 해서 느려진다. 스케줄러가 배치를 잘못하면 통신 라이브러리가 아무리 똑똑해도 소용없다.
MoE의 all-to-all이 특히 어려운 이유
다른 집합 연산은 누가 누구에게 무엇을 보낼지 미리 안다. 그래서 스케줄을 짜 놓을 수 있다. 그런데 MoE의 전문가 라우팅은 토큰이 어느 전문가로 갈지 실행해 봐야 안다.
- 부하 불균형 — 어떤 전문가에 토큰이 몰리면 그 GPU만 바빠지고 나머지는 기다린다.
- 통신량 예측 불가 — 미리 버퍼를 잡아 두기 어렵고, 통신을 계산 뒤로 숨기기도 어렵다.
- 대책 — 전문가당 토큰 수 상한(capacity factor)을 두거나, 라우팅을 보정해 균형을 맞추거나, 통신을 여러 단계로 쪼개 겹친다.
MoE는 「연산량을 줄이는 대신 통신 문제를 만드는」 구조다. 14장에서 봤듯 메모리도 전체 파라미터만큼 필요하다. MoE가 항상 유리한 것이 아니라, 통신이 싼 환경(랙 안 scale-up)에서만 유리하다.
도메인이 커지면 무엇이 문제가 되는가
NVL72의 72가 NVL576의 576이 되고, 그 이상으로 가면 무엇이 달라지는가? 대역폭만의 문제가 아니다.
| 커질 때 생기는 문제 | 왜 | 어떻게 대응하나 |
|---|---|---|
| 케이블 길이 | 랙 여러 개에 걸치면 신호가 달려야 할 거리가 늘어난다 | 구리로는 한계 → 광으로 전환 (9장의 CPO) |
| 전력 밀도 | 한 도메인 안의 GPU가 늘면 그만큼 한곳에 전력이 몰린다 | 800 VDC 배전, 사이드카 랙 (11장) |
| 냉각 | 같은 이유로 열도 한곳에 몰린다 | 액체냉각 필수, CDU 용량 재설계 (11장) |
| 장애 영향 범위 | 도메인 하나가 죽으면 그 안의 GPU 전부가 멈춘다 | 체크포인트 간격 조정, 도메인 분할 설계 (12·15장) |
| 스위치 계층 | 한 계층으로 다 못 붙이면 스위치를 또 쌓아야 한다 | 홉이 늘어 지연 증가 — 설계 시 계산으로 확인 (9장) |
scale-up 도메인은 필요한 병렬화 차수만큼만 크면 된다. TP 8 × EP 8을 쓴다면 64개짜리 도메인이면 충분하고, 그 이상은 낭비다.
거꾸로 모델이 커져 TP 차수를 늘려야 하면 도메인도 함께 커져야 한다. NVL72 → NVL576으로 가는 로드맵이 있는 이유가 이것이며, 17장 설계에서 「몇 년 뒤의 모델까지 감당할 것인가」를 물어야 하는 이유이기도 하다.
개방형 대안은 어디까지 왔는가
NVLink의 대안을 만들려는 시도는 여럿이다. 규격의 존재와 실물의 존재는 다르므로, 「규격이 나왔다」와 「상호운용되는 물건이 나왔다」를 구분해서 읽어야 한다.
| 무엇인가 | 레인당 속도 | 규모 | 상태 | |
|---|---|---|---|---|
| NVLink 5 → 6 | NVIDIA 전용 규격 | — | NVL72 → 확대 | 성숙 · 대량 출하 중 |
| UALink 1.0 | 개방 규격 (컨소시엄) | 200 Gbps | 최대 1,024 가속기 | 규격 공개 |
| UALink 2.0 | 차기 규격 | 400 Gbps | — | 인네트워크 컴퓨팅 · UCIe 칩렛 포함 |
| Broadcom SUE · ESUN | 이더넷 기반 scale-up | — | — | 진행 중 |
| Upscale AI 스위치 | 신규 스위치 공급자 | — | — | 2026년 4분기 예고 |
GPU당 scale-up 대역폭 비교
| GPU당 scale-up 대역폭 | |
|---|---|
| NVLink 5 (Blackwell 세대) | 1.8 TB/s |
| AMD MI455X | 약 3.6 TB/s (AMD 발표) |
| NVLink 6 (Rubin 세대) | 랙 총합 260 TB/s |
- 대역폭은 상한이지 실효값이 아니다. all-reduce 같은 집합 통신에서 실제로 몇 %를 쓰는지는 토폴로지와 알고리즘이 결정한다.
- 지연이 빠져 있다. TP처럼 매 레이어마다 동기화하는 경우 지연이 대역폭보다 중요하다.
- 소프트웨어 성숙도가 빠져 있다. 같은 하드웨어에서도 통신 라이브러리에 따라 실효 대역폭이 크게 달라진다.
그래서 아래 실습에서 숫자가 아니라 실측을 한다.
NVLink Fusion — 규격을 여는 쪽의 수
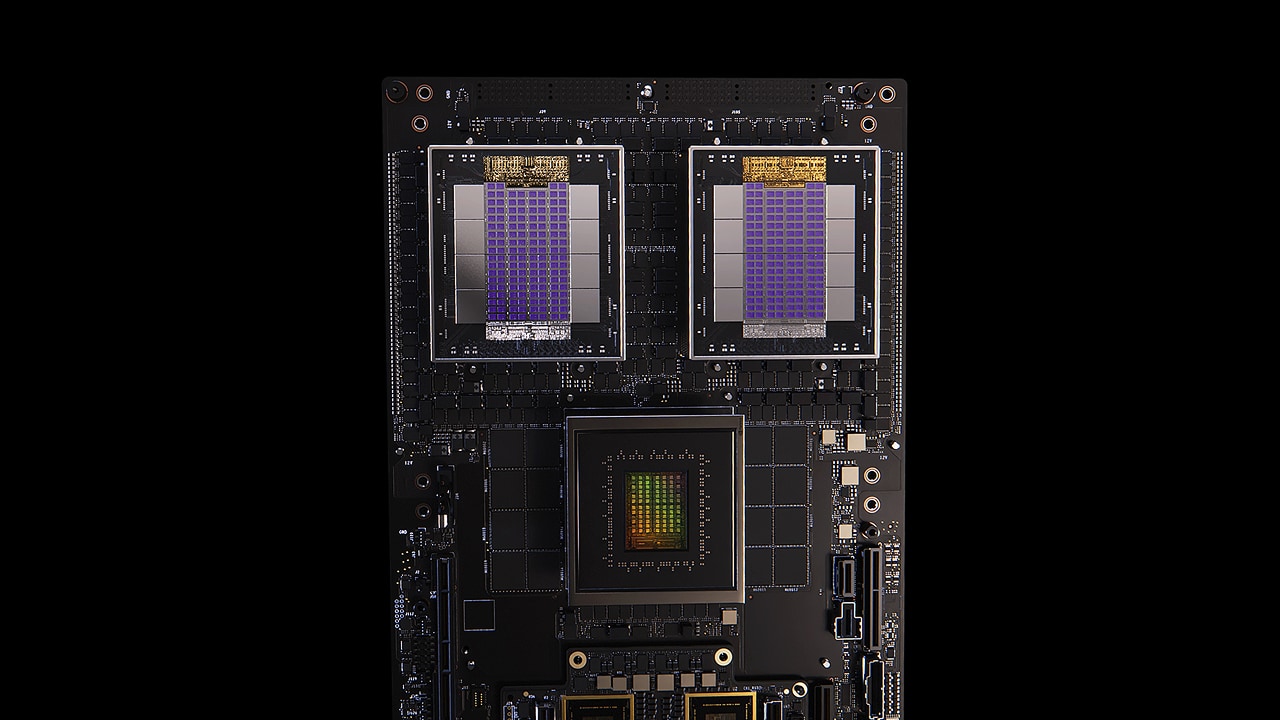
NVLink Fusion 대응 보드. 4장에서 토론했듯, 독점 규격을 여는 것은 개방형 진영이 자리 잡기 전에 「우리 쪽에 붙을 수 있다」는 선택지를 주는 수이기도 하다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)실습 — 두 계층의 격차를 손으로 재기
목표: DGX Spark 2대를 직결해 NCCL 집합 통신 대역폭을 측정하고, 랙 내부 NVLink 대비 몇 배 느린지 수치로 확인한다. 이 격차가 12장 병렬화 배치의 근거가 된다.
1단계 — 연결과 확인
# 두 대를 QSFP 포트로 직결한 뒤
ip -br link                       # 링크가 올라왔는지
ip addr add 10.0.0.1/24 dev <iface>   # 1번 장비
ip addr add 10.0.0.2/24 dev <iface>   # 2번 장비
ping 10.0.0.2

# RDMA가 되는지 (가능한 경우)
ibv_devinfo
ibstat
2단계 — 대역폭 측정
# 단일 장비 안에서 (기준값)
nccl-tests/build/all_reduce_perf -b 8 -e 1G -f 2 -g 1

# 두 장비에 걸쳐서
mpirun -np 2 -H 10.0.0.1,10.0.0.2 \
  nccl-tests/build/all_reduce_perf -b 8 -e 1G -f 2 -g 1

# 메시지 크기별로 기록할 것: 8B, 1KB, 1MB, 64MB, 1GB
3단계 — 기록표
| 메시지 크기 | 장비 1대 (GB/s) | 장비 2대 (GB/s) | 비율 | 지연 (µs) |
|---|---|---|---|---|
| 8 B | ||||
| 1 KB | ||||
| 1 MB | ||||
| 64 MB | ||||
| 1 GB |
4단계 — 해석
- 작은 메시지와 큰 메시지 중 어느 쪽에서 격차가 더 큰가? 왜 그런가? (힌트: 작은 메시지는 지연이, 큰 메시지는 대역폭이 지배한다)
- 측정한 노드 간 대역폭을 NVL72의 GPU당 NVLink 대역폭(1.8~3.6 TB/s)과 비교하면 몇 배 차이인가?
- 이 격차를 알고 나면, 70B 모델을 2대에 나눠 학습할 때 어떤 병렬화를 써야 하고 어떤 것은 쓰면 안 되는가? 근거를 대라.
- 만약 이 링크로 텐서 병렬(TP)을 시도하면 어떤 일이 벌어질지 예측하고, 가능하다면 실제로 돌려서 확인하라.
장비 구성상 RDMA나 NCCL 멀티노드가 안 되면, iperf3 로 순수 대역폭만 측정하고 지연은 ping·sockperf 로 대체하되 무엇을 대체했고 그것이 해석에 어떤 한계를 주는지 보고서에 명시할 것.
제출물
측정표 + 4단계 해석 (A4 3장 이내). 그래프를 한 장 넣으면 가산점.
- NVLink가 쉽게 복제되지 않는 이유는 무엇인가? 대역폭 말고 무엇이 어려운가?
- UALink가 성공하려면 무엇이 먼저 일어나야 하는가? 규격? 스위치 칩? 소프트웨어?
- scale-up 도메인이 계속 커지면(72 → 576 → 그 이상) 어떤 새로운 문제가 생기는가?
참고 자료
- UALink Consortium 규격 문서
- NVIDIA NVLink / NVSwitch 기술 문서 및 DGX SuperPOD
- NCCL 문서 및 nccl-tests 저장소
- OCP Global Summit — scale-up 관련 세션