CPU-GPU 결합과 노드 아키텍처 — DGX Spark 해부
GPU만 빠르면 되는 것이 아니다. 데이터를 읽어 들이고, 전처리하고, 에이전트를 오케스트레이션하는 일은 여전히 CPU가 한다. 그리고 CPU와 GPU 사이의 통로가 좁으면 그 통로가 곧 병목이 된다. NVIDIA·AMD·Google·AWS가 모두 GPU 옆에 자기 CPU를 두게 된 이유가 여기에 있다.
이 장을 마치면
- PCIe 결합과 코히어런트 결합(NVLink-C2C)의 차이를 데이터 이동 관점에서 설명할 수 있다.
- 통합 메모리가 추론에 주는 이점과 그 대가(대역폭 희생)를 설명할 수 있다.
- 각 벤더가 자체 CPU를 만드는 이유를 기술적·경제적으로 설명할 수 있다.
- DGX Spark(GB10)의 구조를 랙 스케일 제품의 축소판으로 해석할 수 있다.
nvidia-smi topo등으로 실제 장비의 토폴로지를 읽고 대역폭을 측정할 수 있다.
GPU 옆에 CPU가 필요한 이유
학습 잡에서 GPU 사용률이 60%밖에 안 나온다면, 원인의 상당수는 GPU 바깥에 있다.
- 데이터 로딩 — 스토리지에서 읽어 디코딩·토크나이징하는 작업. 이미지·비디오가 섞이면 CPU 부하가 급증한다.
- 전처리와 증강 — 텐서로 만들어 GPU에 올리기 전까지의 모든 것.
- 에이전트 오케스트레이션 — 추론 시점에 도구 호출, 검색, 분기 판단. 에이전틱 워크로드가 늘수록 이 부분의 비중이 커진다.
- 통신 스케줄링 — 어느 텐서를 언제 보낼지 결정하고 커널을 띄우는 일.
이 작업들이 늦으면 GPU는 기다린다. 그리고 CPU가 준비한 데이터를 GPU로 옮기는 통로가 PCIe라면, 그 통로는 HBM보다 100배 이상 좁다.
세 가지 결합 방식
CPU와 GPU를 붙이는 세 가지 방식. 차이의 본질은 하나 — 메모리를 복사하는가, 공유하는가.
직접 제작 도해 · 자유 사용코히어런트 결합이 실제로 바꾸는 것
NVLink-C2C 같은 코히어런트 링크는 단순히 「빠른 PCIe」가 아니다. 캐시 일관성(coherence) 이 보장되므로, GPU가 CPU 메모리의 주소를 그대로 참조할 수 있고 명시적인 복사 코드가 필요 없어진다. 프로그래밍 모델 자체가 바뀐다.
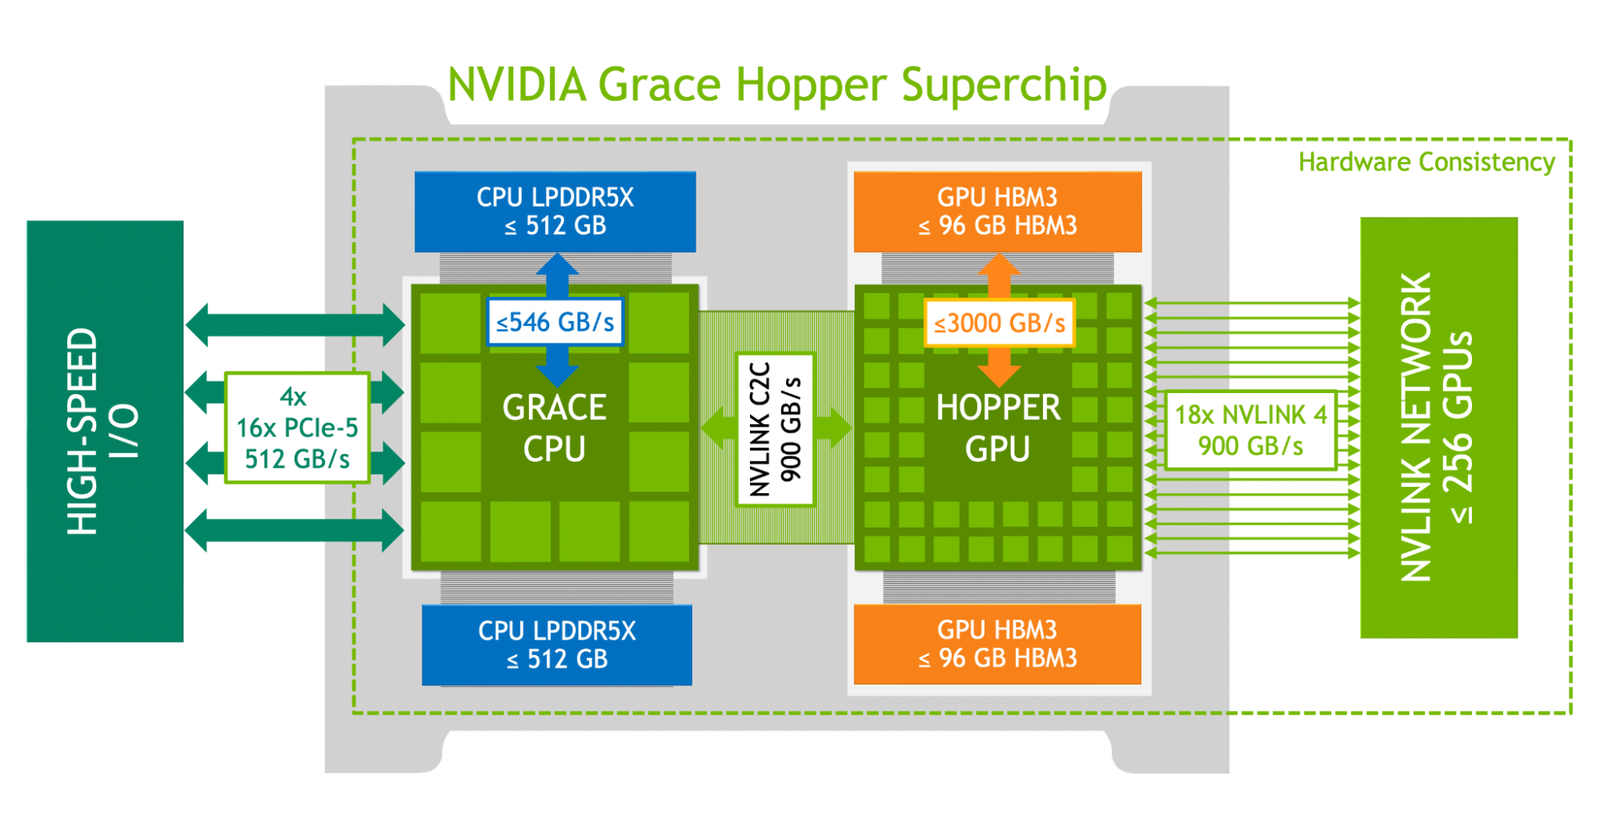
Grace Hopper 슈퍼칩 개요. CPU와 GPU가 C2C 링크로 묶여 하나의 메모리 공간을 이룬다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)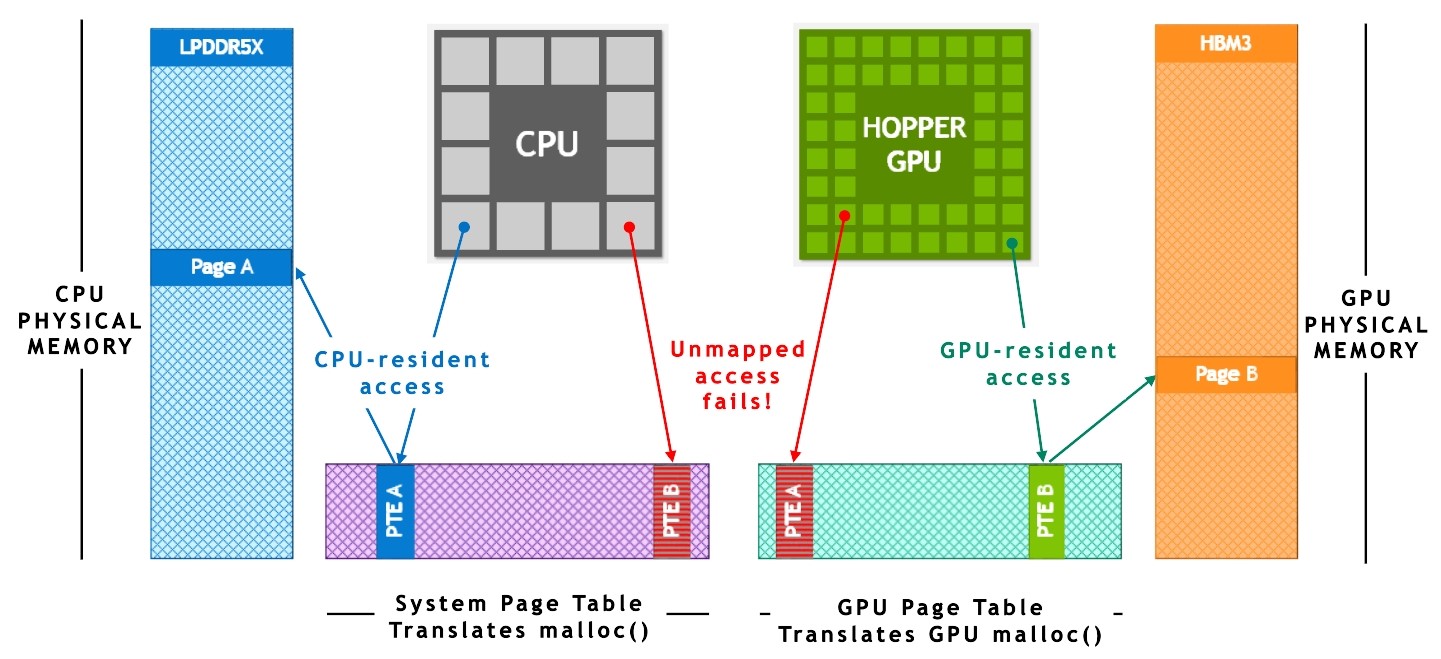
코히어런시가 없을 때의 모습 — CPU와 GPU가 각자 다른 페이지 테이블을 갖는다. 이 상태에서는 데이터를 옮길 때마다 명시적 관리가 필요하다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)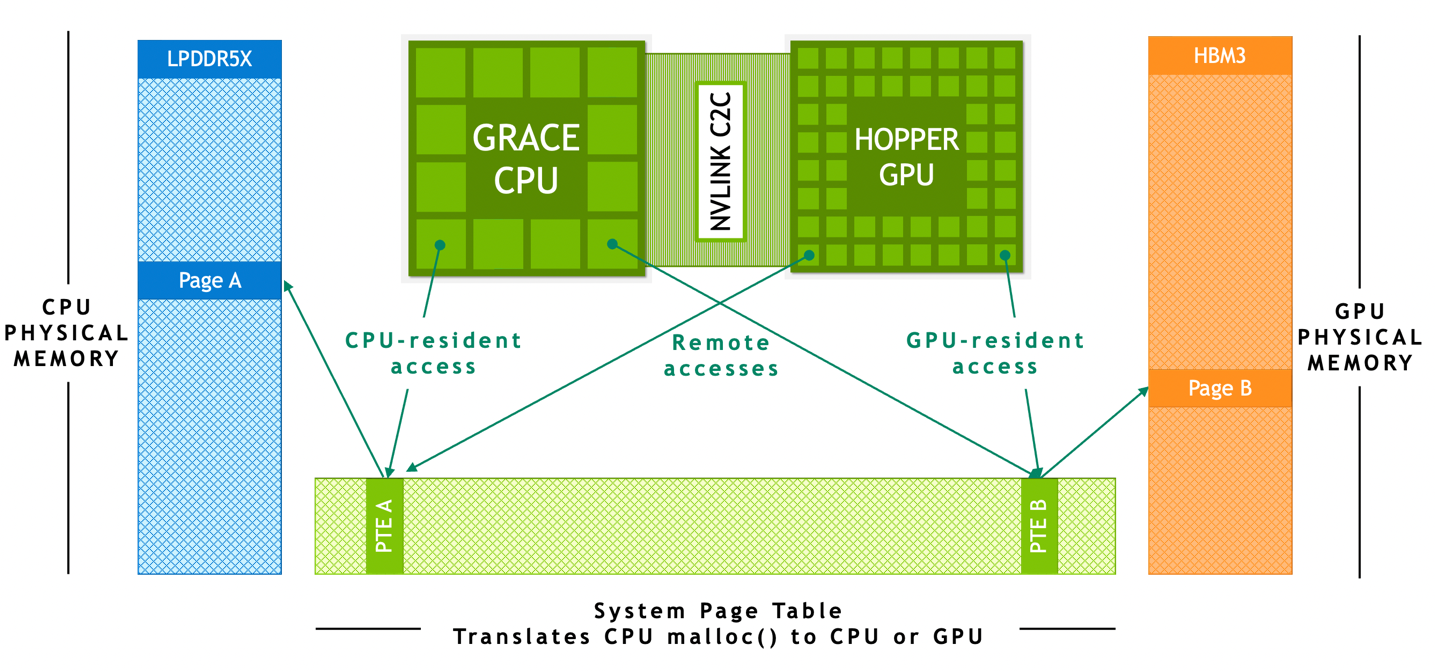
주소 변환 서비스(ATS) — CPU와 GPU가 같은 가상 주소를 공유하는 구조
CPU와 GPU가 각자 다른 페이지 테이블을 갖는 대신, 같은 가상 주소를 같은 물리 메모리로 번역하도록 맞춘다. 이것이 되어야 GPU 커널이 CPU가 만든 포인터를 그대로 역참조할 수 있다. 「빠른 링크」만으로는 부족하고, 주소 체계까지 통일해야 한다는 뜻이다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)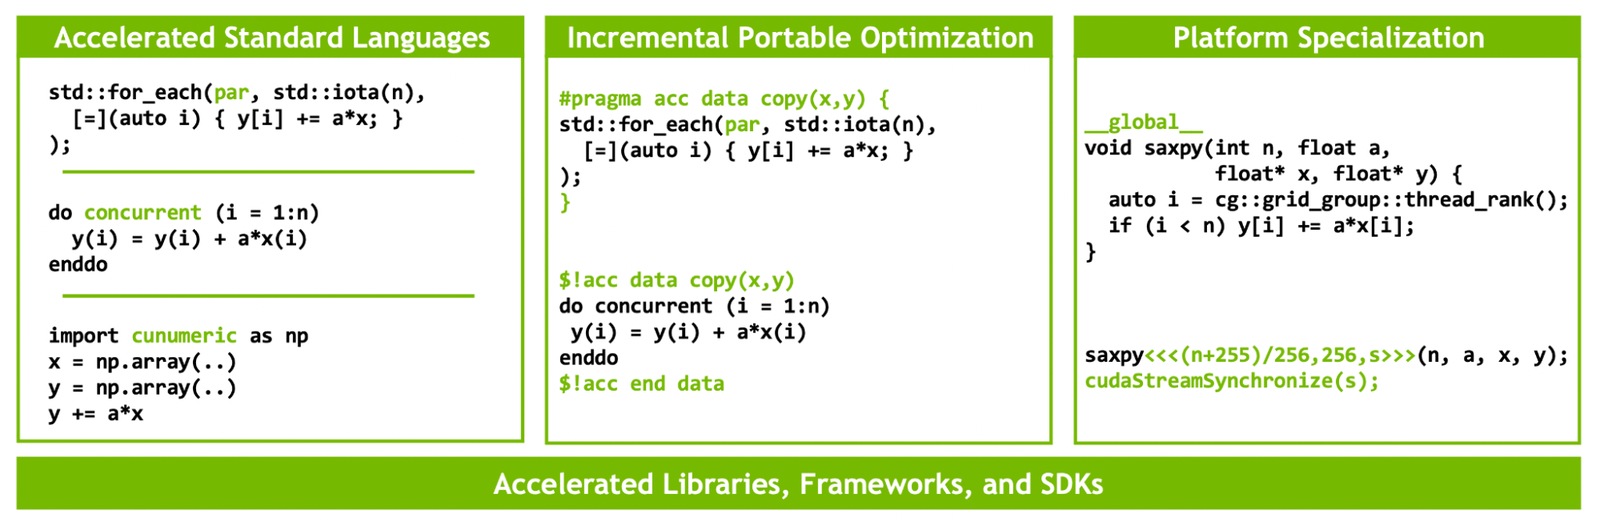
같은 계산을 세 가지 방식으로 — 표준 언어 · 지시문 · CUDA 커널
왼쪽은 C++/Fortran/Python 표준 문법만으로 병렬 실행되게 한 것, 가운데는 OpenACC 같은 지시문(pragma)을 얹은 것, 오른쪽은 CUDA 커널을 직접 쓴 것이다. 통합 메모리가 되면 왼쪽 방식으로도 쓸 만한 성능이 나온다 — 데이터를 어디로 복사할지 관리하는 코드가 필요 없어지기 때문이다. 하드웨어 설계가 소프트웨어 작성 방식까지 규정하는 전형적인 예이며, 5장에서 볼 「수직 통합이 파는 것」의 실체이기도 하다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)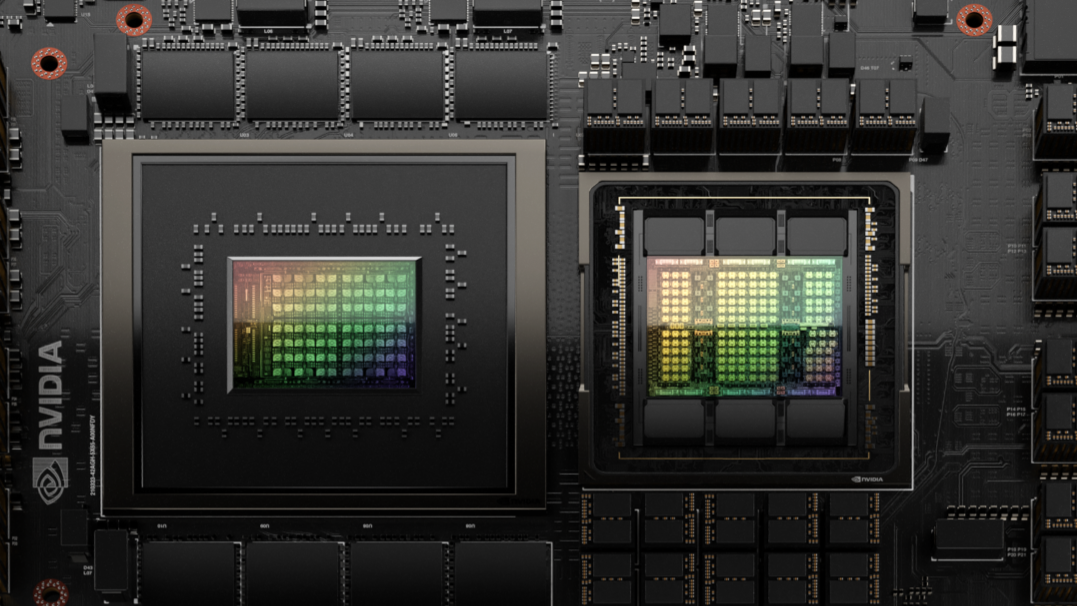
슈퍼칩 패키지 전체 — CPU와 GPU가 한 보드 위에
두 개의 큰 칩과 그 주변의 메모리가 하나의 모듈을 이룬다. 이것이 랙에 꽂히는 최소 단위이며, 4장에서 볼 컴퓨트 트레이가 이런 모듈을 여러 장 담은 것이다. 3장 실습에서 다루는 DGX Spark의 GB10도 같은 관계를 훨씬 작은 규모로 구현한 것이다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)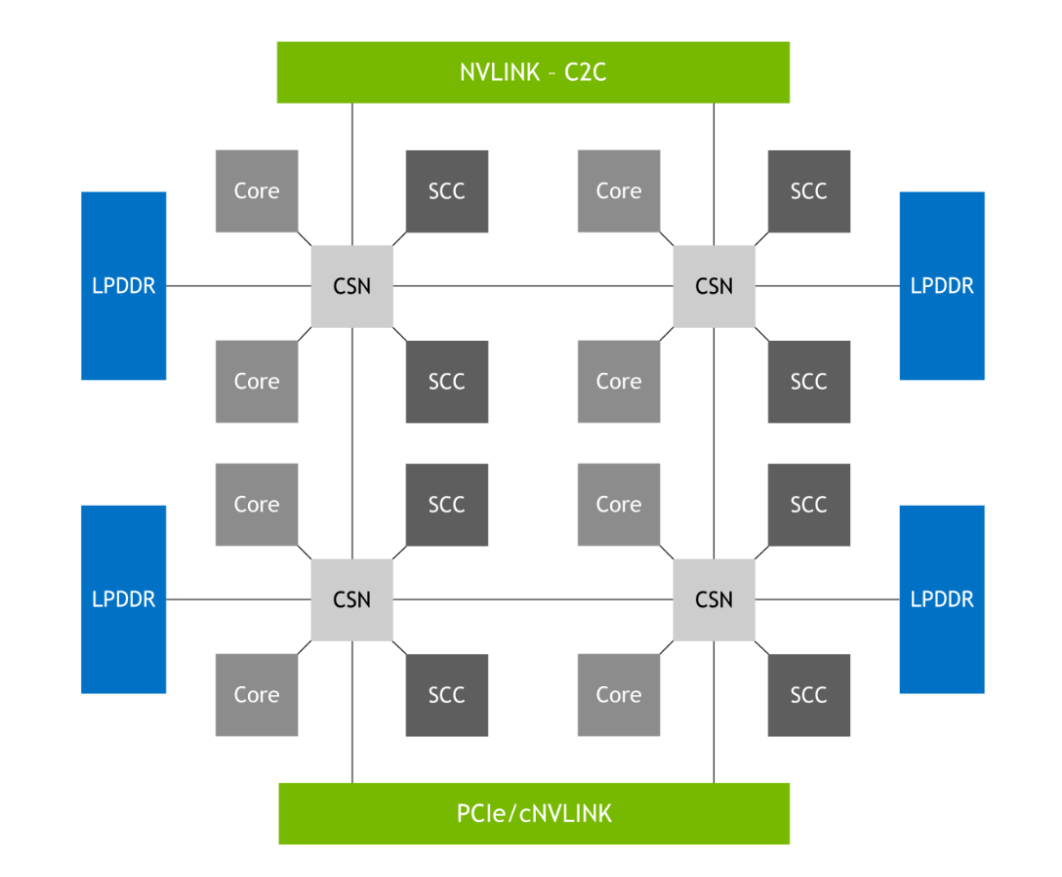
칩 내부의 스케일러블 코히어런시 패브릭(SCF)
CPU 다이 안에서도 코어와 메모리 컨트롤러를 잇는 내부 네트워크가 필요하다. 코어가 수십~수백 개가 되면 칩 안이 이미 하나의 작은 네트워크다. 8장에서 랙 안 GPU를 묶는 문제와 구조적으로 같은 문제를 한 단계 아래에서 푸는 셈이다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)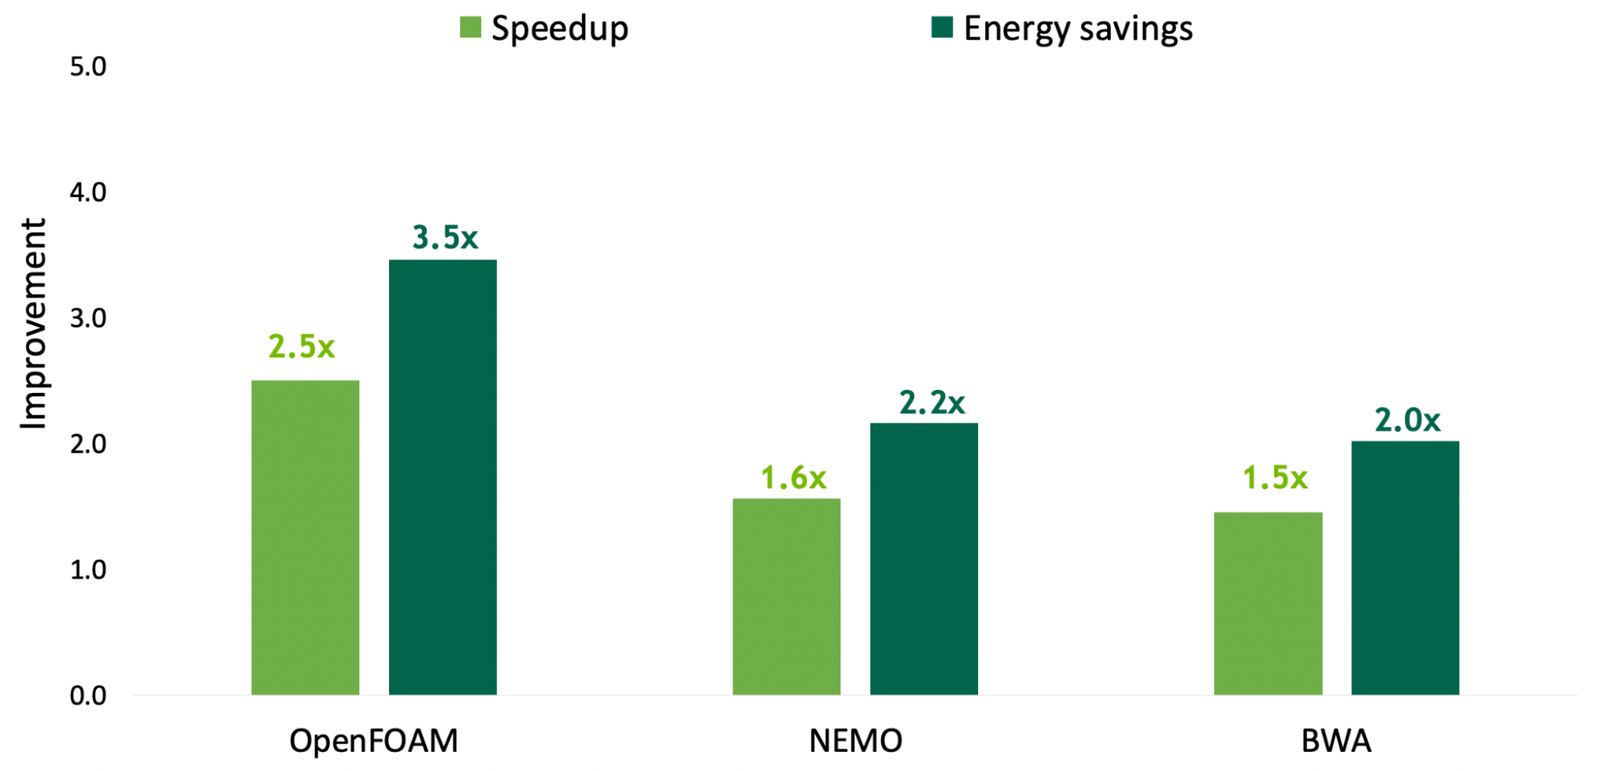
Grace CPU의 HPC 애플리케이션 성능·에너지 개선 (벤더 제시)
OpenFOAM(전산유체) 2.5배 · NEMO(해양모델) 1.6배 · BWA(유전체 정렬) 1.5배의 속도 향상과 각각 3.5·2.2·2.0배의 에너지 절감을 제시한다. 여기 나온 것은 전부 AI가 아니라 전통적 HPC 애플리케이션이라는 점에 주의하자 — CPU가 주역인 워크로드라 개선이 잘 드러나는 사례들이다. AI 학습에서 CPU가 병목인지는 12장 실습처럼 직접 프로파일링해야 알 수 있다.
출처: developer.nvidia.com© developer.nvidia.com (교육 목적 인용)통합 메모리는 HBM보다 큰 모델을 일단 올릴 수 있게 해준다. HBM에 안 들어가는 부분을 CPU 쪽 메모리에 두고 참조하는 것이다. 물론 그쪽은 훨씬 느리므로 성능은 떨어지지만, 「아예 못 돌린다」와 「느리게라도 돌린다」의 차이는 크다. 10장의 KV 캐시 오프로딩도 같은 발상이다.
왜 모두 자기 CPU를 만드는가
| 벤더 | CPU | 명령어 집합 | 짝이 되는 가속기 | 만든 이유 |
|---|---|---|---|---|
| NVIDIA | Grace → Vera | Arm | Hopper → Blackwell → Rubin | NVLink-C2C를 붙이려면 CPU 다이를 직접 설계해야 한다 |
| AMD | EPYC Venice (2nm, 최대 256코어 Zen 6) | x86 | Instinct MI455X | CPU·GPU를 모두 가진 유일한 회사 — 랙 전체를 자사 제품으로 채운다 |
| Axion | Arm | TPU | 자사 워크로드 맞춤 + 전력 효율 | |
| AWS | Graviton | Arm | Trainium / Inferentia | 인스턴스 단가 절감이 곧 경쟁력 |
표를 관통하는 논리는 두 가지다.
- 기술적 이유 — 코히어런트 링크는 양쪽 다이를 다 설계할 수 있어야 만들 수 있다. 남의 CPU에 NVLink-C2C를 붙일 수는 없다.
- 경제적 이유 — 랙 단위로 팔리는 시장에서 CPU를 남에게 사면 그만큼 마진이 빠진다. 규모가 충분히 크면 직접 만드는 편이 싸다.
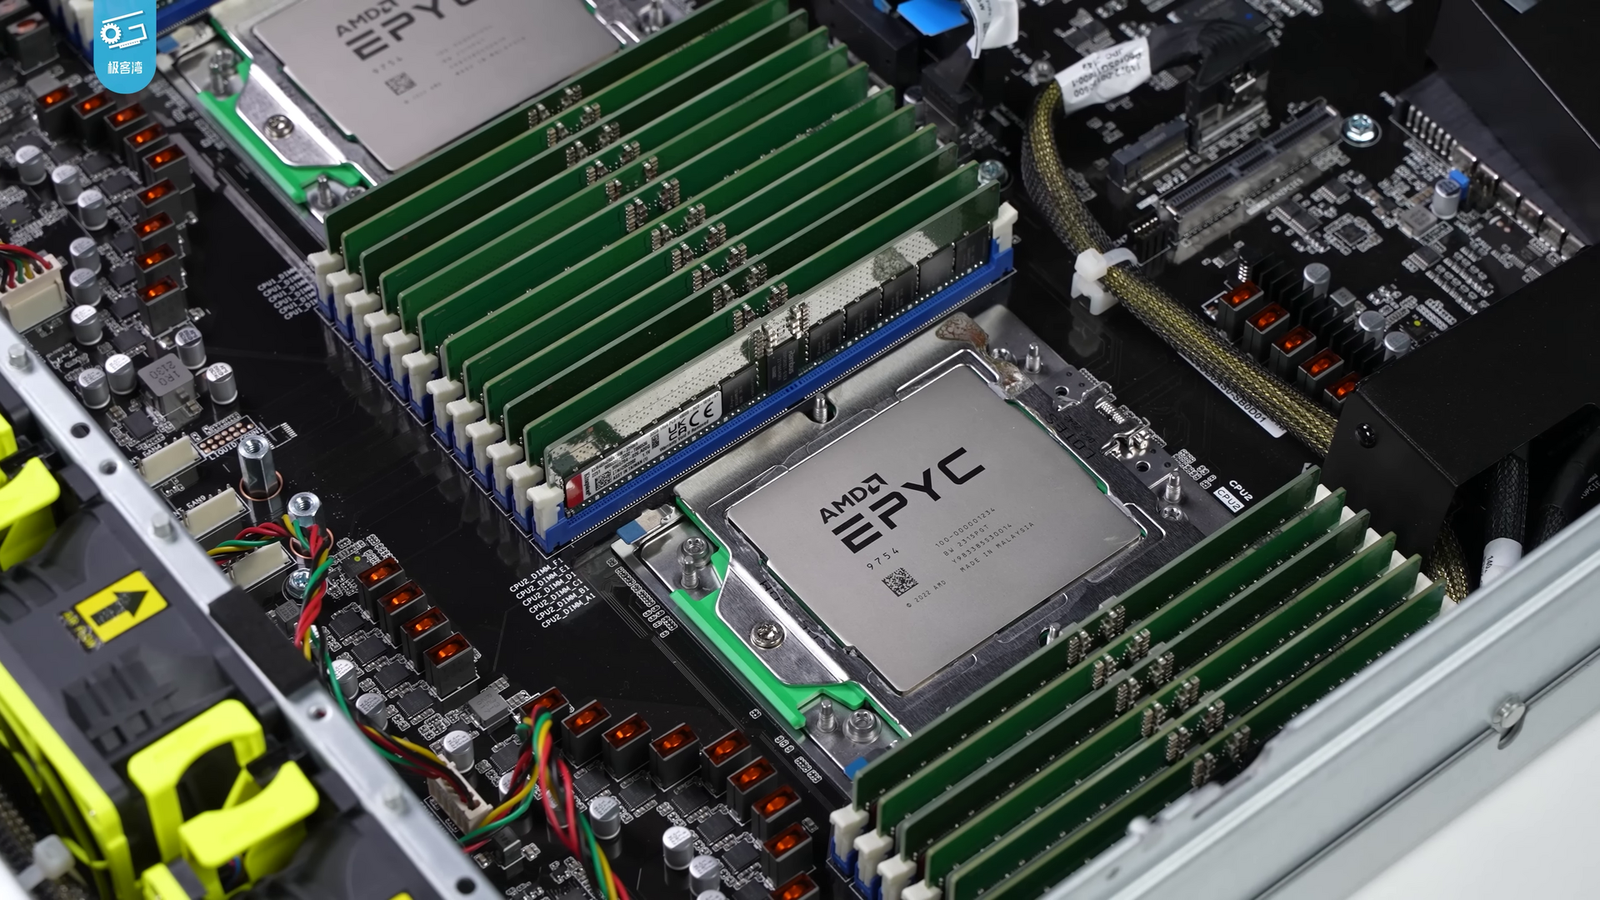
듀얼 소켓 서버에 장착된 AMD EPYC
전통적인 서버 노드는 CPU가 주인공이고 가속기가 PCIe 슬롯에 꽂히는 손님이었다. 메모리도, I/O도 CPU를 거쳐야 했다. 위 도해의 ① 구조가 바로 이것이다. AI 워크로드에서는 이 관계가 뒤집혀, 이제 CPU가 GPU를 보조하는 위치가 된다.
출처: 极客湾GeekerwanCC BY 3.0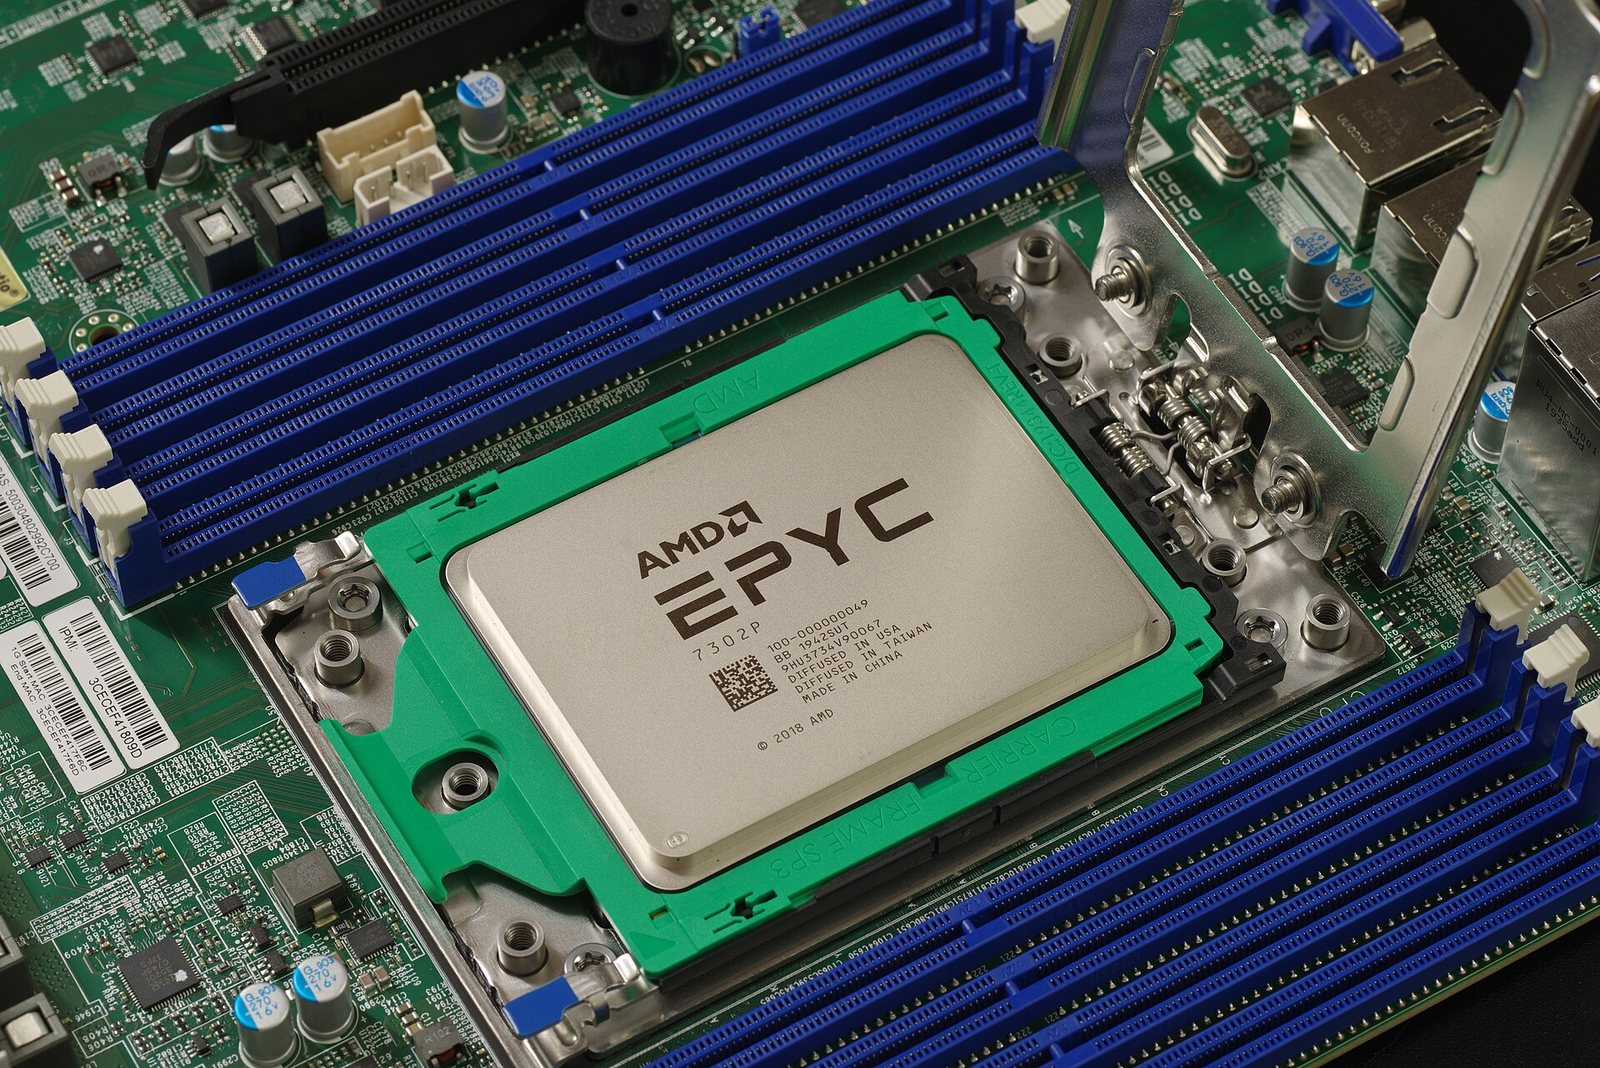
EPYC 패키지 — 여러 칩렛과 I/O 다이의 조합
가운데 큰 다이가 I/O를 담당하고 주위의 작은 다이들이 코어를 담는다. 2장에서 본 칩렛 전략의 가장 성공적인 상용 사례이며, AMD가 이 방식으로 코어 수를 크게 늘릴 수 있었던 것이 5장에서 볼 Helios 랙의 CPU 쪽 경쟁력의 뿌리다.
출처: Smial (talk)FAL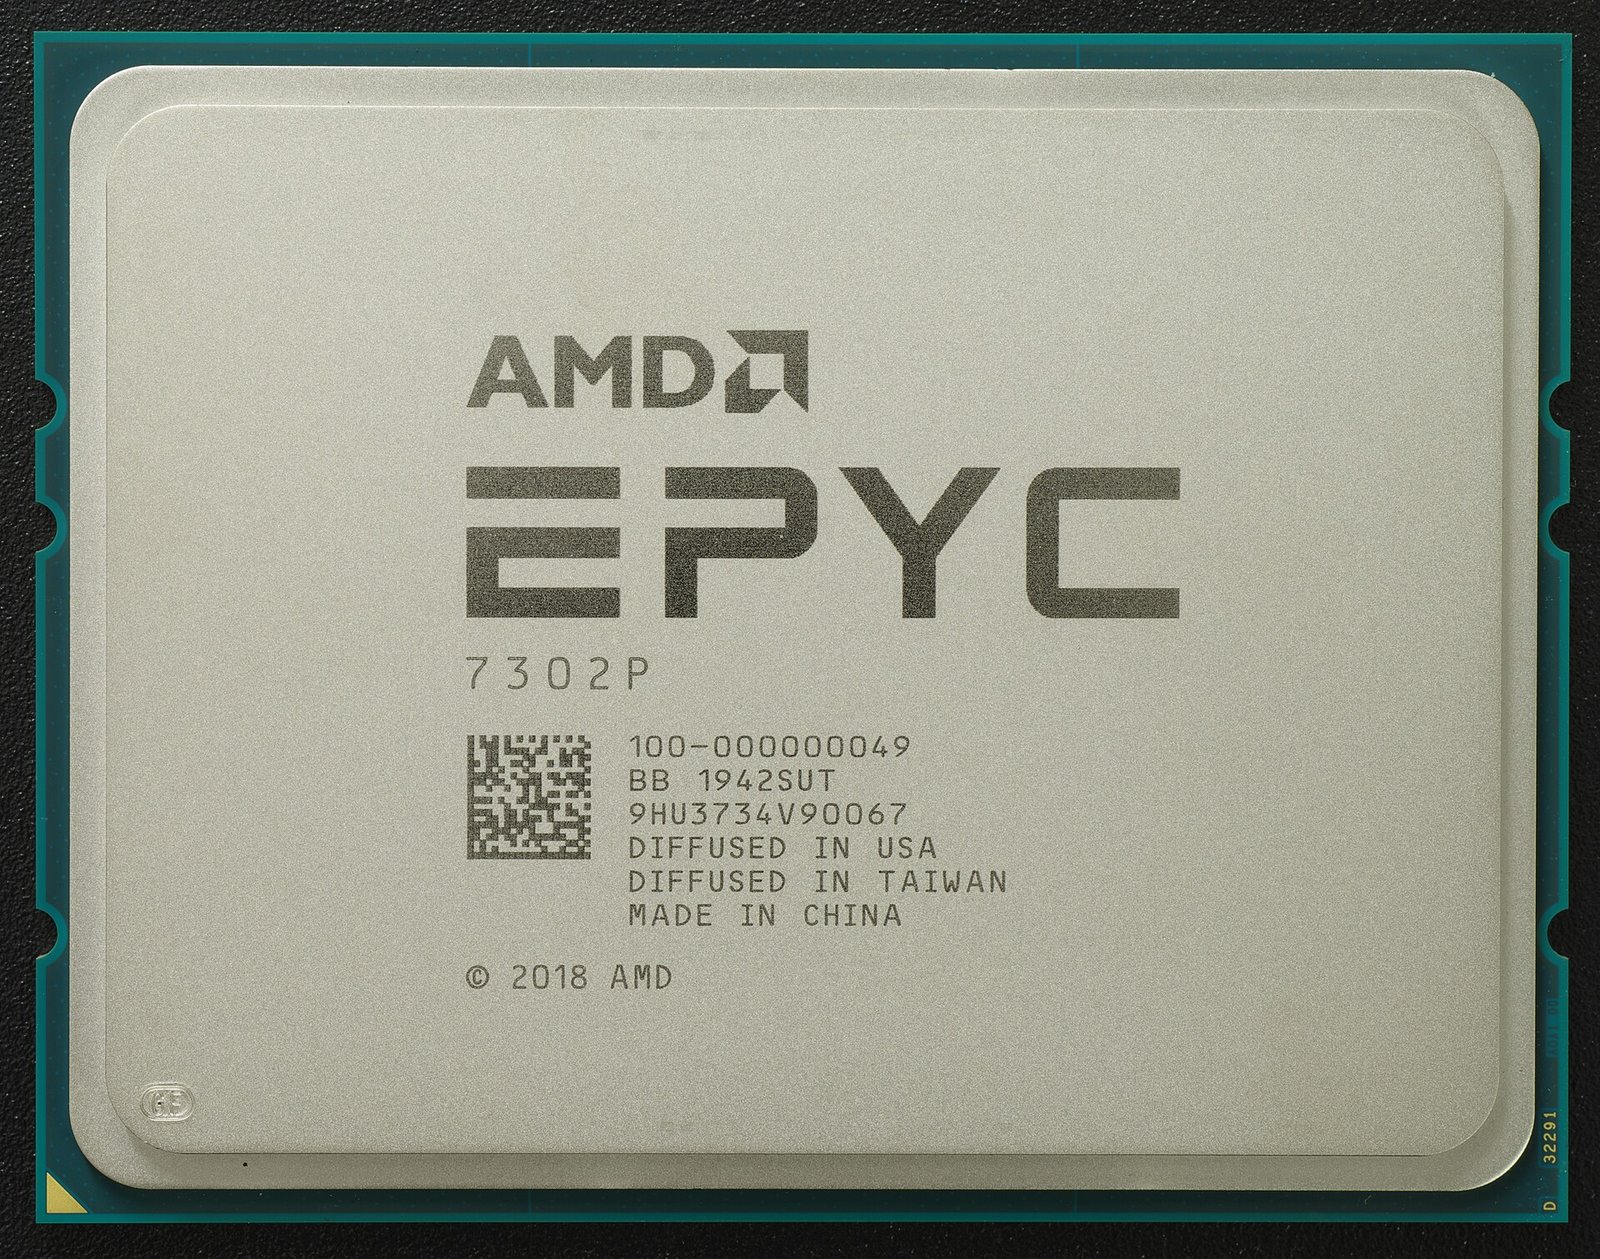
같은 패키지의 상면 — 뚜껑을 덮은 상태
열 확산판 아래에 앞 사진의 칩렛들이 들어 있다. 소켓 하나가 차지하는 면적과 그 주변에 필요한 전원부·메모리 슬롯을 보자. 노드 하나를 설계한다는 것은 이 부품들을 한정된 트레이 안에 배치하고 열을 빼낼 길을 만드는 일이다 — 4장의 컴퓨트 트레이 사진과 겹쳐 보면 이해가 쉽다.
출처: Smial (talk)FALVera·Venice 등 커리큘럼 기준 시점에 출하 전인 제품의 사양은 벤더 발표값이다. 수업 직전 최신 자료로 확인할 것.
DGX Spark 해부 — 책상 위의 랙 한 칸
이 과목의 실습 장비인 DGX Spark는 GB10을 탑재한 소형 시스템이다. 성능만 보면 랙 제품과 비교할 수 없지만, 구조의 원리는 같다. Arm CPU와 Blackwell GPU가 한 패키지에서 메모리를 공유한다 — GB200/VR200에서 Grace(Vera)와 Blackwell(Rubin)이 하는 일과 정확히 같은 관계다.
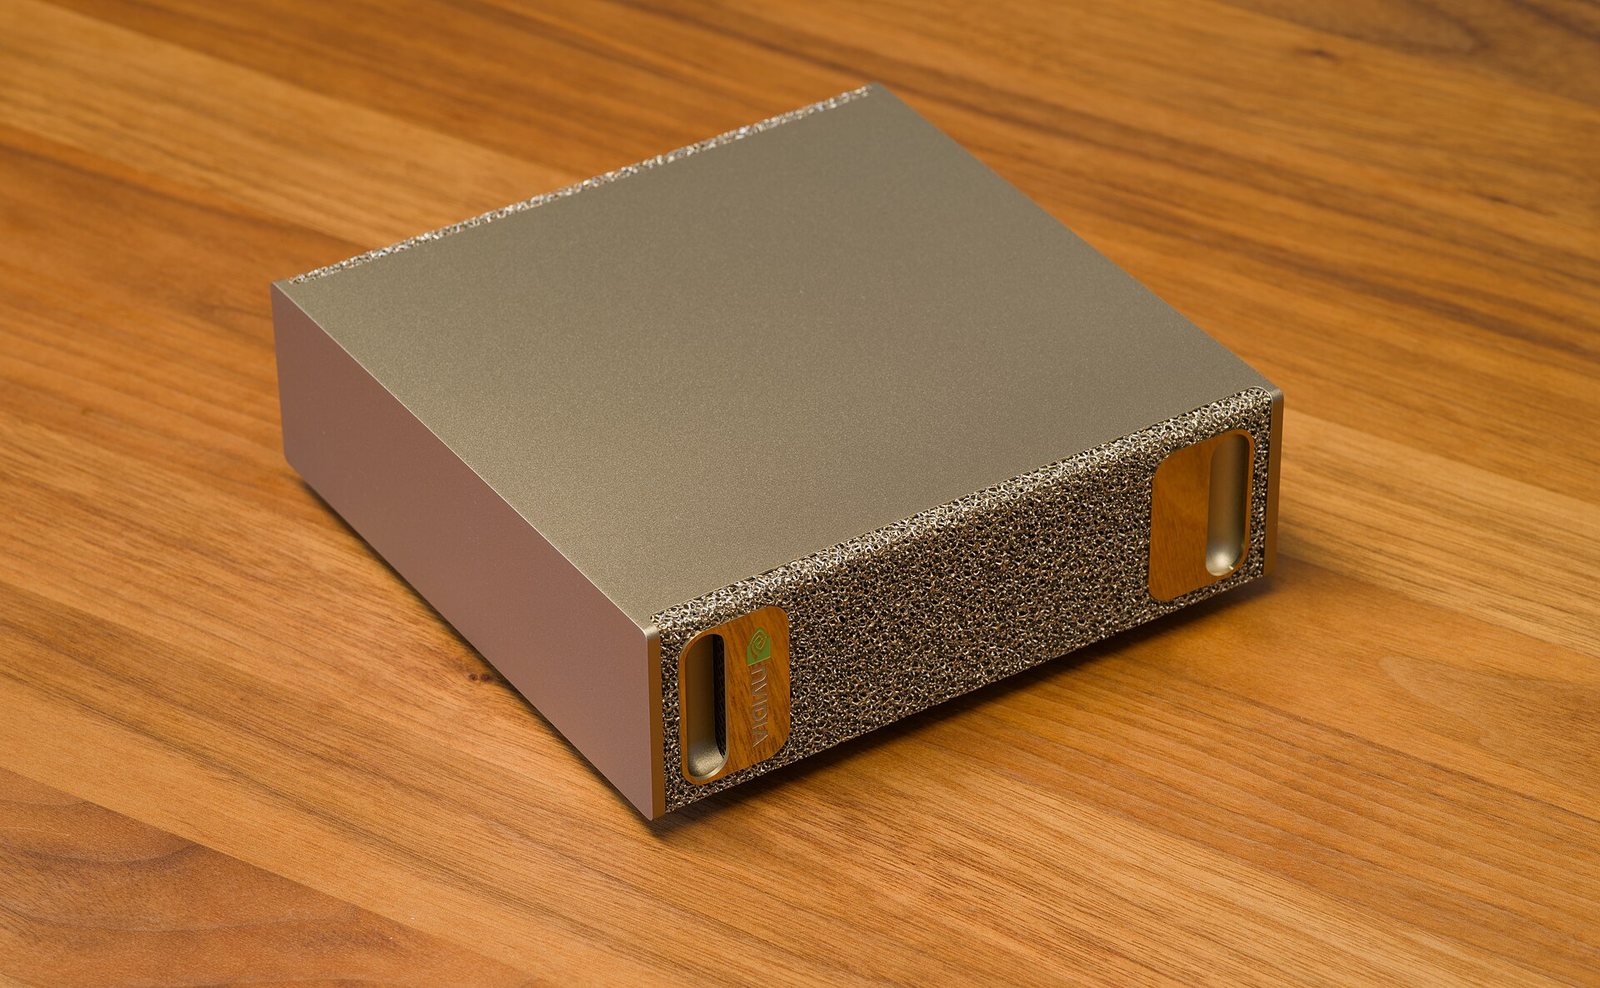
DGX Spark 외관. 측면의 금속 폼(metal foam) 구조가 흡배기를 담당한다.
출처: Daniel Lu (User:dllu)CC BY-SA 4.0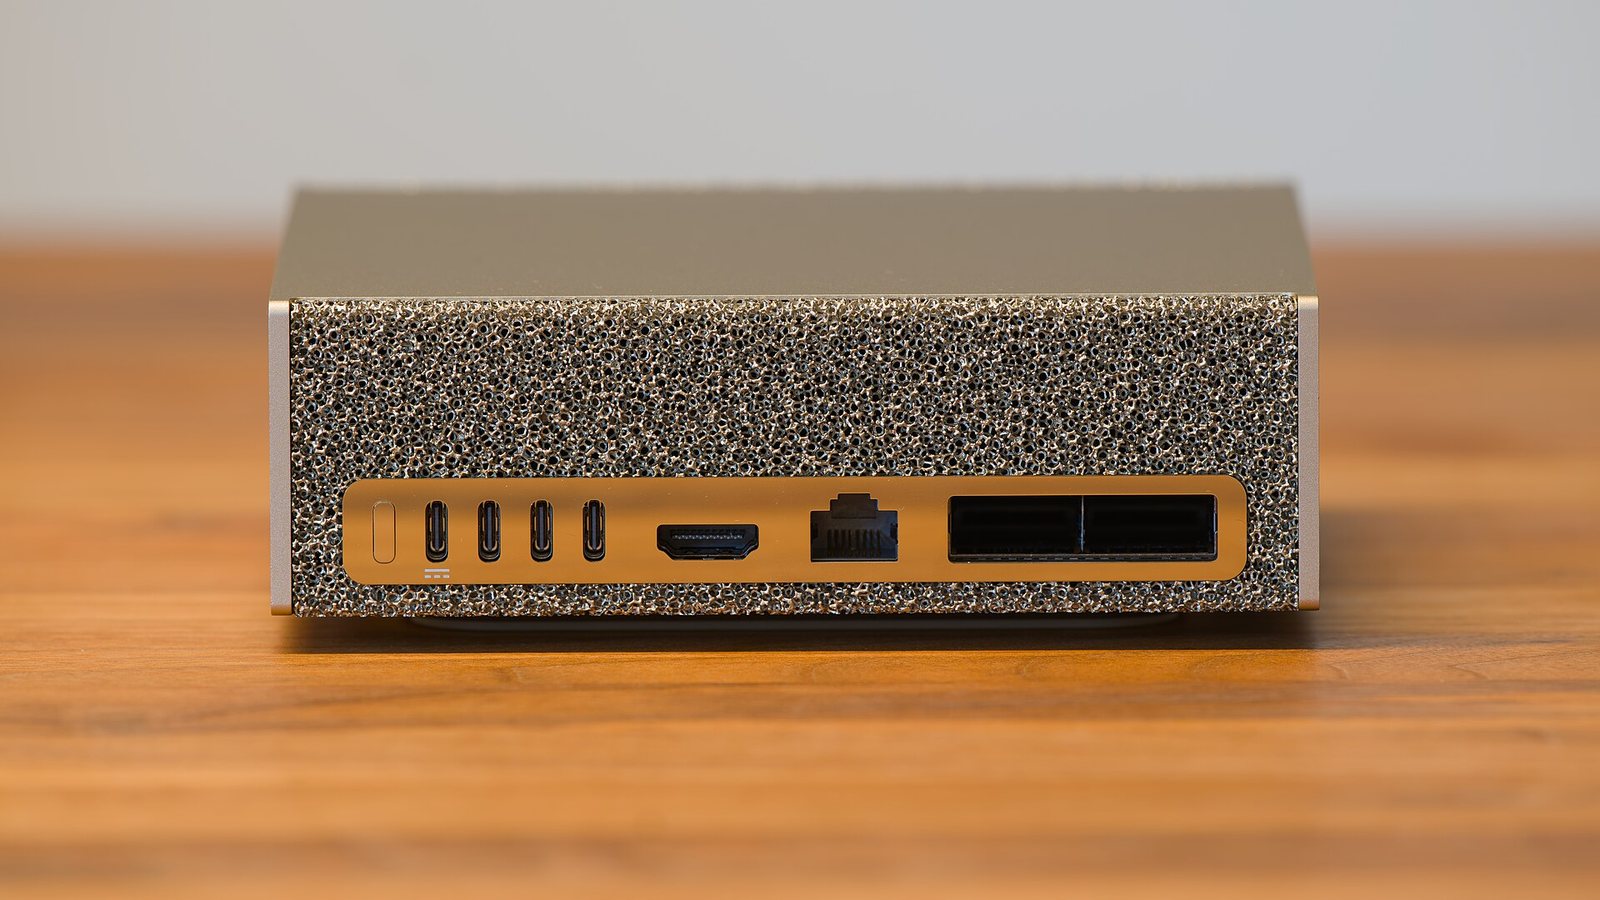
후면 포트. 여기 있는 QSFP 포트가 2대 페어링 실습의 핵심이다 — 8장에서 이 링크로 NCCL 대역폭을 측정한다.
출처: Daniel Lu (User:dllu)CC BY-SA 4.0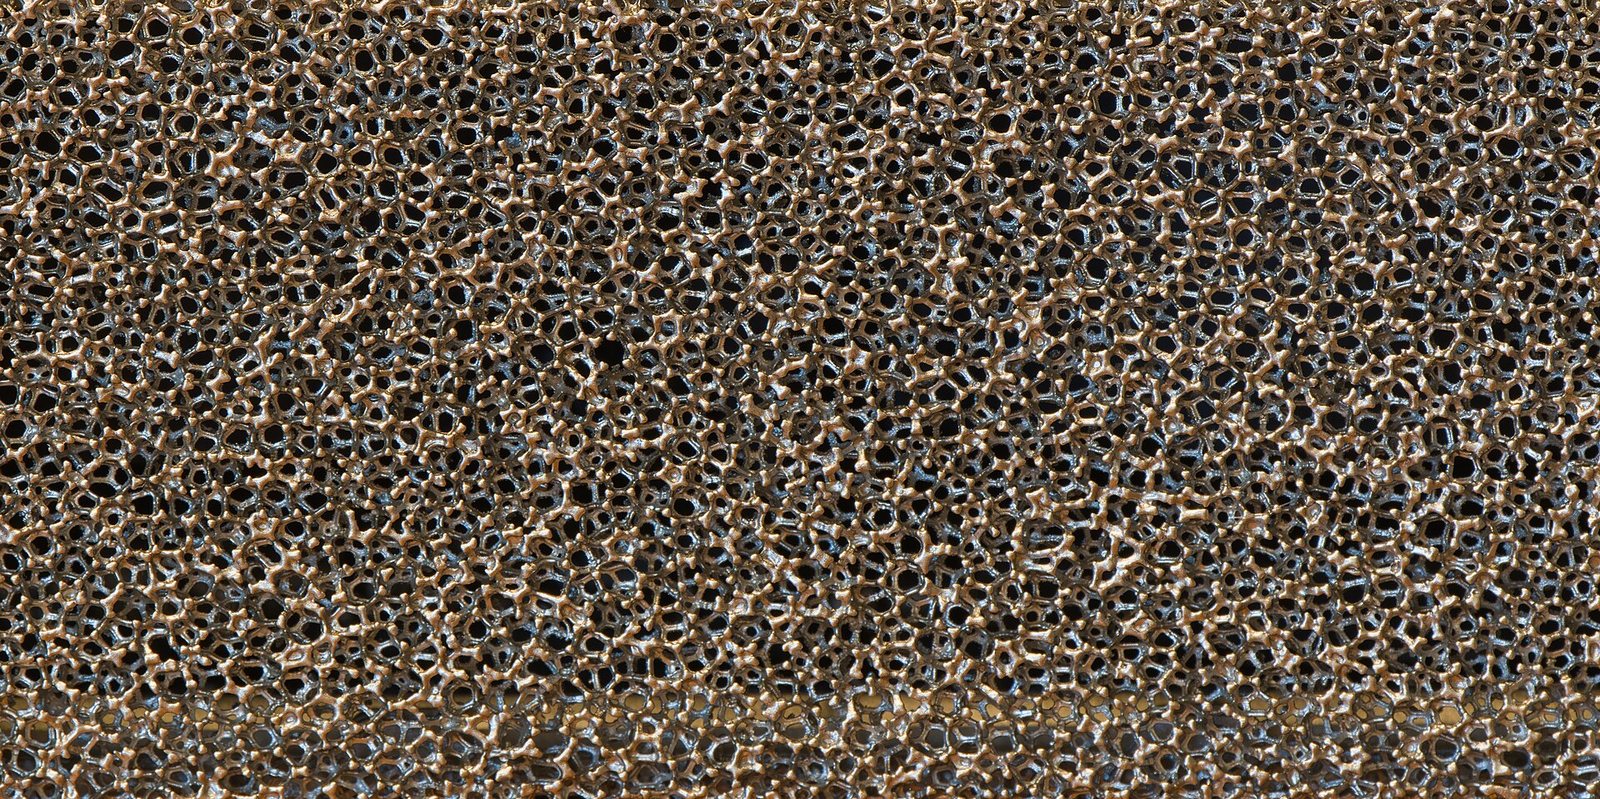
금속 폼 확대 — 작은 부피에서 열을 빼내는 방법
다공성 금속을 써서 표면적을 극대화하고 공기가 지나갈 길을 만든다. 공랭으로 밀도를 높이려는 마지막 세대의 기술이라 볼 수 있다. 같은 문제를 랙 스케일에서 푸는 방법이 11장의 액체냉각이며, 거기서는 공기를 포기하고 물을 칩 위까지 직접 끌어온다.
출처: Daniel Lu (User:dllu)CC BY-SA 4.0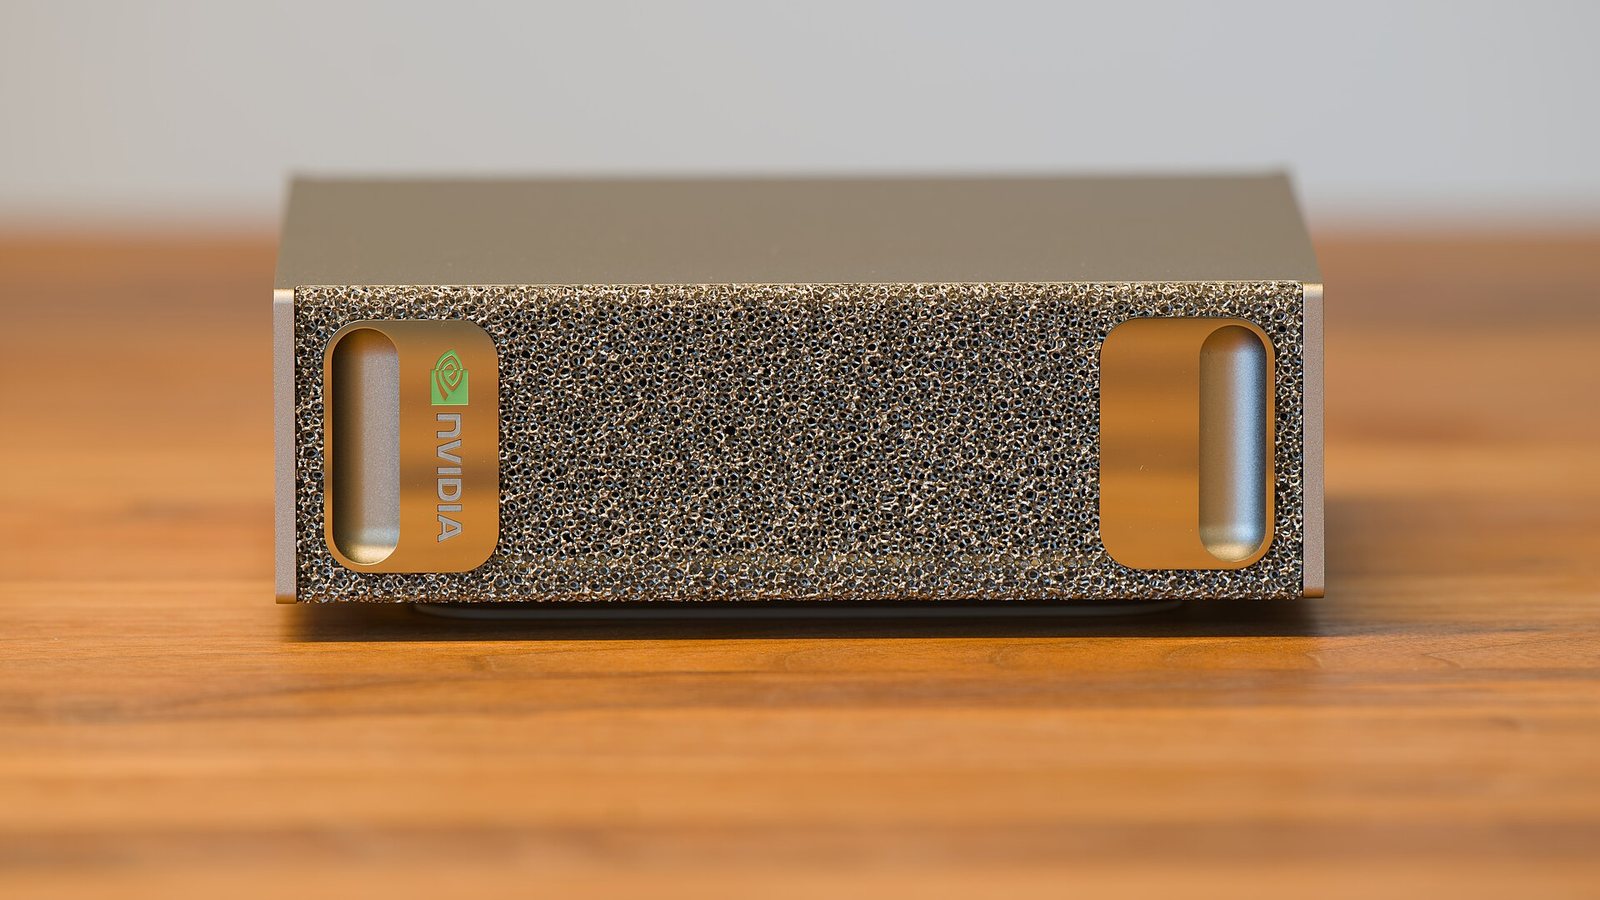
전면 — 이 상자 하나가 랙 한 칸의 원리를 담고 있다
흡기구와 배기구, 그리고 전원과 네트워크 포트의 배치가 보인다. 랙 제품에서는 이 배치가 앞은 차갑고 뒤는 뜨겁다는 규칙으로 확대되고, 그 규칙이 데이터센터 통로 배치까지 결정한다.
출처: Daniel Lu (User:dllu)CC BY-SA 4.0이 장비로 무엇을 할 수 있는가
NVIDIA가 이 장비를 어떤 용도로 제안하는지 보면, 「책상 위 장비」의 자리가 어디인지 감을 잡을 수 있다.
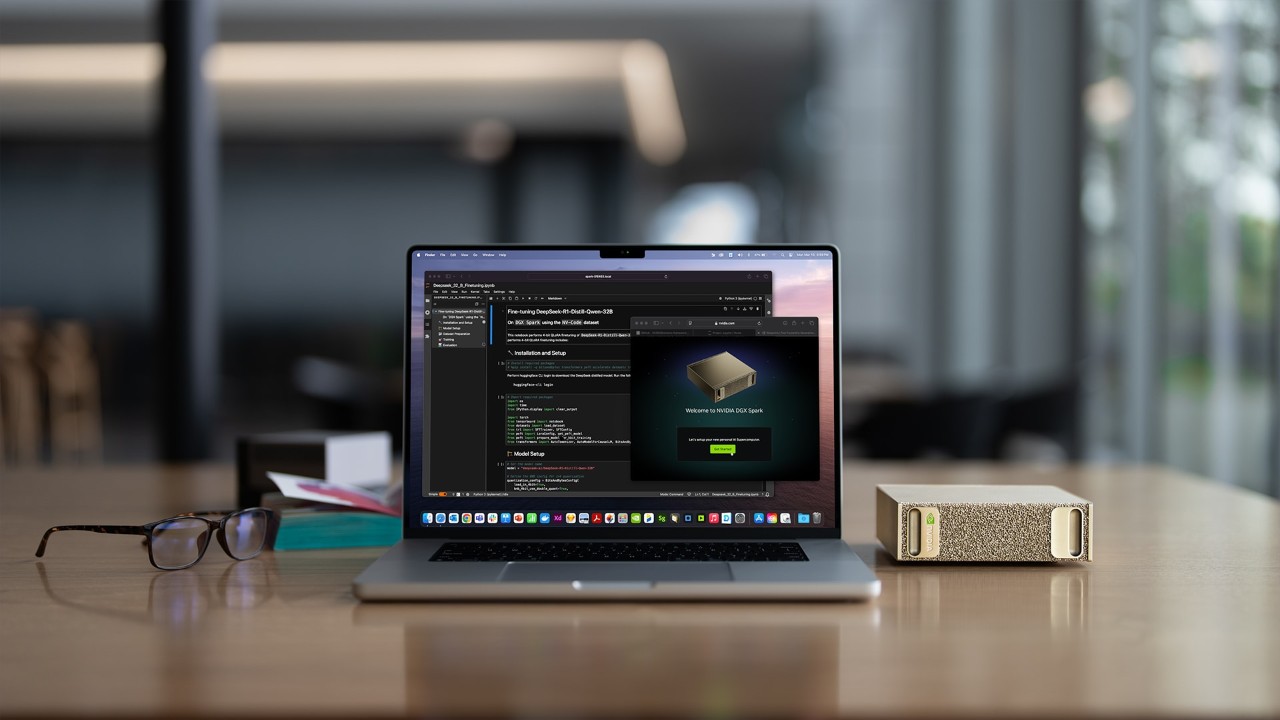
개발자용 — 로컬에서 모델을 띄우고 고쳐 보는 자리
클라우드 GPU를 빌리면 대기와 비용이 붙는다. 손에 있는 장비에서 바로 돌려볼 수 있다는 것 자체가 개발 속도다. 다만 14장에서 계산하듯 서빙 성능은 랙 제품과 비교할 수준이 아니므로, 「돌아가는지 확인」과 「서비스할 수 있는지」를 구분해서 써야 한다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)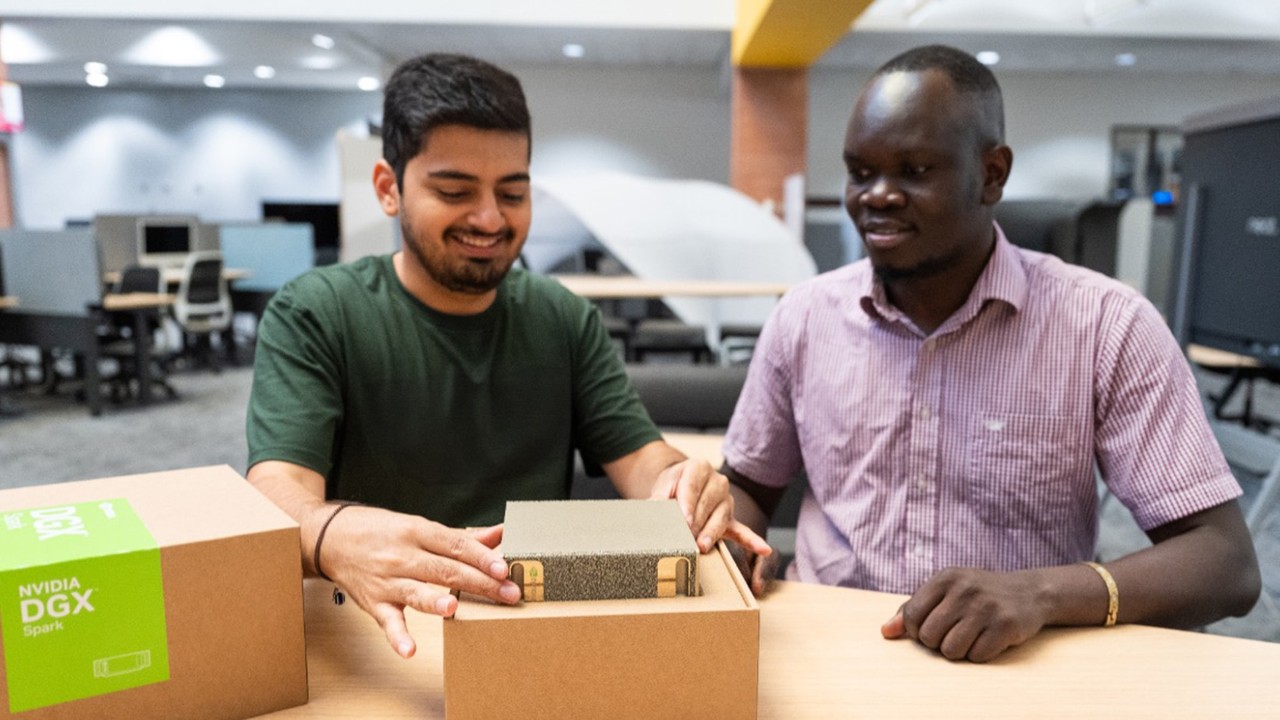
교육용 — 이 과목이 실습 장비로 고른 이유
1인 1대가 가능한 가격과 크기이면서 랙 제품과 같은 구조적 원리를 갖는다. 통합 메모리, Arm CPU + Blackwell GPU, NVLink-C2C 계열 결합. 그래서 이 장비에서 측정한 것을 랙 스케일로 외삽하는 훈련이 성립한다 — 11장 실습이 정확히 그것을 한다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)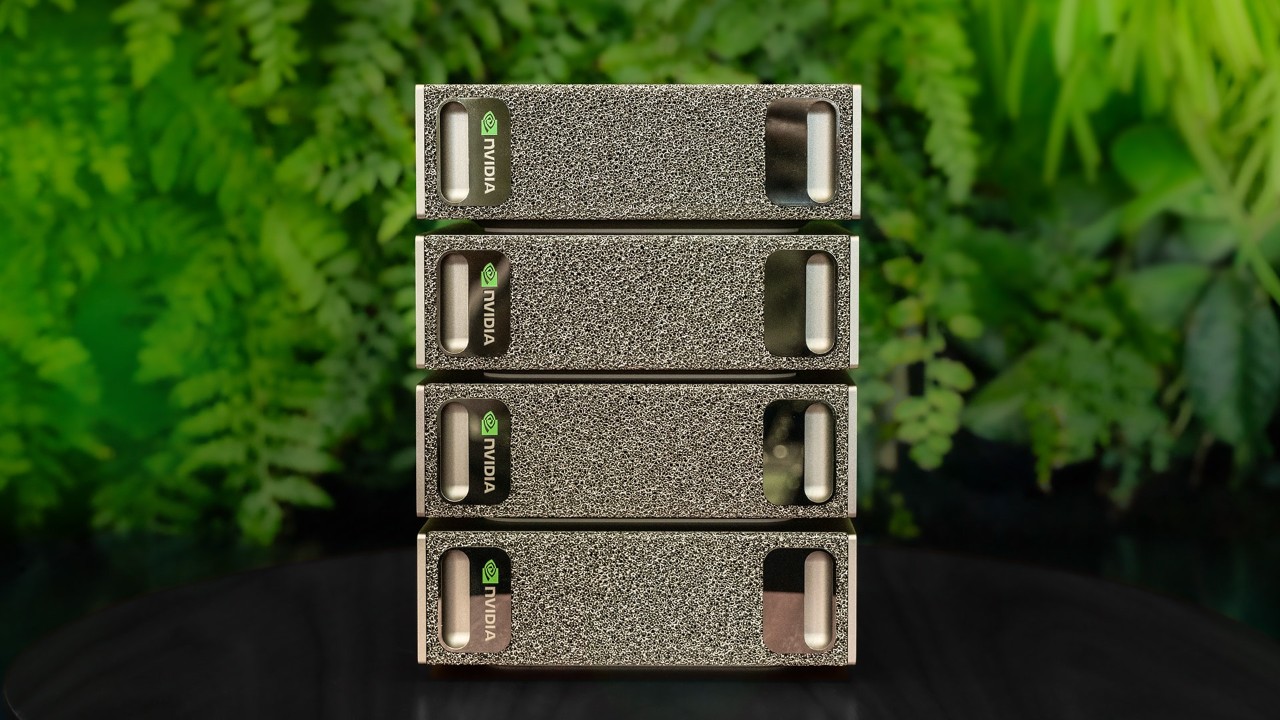
돌릴 수 있는 워크로드의 범위
추론, 파인튜닝, 소규모 학습까지 가능하다고 제시한다. 이 중 무엇이 실제로 쓸 만한지는 여러분이 직접 재야 한다 — 그것이 이 과목 실습의 반복되는 주제다. 벤더가 「할 수 있다」고 한 것과 「쓸 만하다」는 다르다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)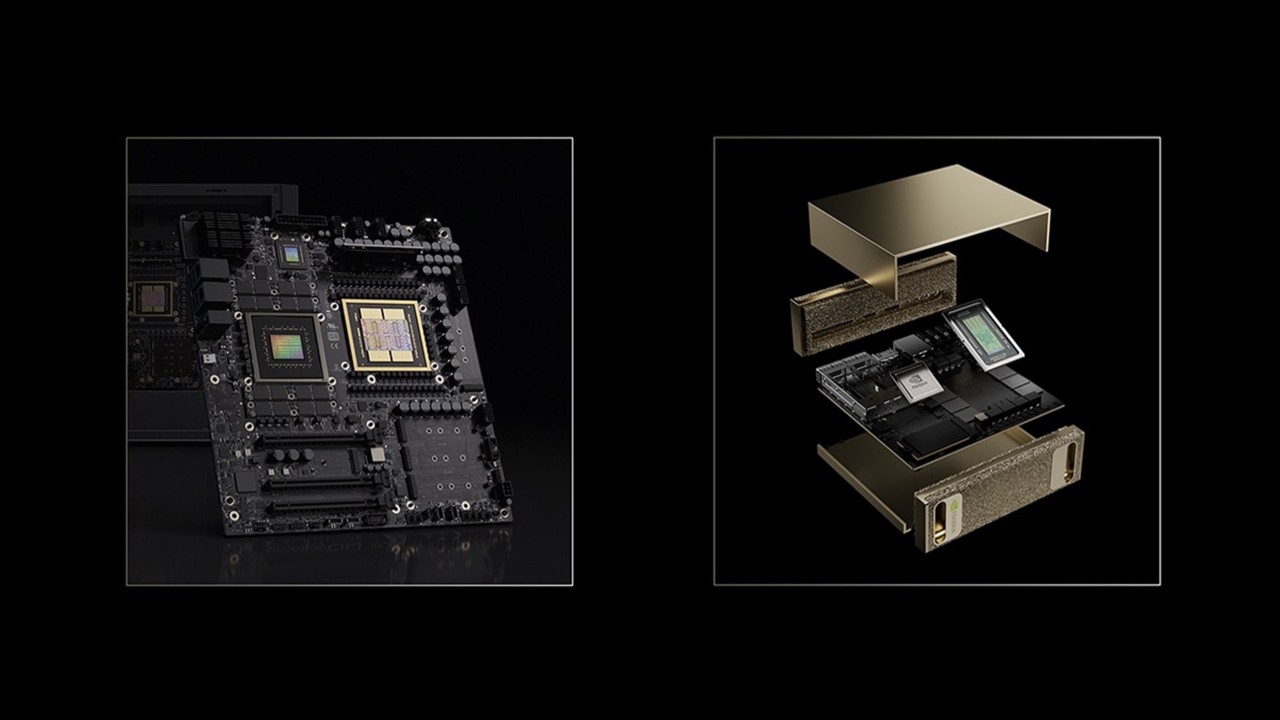
오픈 웨이트 모델을 로컬에서 돌리는 시나리오
14장에서 볼 대로, 128 GB 통합 메모리에는 70 B 모델(FP8)이 올라간다. 가중치가 올라간다는 것과 실용적인 속도가 나온다는 것은 다르지만, 모델 동작을 확인하고 프롬프트를 다듬는 데는 충분하다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)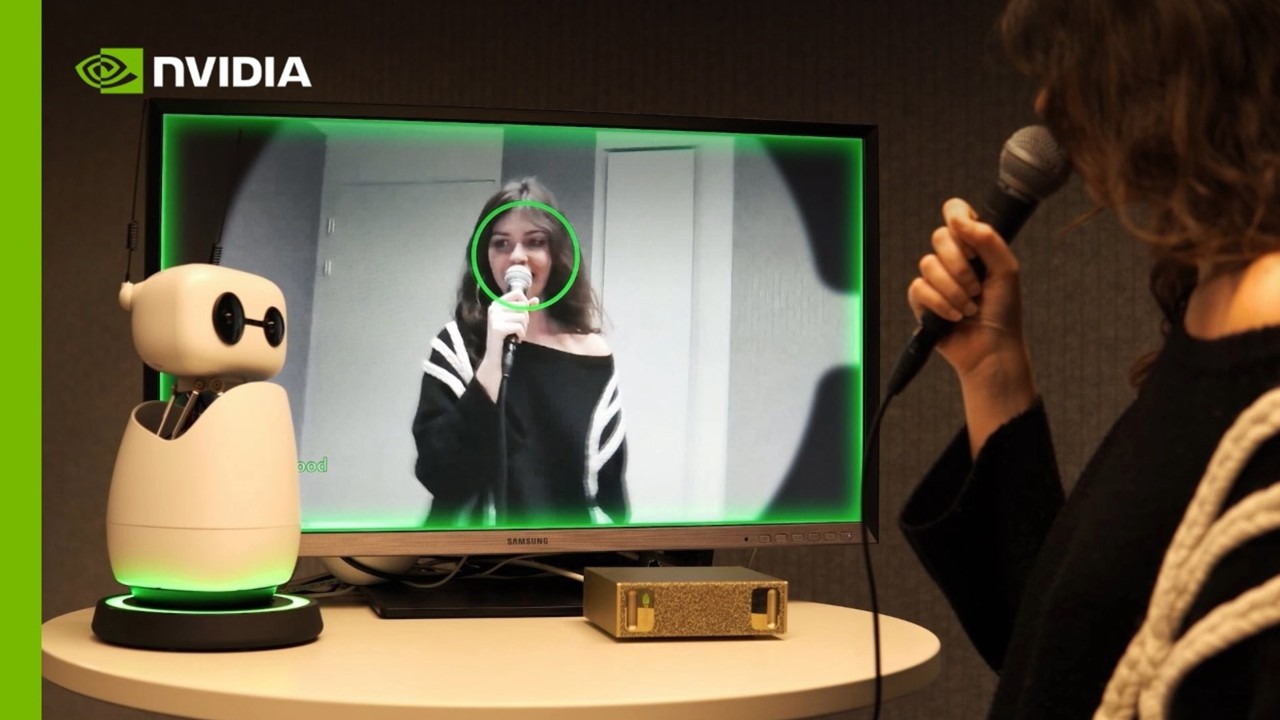
로보틱스 등 엣지 응용
데이터를 클라우드로 보내지 않고 현장에서 처리해야 하는 경우가 있다. 지연, 대역폭, 프라이버시가 이유다. AI 인프라가 데이터센터에만 있는 것이 아니라는 점을 기억해 두자 — 17장 설계 프로젝트에서 「어디에 둘 것인가」도 설계 결정의 하나다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)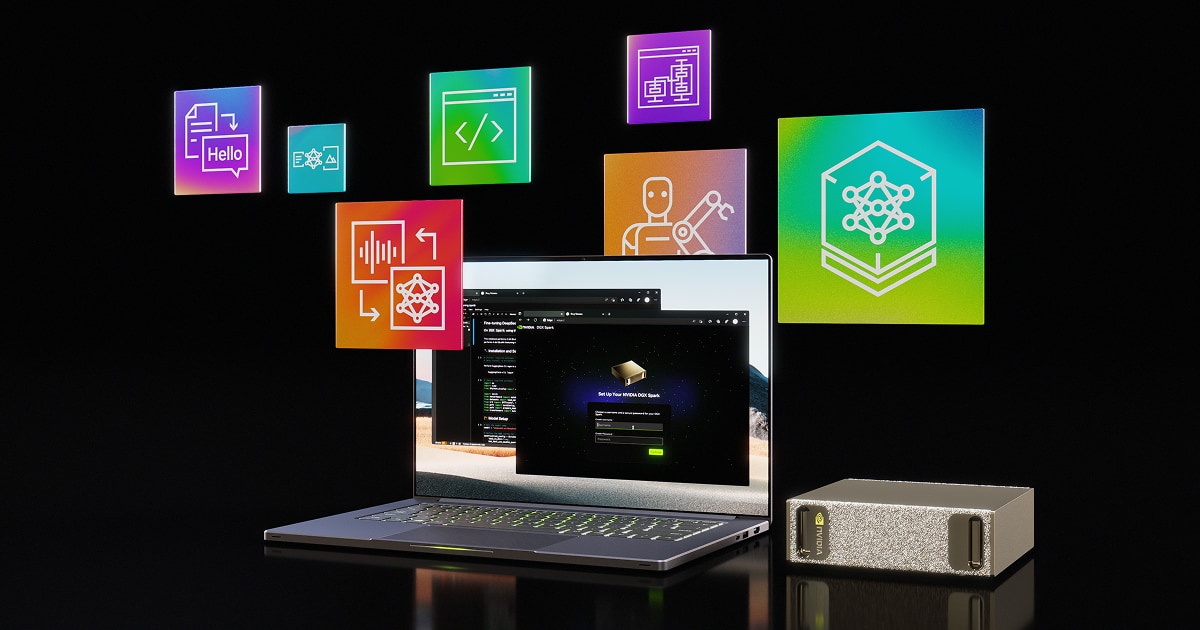
제품 대표 이미지
이 과목의 실습은 전부 이 장비 위에서 이루어진다. 1장에서 토큰 하나의 비용을 계산하고, 3장에서 토폴로지를 읽고, 8장에서 두 대를 묶어 통신 대역폭을 재고, 11장에서 전력을 실측해 랙으로 외삽하고, 13·14장에서 서빙과 용량 산정을 검증한다. 작은 장비로 큰 시스템의 원리를 배우는 것이 이 구성의 목적이다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)| Spark에서 확인 가능 | 랙 제품에서만 나타남 | |
|---|---|---|
| CPU-GPU 결합 | 통합 메모리, 복사 없는 접근 ✔ | — |
| 메모리 | 용량 vs 대역폭 트레이드오프 ✔ | HBM의 절대 대역폭 |
| Scale-up | — | NVLink 스위치, 72-GPU 단일 도메인 |
| Scale-out | 2대 직결로 원리만 ✔ | 리프-스파인, 혼잡 제어 |
| 전력·냉각 | W/token 측정 ✔ | 액체냉각, 800VDC 배전 |
| 서빙 아키텍처 | P/D 분리 데모 ✔ | 대규모 라우팅, KV 캐시 계층화 |
이 표가 곧 실습 설계의 지도다. Spark에서 원리를 손으로 확인하고, 규모에서 오는 문제는 계산과 사양서 독해로 채운다.
실습 — 내 장비의 토폴로지를 읽는다
목표: DGX Spark를 GB200/VR200의 축소판으로 놓고, 통합 메모리가 실제로 어떻게 동작하는지 측정으로 확인한다.
1단계 — 토폴로지 파악
# GPU와 상호연결 구조
nvidia-smi topo -m
nvidia-smi -q | head -60

# CPU 쪽 구성
lscpu | egrep 'Model name|Socket|Core|NUMA'
numactl --hardware

# 메모리 구성 (통합 메모리인지 확인)
free -h
cat /proc/meminfo | egrep 'MemTotal|HugePages'
기록할 것: GPU 개수, 연결 방식 표기(NV#/PIX/SYS 등), NUMA 노드 수, 총 메모리.
2단계 — 메모리 대역폭 실측
# CUDA 샘플의 대역폭 테스트 (경로는 설치에 따라 다름)
bandwidthTest --mode=shmoo

# 측정할 세 가지
#   1) Host to Device
#   2) Device to Host
#   3) Device to Device
전통적인 PCIe 시스템이라면 1·2번이 3번보다 훨씬 낮게 나온다. 통합 메모리 시스템에서는 어떤가? 그 차이가 무엇을 의미하는지 설명하라.
3단계 — 메모리 공유 확인
CUDA 통합 메모리(cudaMallocManaged)로 배열을 할당하고, CPU와 GPU가 번갈아 접근하는 짧은 프로그램을 작성해 명시적 복사 없이 동작하는지, 그리고 접근 시간이 어떻게 나오는지 측정한다.
4단계 — 해석
nvidia-smi topo -m출력에서 GB200 NVL72의 토폴로지와 대응되는 부분과 빠져 있는 부분을 각각 지적하라.- Host↔Device 대역폭이 Device↔Device와 비슷하게 나온다면 그 이유는 무엇인가?
- 이 장비의 메모리 대역폭으로 1장의 디코드 상한을 다시 계산하면 얼마인가? HBM 기반 제품(8~22 TB/s)과 비교하면 몇 배 차이인가?
- 그럼에도 Spark로 큰 모델을 돌릴 수 있는 이유는 무엇인가? 그 대가는?
제출물
토폴로지 출력 원문 + 대역폭 측정표 + 위 네 질문에 대한 답 (A4 3장 이내).
- 만약 CPU를 자체 설계하지 않고 인텔·AMD CPU를 쓴다면 NVIDIA는 무엇을 포기해야 하는가?
- 통합 메모리는 대역폭을 희생한다. 그럼에도 추론에서 유리한 상황은 구체적으로 어떤 경우인가?
- Arm이 데이터센터 CPU에서 점유율을 늘리는 것과 AI 가속기의 부상은 어떤 인과관계가 있는가?
참고 자료
- NVIDIA — Grace Hopper Superchip Architecture In-Depth : 이 페이지 도해 대부분의 출처
- NVIDIA DGX Spark 제품 페이지
- CUDA Programming Guide — Unified Memory 장
- Wikimedia Commons — DGX Spark 사진 (dllu, CC BY-SA 4.0)