NVIDIA Vera Rubin 플랫폼
Vera Rubin 세대에서 NVIDIA가 파는 것은 GPU가 아니라 랙이다. 그것도 한 종류가 아니라 다섯 종류다. 왜 랙을 나눠 팔게 됐는지 알면, 이 회사가 워크로드를 어떻게 분해했는지가 그대로 보인다.
이 장을 마치면
- Vera Rubin 세대를 구성하는 7개 칩의 역할을 각각 설명할 수 있다.
- 5종의 랙이 워크로드의 어느 단계를 맡는지 매핑하고, 그 분해의 논리를 설명할 수 있다.
- VR200 NVL72의 사양을 GB300 세대와 항목별로 비교하고, 무엇이 왜 늘었는지 해석할 수 있다.
- NVLink Fusion이 개방과 통제 사이에서 무엇을 노린 것인지 설명할 수 있다.
- 랙 사양표를 노드·스위치·전력·냉각 BOM으로 분해할 수 있다.
연간 케이던스 — 세대 교체가 건물을 바꾼다
1장에서 NVIDIA가 연간 케이던스로 전환했다는 것을 봤다. Vera Rubin은 그 두 번째 바퀴다.
Hopper      → Blackwell    → Blackwell Ultra → Rubin        → Rubin Ultra
(H100/H200)   (GB200 NVL72)  (GB300 NVL72)     (VR200 NVL72)  (Kyber NVL576)
~40 kW ~120–130 kW ~140 kW ~190–230 kW ~600 kW바뀌는 것은 GPU만이 아니다. 랙 전력이 세대마다 뛴다. 40kW는 공랭으로 버틸 수 있지만 130kW부터는 액체냉각이 사실상 필수고, 600kW는 배전 아키텍처 자체를 바꿔야 한다(11장 800 VDC).
즉 「GPU를 새 세대로 바꾼다」는 결정은 건물의 전기실과 기계실을 다시 짓는다는 결정과 같다. 데이터센터 사업자가 세대 로드맵을 몇 년 앞서 들여다보는 이유다.
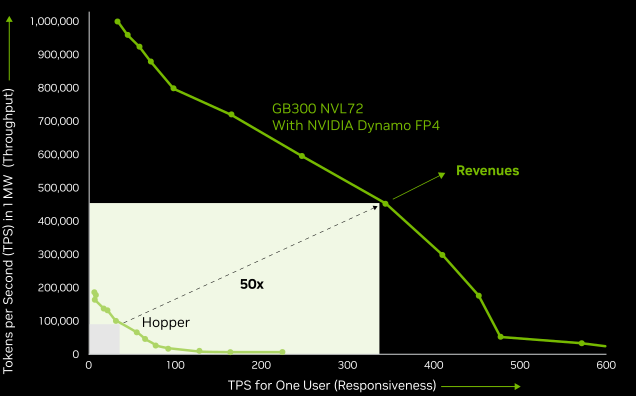
1 MW로 낼 수 있는 처리량과 사용자 체감 속도의 상충 — 그리고 그 사이의 면적
가로축이 사용자 한 명이 느끼는 초당 토큰(응답성), 세로축이 1 MW당 총 처리량이다. 13장에서 볼 상충 곡선과 정확히 같은 형태이며, 아래 회색이 Hopper, 위 초록이 GB300 NVL72다.
주목할 것은 안쪽의 사각형 면적이다. NVIDIA는 이 면적을 「Revenues」라고 표기했다 — 즉 처리량 × 응답성이 곧 매출이라는 관점이며, 1장에서 본 「AI 팩토리」 사고의 직접적인 표현이다.
1 MW라는 분모로 정규화했다는 점도 중요하다. 전력당 성능으로 비교하면 「랙에 GPU가 더 많아서」라는 반론이 막힌다. 15장의 tokens/W 논의를 벤더가 먼저 마케팅에 쓰고 있는 셈이다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)7개 칩 — 랙 하나를 채우는 부품 목록
Vera Rubin은 GPU 한 종류가 아니라 서로 맞물리는 칩 일곱 개의 묶음이다. 각 칩이 1~3장에서 본 어느 병목을 담당하는지 대응시켜 보면 이해가 빠르다.
| 칩 | 무엇인가 | 해결하는 병목 | 이 과목의 어느 장 |
|---|---|---|---|
| Vera CPU | Grace 후속 Arm CPU | 데이터 로딩·전처리·오케스트레이션. NVLink-C2C의 상대편 | 3장 |
| Rubin GPU | HBM4 288GB · 22TB/s · FP4 약 50PF | 연산과 메모리 대역폭 양쪽 | 2장 |
| NVLink 6 Switch | 랙 안 GPU를 전대역 연결 | scale-up — 72개를 하나로 | 8장 |
| ConnectX-9 SuperNIC | 노드의 scale-out 포트 | 랙 사이 통신 | 9장 |
| BlueField-4 DPU | 네트워크·스토리지 오프로드 프로세서 | CPU가 I/O에 잡아먹히는 문제 | 10장 |
| Spectrum-6 이더넷 스위치 | CPO 적용 이더넷 패브릭 | 대규모 scale-out의 전력·신뢰성 | 9장 |
| Groq 3 LPU | 인수 통합된 디코드 가속기 | 디코드의 메모리 대역폭 한계 | 7장 · 13장 |
맨 아래 항목이 중요하다. 범용 GPU 회사가 디코드 전용 하드웨어를 라인업에 넣었다는 것은, 1장에서 본 프리필/디코드의 비대칭이 이제 제품 구성에까지 반영됐다는 뜻이다.
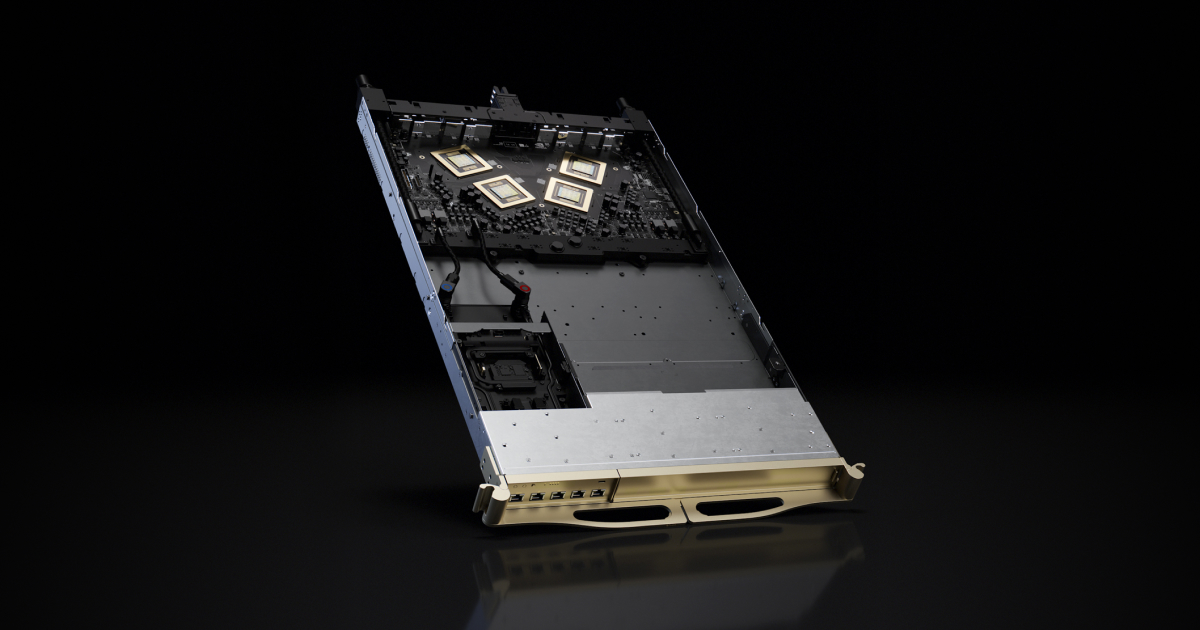
NVLink 스위치 트레이. 랙 안 72개 GPU를 전대역으로 잇는 부품이며, 이것이 있어서 랙이 「하나의 큰 GPU」로 보인다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)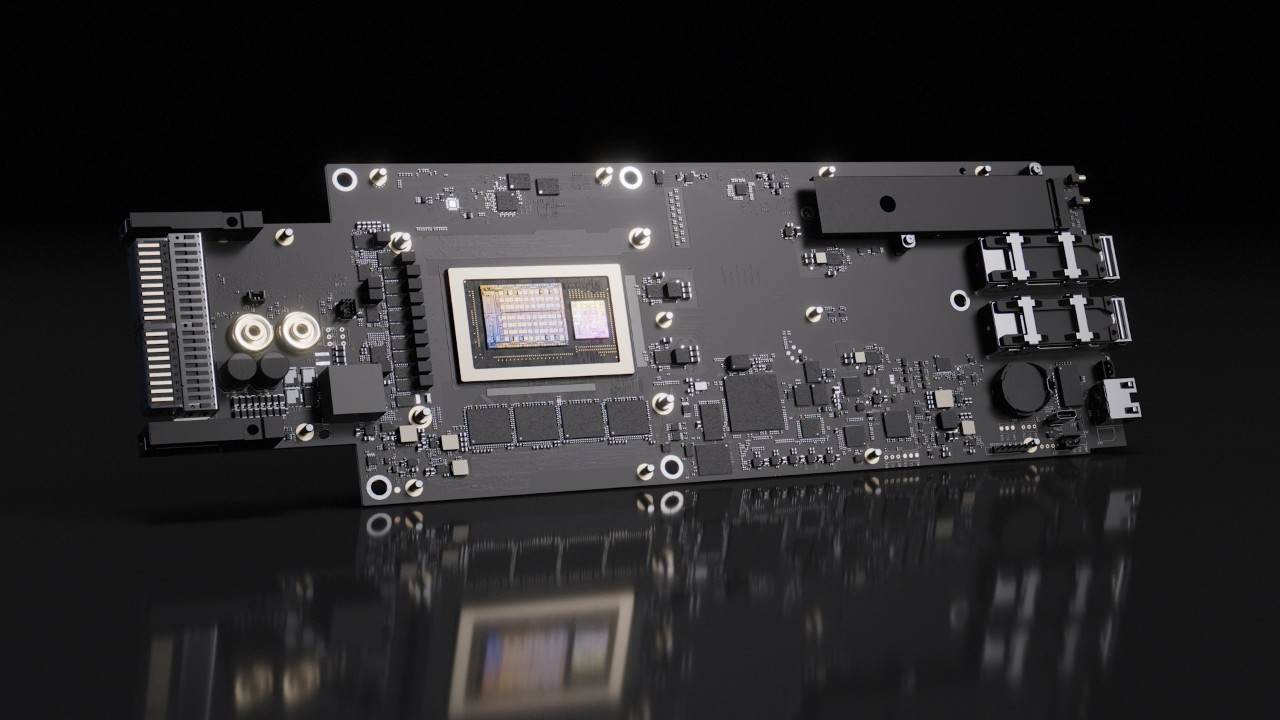
BlueField-4 DPU. 네트워크·스토리지 처리를 CPU에서 떼어내 호스트 CPU가 실제 계산 준비에 집중하게 한다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)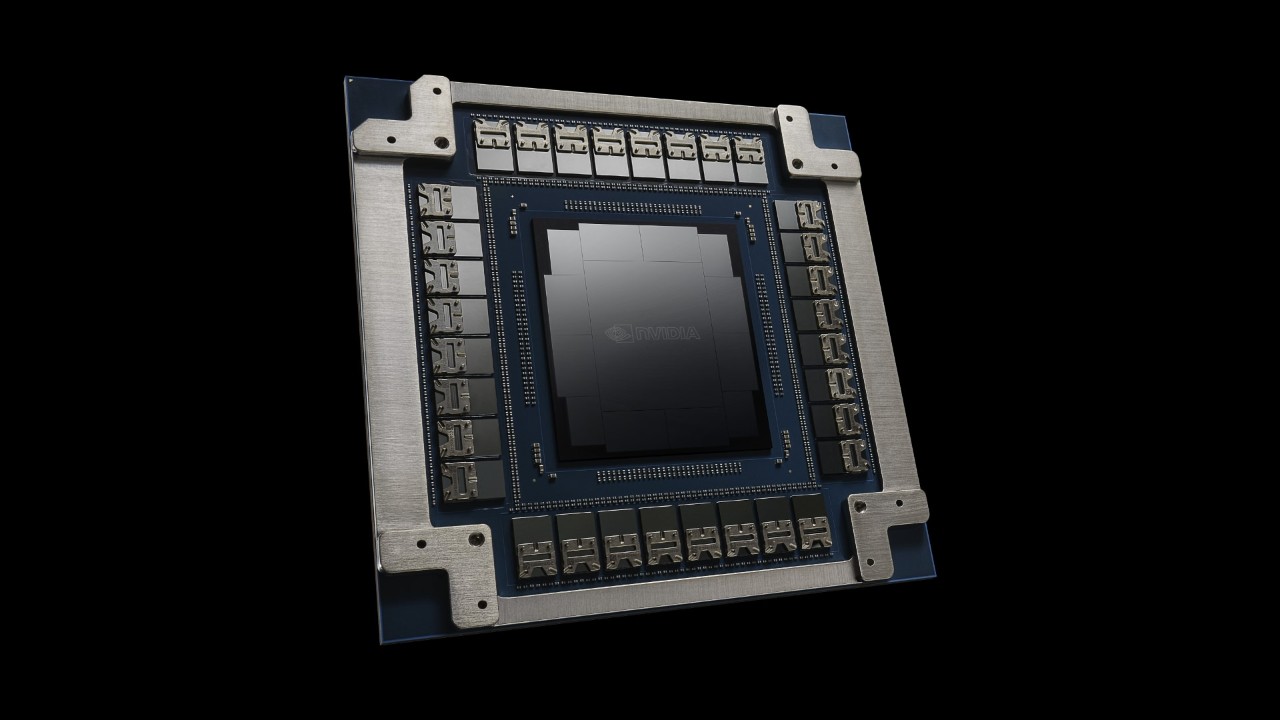
Spectrum-6의 CPO(Co-Packaged Optics) 패키지
광 엔진을 스위치 칩 옆에 같은 패키지 안에 붙였다. 전기 신호가 기판 위를 달려 앞면 트랜시버까지 갈 필요가 없어지므로 전력이 줄고 신호 품질이 좋아진다. 9장에서 광모듈 4,096개가 123 kW를 먹는다는 계산을 하고 나면 이 부품이 왜 필요해졌는지가 숫자로 이해된다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)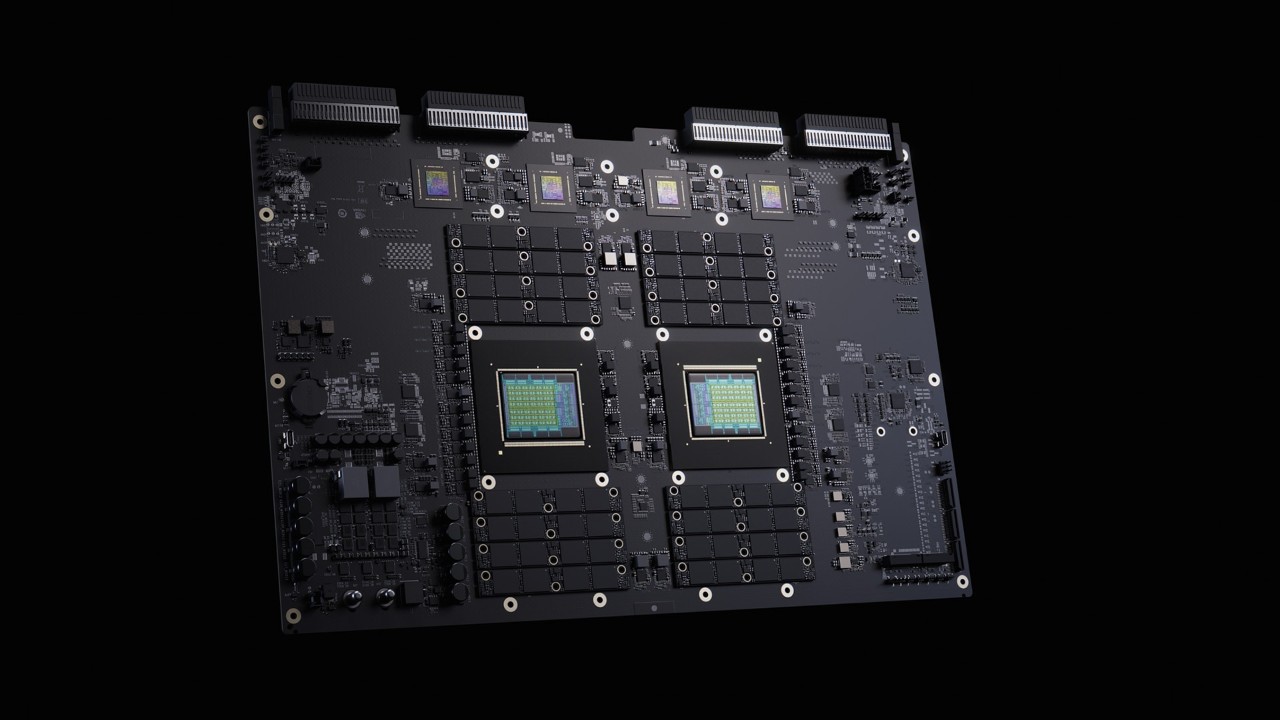
BlueField-4 기반 STX 스토리지 프로세서
네트워크 처리와 스토리지 프로토콜을 GPU 노드 대신 이 카드가 맡는다. 체크포인트 폭주(수 TB/분)와 KV 캐시 계층화를 전담하는 랙의 심장이며, 10장에서 그 두 가지 부하를 계산해 본다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)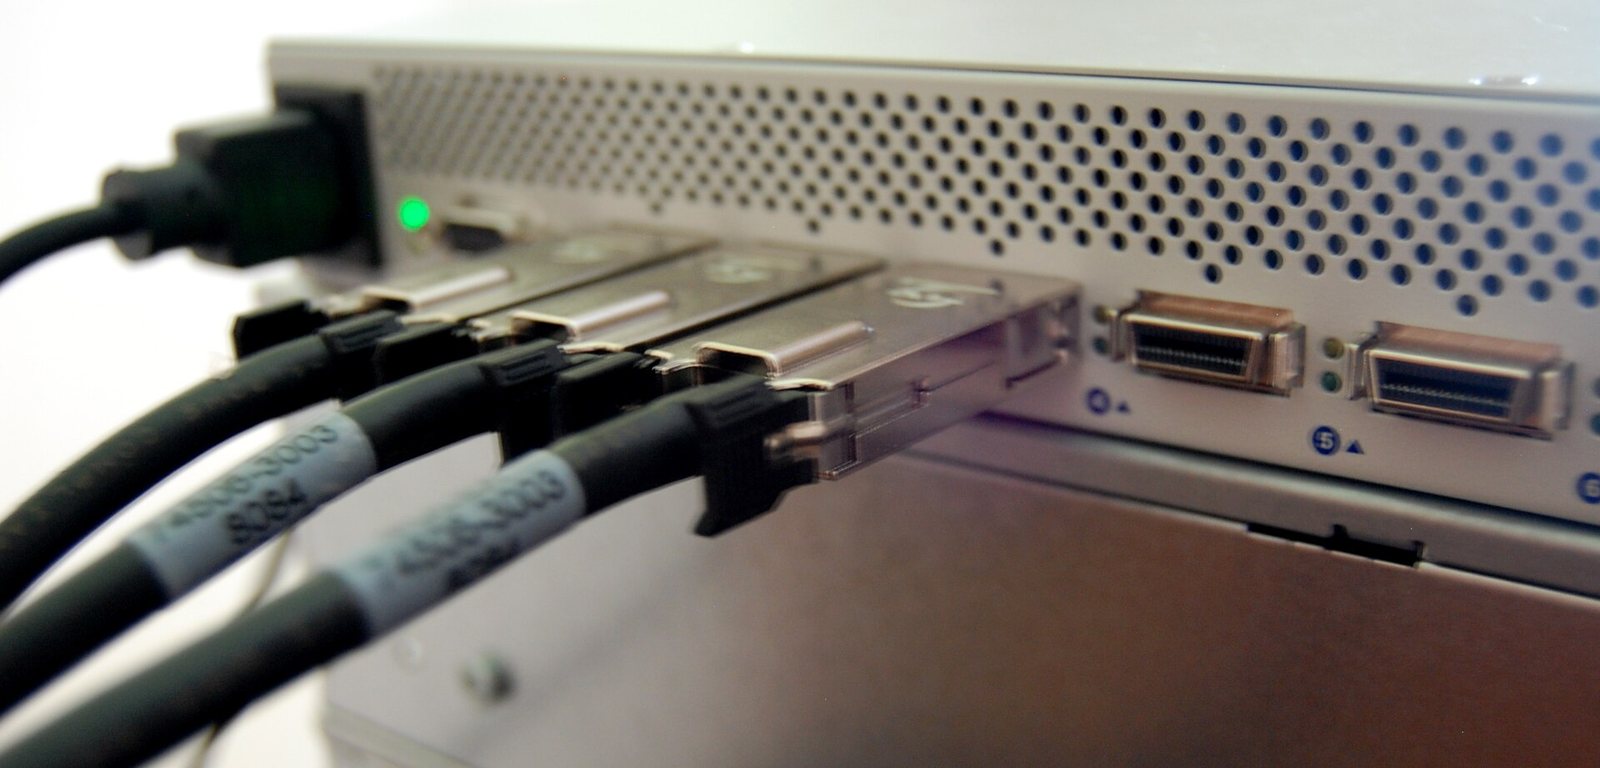
스위치와 케이블 — 랙과 랙을 잇는 물리적 실체
4장에서 「5종 랙」이라고 말할 때, 그 랙들 사이를 실제로 잇는 것이 이 케이블들이다. 한 가닥이 하나의 링크이고, 9장의 계산에서 나오는 「링크 2,048개」가 이런 다발 수십 개가 된다. 배선 실수 하나가 성능 저하로 나타나고, 그것을 찾는 데 며칠이 걸리기도 한다.
출처: ChrisDagCC BY 2.0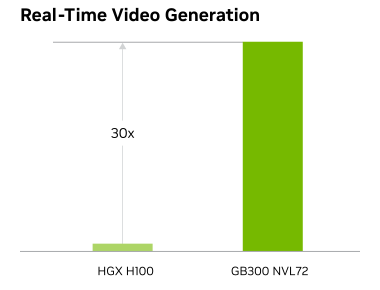
실시간 영상 생성 — HGX H100 대비 GB300 NVL72가 30배 (벤더 제시)
막대 두 개와 「30x」 표기가 전부이고, 세로축에 단위가 없다. 이런 그래프를 볼 때 확인할 것은 늘 같다 — 기준선, 정밀도, 모델, 칩 수, SLO 조건. 특히 「실시간(Real-Time)」이라는 표현이 나오면 그 기준이 무엇인지를 봐야 한다. 영상이라면 초당 프레임, LLM이라면 TPOT이 기준이며, 그 값을 밝히지 않은 「실시간」은 비교에 쓸 수 없다. 여기서 30배는 칩 하나가 아니라 랙(72 GPU) 대 서버(8 GPU) 비교일 가능성이 크다 — 그 점만 확인해도 배수의 의미가 달라진다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)5종 랙 — 워크로드 분해도로서의 제품 라인업
여기가 이 장의 핵심이다. NVIDIA는 이제 랙을 다섯 종류로 나눠 판다. 이 분류는 마케팅 세그먼트가 아니라 워크로드를 지배 자원별로 쪼갠 결과다.
워크로드 단계 → 지배 자원 → 그것을 맡는 랙. 왼쪽 열은 1장에서 배운 워크로드 분해 그대로다.
직접 제작 도해 · 자유 사용한 종류의 랙으로 전부 처리하면, 각 워크로드마다 쓰지 않는 자원의 값을 계속 낸다. 데이터 로딩에 GPU 72장이 붙어 있을 필요가 없고, 디코드에 FP4 50PF의 연산 유닛이 있어봐야 놀 뿐이다.
15장에서 이것을 tokens/$로 환산해 본다. 「랙을 나누는 것이 정말 싼가」는 계산으로 답할 수 있는 질문이다.
- 전송이 늘어난다. 프리필 결과(KV 캐시)를 디코드 랙으로 보내야 한다 — 10장 NIXL, 13장 P/D 분리.
- 라우팅이 필요하다. 어느 요청을 어느 랙으로 보낼지 결정하는 계층이 생긴다 — 13장 Dynamo.
- 운영이 복잡해진다. 랙 종류가 다섯이면 재고·유지보수·장애 대응도 다섯 갈래다.
그래서 소규모에서는 나누지 않는 편이 낫다. 규모가 커질수록 분해의 이득이 오버헤드를 넘어선다.
VR200 NVL72 — 사양표를 읽는 법
아래는 커리큘럼 기준 시점에 공개된 VR200 NVL72의 주요 수치다. 숫자를 외우는 것이 목적이 아니라, 각 숫자가 어느 병목에 대응하는지 짚는 것이 목적이다.
| 항목 | 값 | 이 숫자가 말하는 것 |
|---|---|---|
| GPU 수 | 72 | scale-up 도메인의 크기. 이 안에서는 TP·EP를 자유롭게 쓸 수 있다 |
| NVLink 총합 대역폭 | 260 TB/s | 랙을 「하나의 GPU」로 보이게 하는 핵심 수치 |
| GPU당 HBM4 | 288 GB | 한 GPU에 얹을 수 있는 모델 크기 · KV 캐시 여유 |
| GPU당 HBM 대역폭 | 22 TB/s | 디코드 속도의 상한을 직접 결정한다(1장) |
| 추론 성능 | GB300 NVL72 대비 약 3.3배 | 벤더 발표. 어떤 모델·정밀도·배치인지 확인 필요 |
| 랙 전력 | 약 190–230 kW | 냉각 방식과 배전 설계를 규정한다(11장) |
| 냉각 | 전면 액체냉각 표준 | 선택지가 아니라 전제 조건이 되었다 |
| 출하 | 2026년 하반기 → 2027년 확산 | 도입 계획의 시점 기준 |
GPU당 22 TB/s × 72개 = 랙 하나가 1.5 PB/s 이상의 메모리 대역폭을 갖는다. 1장의 디코드 계산을 랙 단위로 다시 해 보면, 왜 이 랙이 추론에서 유리한지 바로 나온다. 아래 실습에서 직접 계산한다.
랙 한 대를 사면 실제로 무엇이 오는가
「NVL72 한 랙」이라고 하면 캐비닛 하나가 오는 것 같지만, 실제로는 함께 와야만 동작하는 것들의 묶음이다. 설계서를 쓸 때 이 목록을 빠뜨리면 예산과 공간 계산이 통째로 틀어진다.
| 구분 | 무엇이 오는가 | 설계에서 놓치기 쉬운 점 |
|---|---|---|
| 연산 | 컴퓨트 트레이 (CPU + GPU) 18장 | 트레이마다 무게가 상당해 바닥 하중 확인 필요 |
| Scale-up | NVLink 스위치 트레이 + 스파인 케이블 | 케이블이 굵고 굽힘 반경이 커서 정비 공간이 필요 |
| Scale-out | SuperNIC · 포트 | 랙 밖으로 나가는 광케이블 수를 별도로 계산해야 함 (9장) |
| 전력 | 전원 셸프 · 버스바 | 랙 자체 배전과 건물 배전의 접속 규격 확인 (11장) |
| 냉각 | 매니폴드 · 콜드플레이트 · 퀵커넥트 | CDU는 별도다. 랙에 안 들어 있다 |
| 관리 | BMC · 관리 스위치 · 케이블 | 관리망을 별도로 설계해야 함 |
| 소프트웨어 | 펌웨어 · 드라이버 · 관리 스택 | 버전 조합이 맞아야 성능이 난다 |
- CDU(냉각수 분배 장치) — 여러 랙이 공유하며, 용량과 대수를 따로 계산해야 한다.
- scale-out 스위치 — 랙 안 NVLink와 별개다. 9장의 리프–스파인이 여기서 시작한다.
- 스토리지 — 4장의 5종 랙에서 봤듯 별도 랙이다.
- 전력 인입 설비 — 변압기·배전반·UPS. 11장의 계통도 전체.
- 관리망과 운영 도구 — 15장의 관측 스택.
17장 설계서에서 GPU 랙만 계산하고 이 목록을 빠뜨리는 것이 가장 흔한 감점 요인이다.
NVLink Fusion — 문을 조금 여는 이유
Vera Rubin 세대의 전략적으로 가장 흥미로운 대목은 NVLink Fusion이다. NVIDIA가 자사 독점 규격인 NVLink를 외부 칩에 개방하기 시작했다. AWS Trainium4가 이것을 지원해 MGX 랙에서 GPU와 섞여 돌아간다.
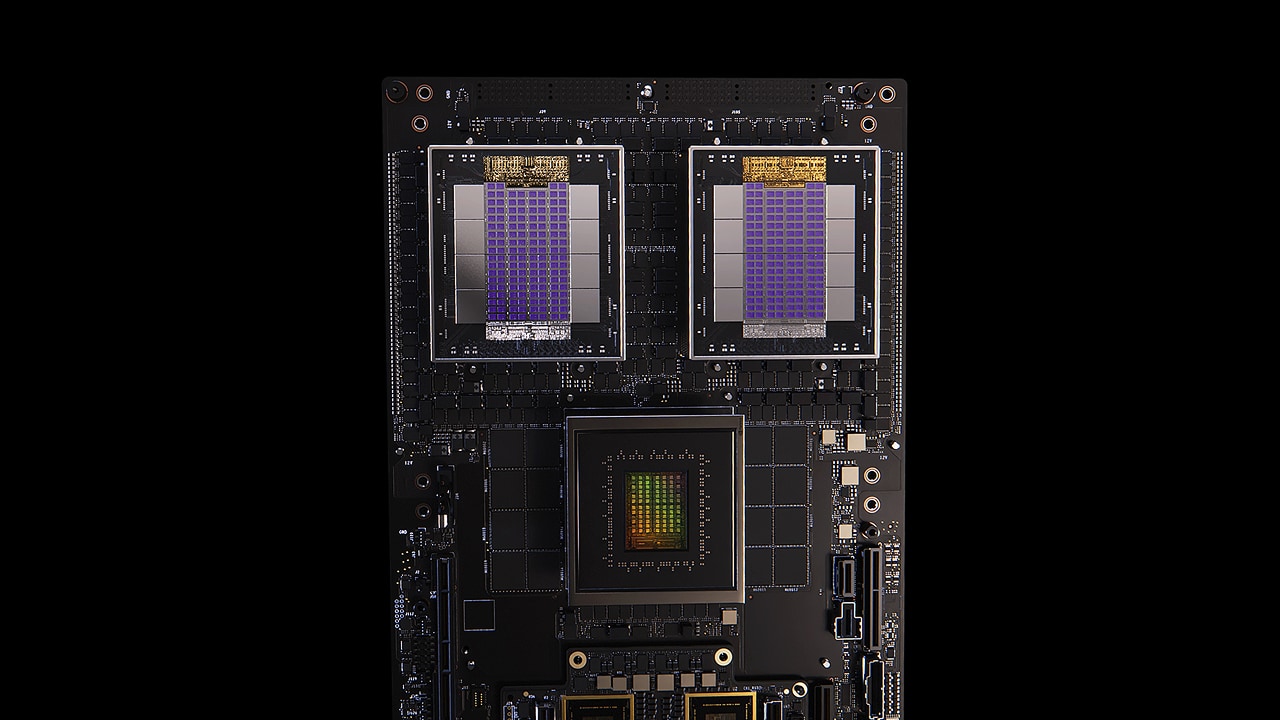
NVLink Fusion 대응 보드. 타사 가속기도 NVLink 도메인에 들어올 수 있게 된다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)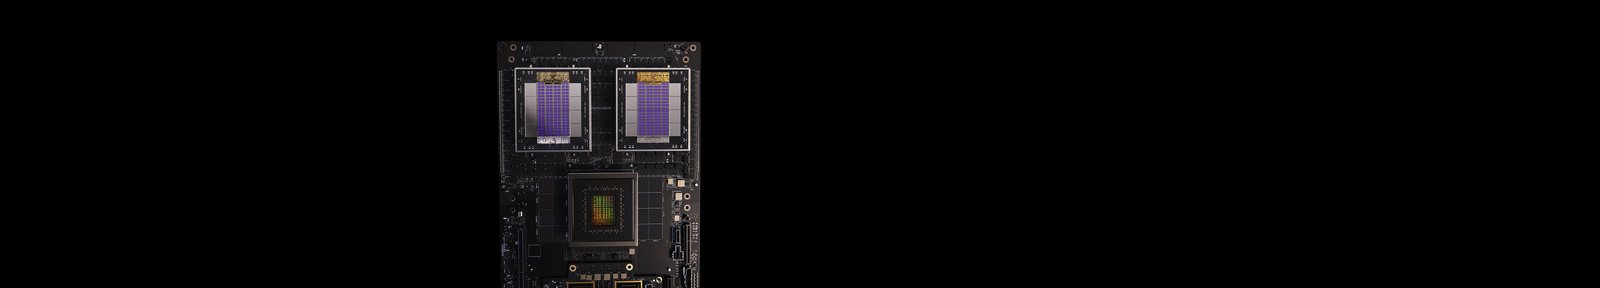
같은 계열의 다른 구성. 랙 설계를 MGX 규격으로 열어 두면 고객이 여러 벤더의 칩을 한 랙에 섞을 수 있다.
출처: www.nvidia.com© www.nvidia.com (교육 목적 인용)독점 규격을 왜 여는가? 상반되는 두 해석이 있다. 어느 쪽이 더 설득력 있는지 토론하라.
- 방어 해석 — UALink 같은 개방형 대안이 세력을 얻기 전에, 「NVLink에 붙을 수 있다」는 선택지를 줘서 이탈을 막는다. 문을 열되 문지방은 여전히 NVIDIA가 소유한다.
- 확장 해석 — 하이퍼스케일러의 자체 칩은 어차피 막을 수 없다. 그렇다면 그 칩들이 NVIDIA의 랙·네트워크·소프트웨어 위에서 돌게 만드는 편이, 생태계 전체의 중심을 유지하는 길이다.
힌트: 5장의 UALink와 6장의 Trainium4를 함께 놓고 보면 그림이 선명해진다.
레퍼런스 디자인 — 랙이 아니라 공장을 판다
- DSX AI Factory 레퍼런스 디자인 — 랙 배치·전력·냉각·네트워크를 포함한 표준 설계도.
- Omniverse DSX — 짓기 전에 디지털 트윈으로 시뮬레이션한다. 전력·열·기류를 미리 검증해 착공 후 설계 변경을 줄이는 것이 목적이다.
- MGX 오픈 랙 — 랙 규격을 열어 ODM과 타사 칩이 들어올 수 있게 한 것.
판매 단위가 「칩」에서 「랙」으로, 다시 「공장 설계도」로 올라가고 있다는 점을 기억하자. 17장 설계 프로젝트에서 여러분이 만들 것도 결국 이 레퍼런스 디자인의 축소판이다.
과제 — 랙 하나를 BOM으로 분해하기
목표: VR200 NVL72(또는 공개 자료가 더 풍부한 GB300 NVL72) 사양표를 읽고, 랙 한 대를 부품·전력·냉각 관점으로 분해한다. 4장 과제로 제출한다.
1단계 — 부품 분해
| 구분 | 품목 | 수량 | 근거(자료 출처) |
|---|---|---|---|
| 연산 | GPU | ||
| 연산 | CPU | ||
| 노드 | 컴퓨트 트레이 | ||
| Scale-up | NVLink 스위치 트레이 | ||
| Scale-out | SuperNIC / 포트 | ||
| 관리·I/O | DPU | ||
| 냉각 | CDU · 매니폴드 · 콜드플레이트 | ||
| 전력 | 전원 셸프 · 버스바 |
2단계 — 전력 예산
- GPU·CPU·스위치·NIC의 TDP 합을 구한다.
- 전원 변환 손실과 냉각 부하를 얹어 랙 입력 전력을 추정한다.
- 공개된 랙 전력값(약 190–230 kW)과 비교한다. 차이가 나면 어디서 나는가?
3단계 — 냉각 요구
랙 전력의 대부분이 열로 나온다고 보고, 필요한 냉각수 유량을 계산하라. 물의 비열 4.18 kJ/(kg·K)와 입·출수 온도차 ΔT를 가정하면 된다. ΔT를 10K로 잡을 때와 20K로 잡을 때 유량이 어떻게 달라지는가?
4단계 — 해석
- 이 랙 1대를 우리 학교 서버실에 넣으려면 무엇이 부족한가? (전력·냉각·바닥하중·소음)
- 1장에서 계산한 디코드 상한을 이 랙(72 GPU × 22 TB/s) 기준으로 다시 구하라. 70B FP8 모델을 서빙한다면 랙 하나가 초당 몇 토큰을 낼 수 있는가?
- 위 계산에서 「배치 크기」를 어떻게 가정했는가? 그 가정이 답을 얼마나 바꾸는가?
제출물
BOM 표 + 전력·냉각 계산 과정 + 해석 (A4 4장 이내). 모든 수치에 출처를 달 것 — 출처 없는 숫자는 감점한다.
참고 자료
- NVIDIA GTC 키노트 및 Technical Blog — 세대별 1차 자료
- NVIDIA GB300 NVL72 제품 페이지 : 이 페이지 그림 다수의 출처
- NVIDIA NVLink / NVLink Fusion
- NVIDIA Spectrum-X
- OCP MGX 규격 문서 — 오픈 랙 설계