하이퍼스케일러 자체 실리콘 — 학습·추론 칩의 분리
Google이 8세대에서 학습칩과 추론칩을 갈라놓은 것은 1장 루프라인의 직접적인 귀결이다. 그리고 자체 칩을 만드는 결정은 기술 문제가 아니라 산수 문제다 — 고정비를 회수할 만큼의 물량이 있는가.
이 장을 마치면
- TPU 8t와 8i의 설계 차이를 워크로드 특성으로 설명할 수 있다.
- 자체 칩 개발의 손익분기 조건을 정량적으로 설명할 수 있다.
- Trainium4의 NVLink Fusion 지원이 갖는 전략적 의미를 해석할 수 있다.
- 네 벤더의 「학습용/추론용」 설계 선택을 표로 정리하고 근거를 댈 수 있다.
자체 칩을 만드는 산수
칩 하나를 설계해 양산까지 가려면 수억 달러 규모의 고정비가 든다. 그런데도 하이퍼스케일러들이 전부 자체 칩을 만든다. 왜인가?
유연성과 효율의 상충. 워크로드가 고정될수록 효율을 사는 쪽이 이득이 된다.
직접 제작 도해 · 자유 사용- 워크로드를 안다 — 자기 서비스에서 무엇이 돌아가는지 정확히 안다. 범용성을 버려도 되는 근거가 여기서 나온다.
- 물량이 있다 — 절감한 전력·임대비의 누적이 설계 고정비를 넘어선다.
이 과목의 6장에 등장하는 네 회사가 전부 세계 최대 규모 사업자인 것은 우연이 아니다. 기술이 있어도 물량이 없으면 자체 칩은 손해다.
부수 효과도 크다. 자체 칩이 있으면 NVIDIA와의 협상에서 대안이 생긴다. 실제로 도입하지 않더라도 「우리에겐 자체 칩이 있다」는 사실 자체가 가격에 영향을 준다.
Google TPU — 8세대에서 갈라진 길
Google은 7세대 Ironwood(9,216칩 포드)까지 하나의 칩으로 학습과 추론을 함께 겨냥했다. 8세대에서 이것을 둘로 나눴다.
| TPU 8t (학습) | TPU 8i (추론) | |
|---|---|---|
| 겨냥하는 단계 | 사전학습 · 사후학습 | 추론 — 특히 디코드 |
| 규모 | 슈퍼포드 9,600칩 | 저지연 · 소규모 단위 |
| 메모리 | HBM 총 2 PB | HBM 288 GB + SRAM 384 MB |
| 저정밀 성능 | FP4 121 EF | — |
| 네트워크 | Virgo | — |
| 설계의 초점 | 칩을 최대한 많이 묶는 것 | 토큰 하나의 지연을 줄이는 것 |
학습과 프리필은 연산 한계 영역이다. 칩을 많이 묶고 네트워크를 굵게 하는 것이 이득이다. 디코드는 메모리 대역폭 한계 영역이다. 칩을 많이 묶어도 각 칩이 놀 뿐이고, 필요한 것은 가까운 곳의 빠른 메모리다.
하나의 칩으로 둘 다 잘하려면 양쪽에 다 투자해야 하고, 그러면 양쪽 다 어중간해진다. TPU 8i에 384 MB SRAM이 들어간 것은 디코드를 정면으로 노린 선택이다 — 7장에서 이 방식의 원리와 한계를 자세히 본다.
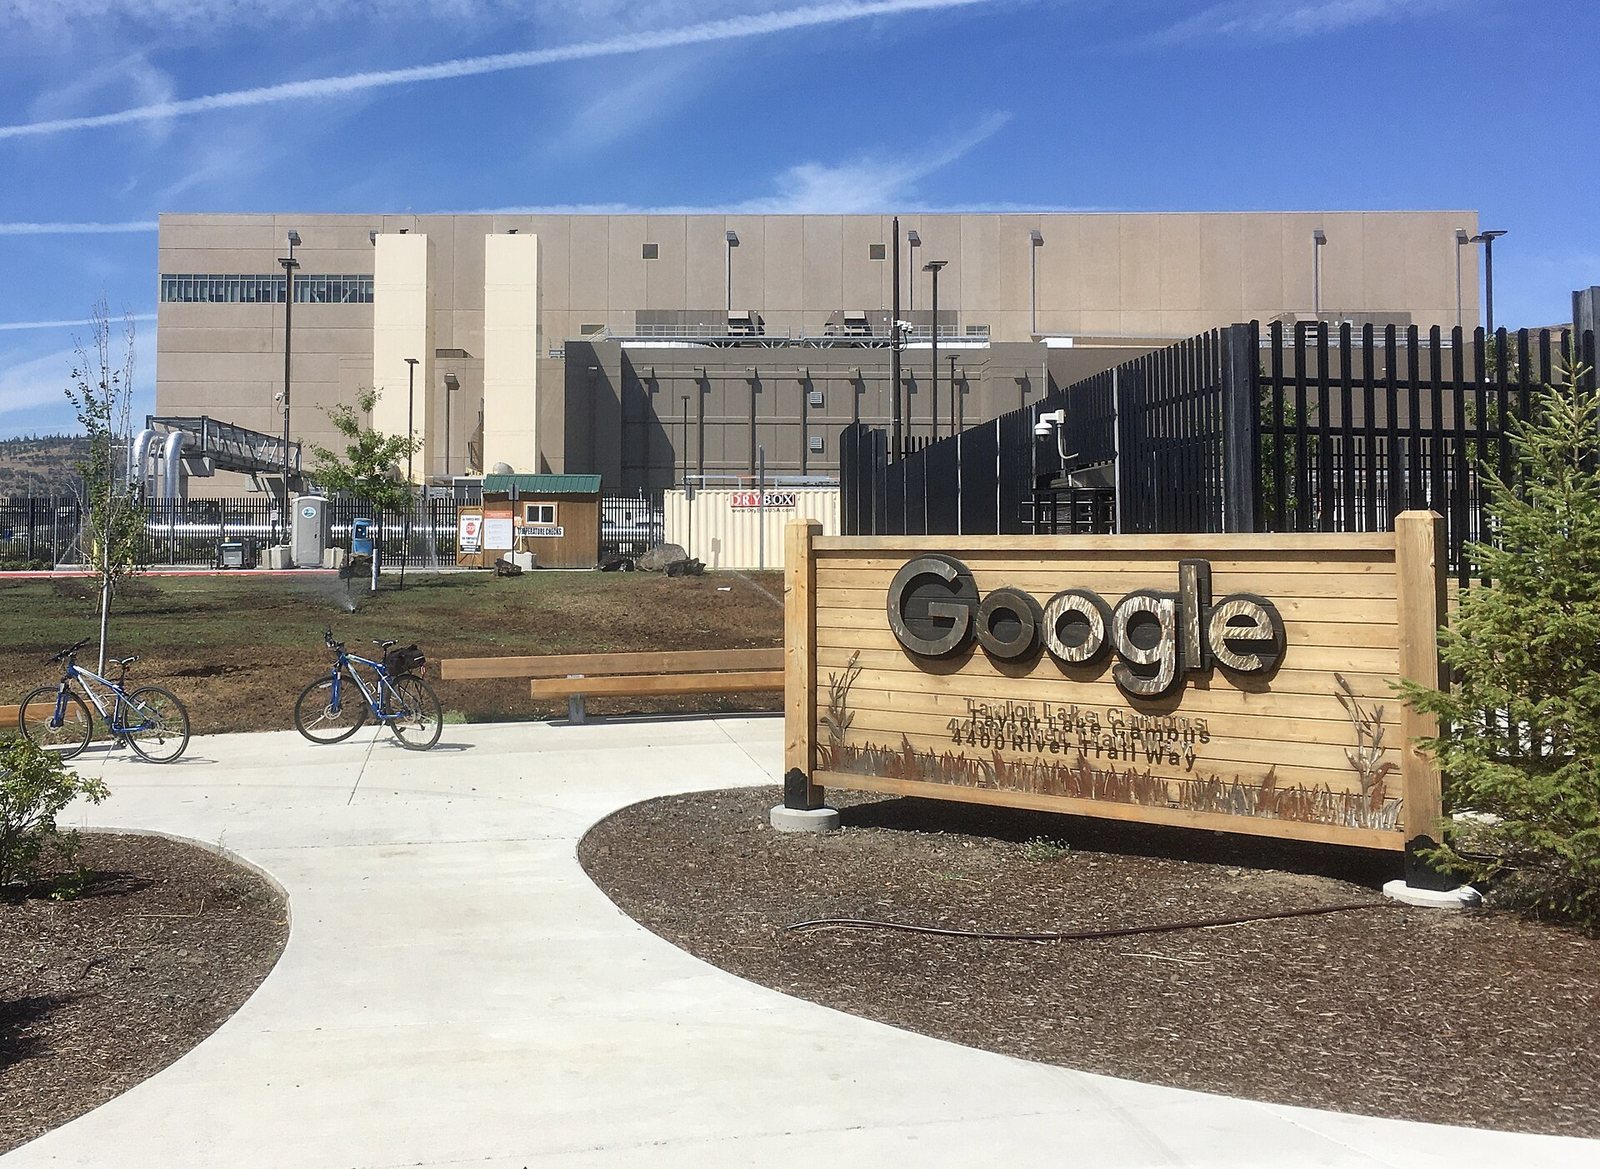
Google 데이터센터 내부 — 자체 칩 전략이 성립하는 조건
자체 칩의 효과는 칩만 만든다고 나오지 않는다. 보드, 랙, 냉각 루프, 네트워크 토폴로지, 그리고 그 위에 도는 소프트웨어까지 한 회사가 통제할 수 있을 때 최적화가 끝까지 간다. 2장에서 본 TPU v3의 액체냉각이 일찍 도입될 수 있었던 것도 같은 이유다.
출처: LambtronCC BY-SA 4.0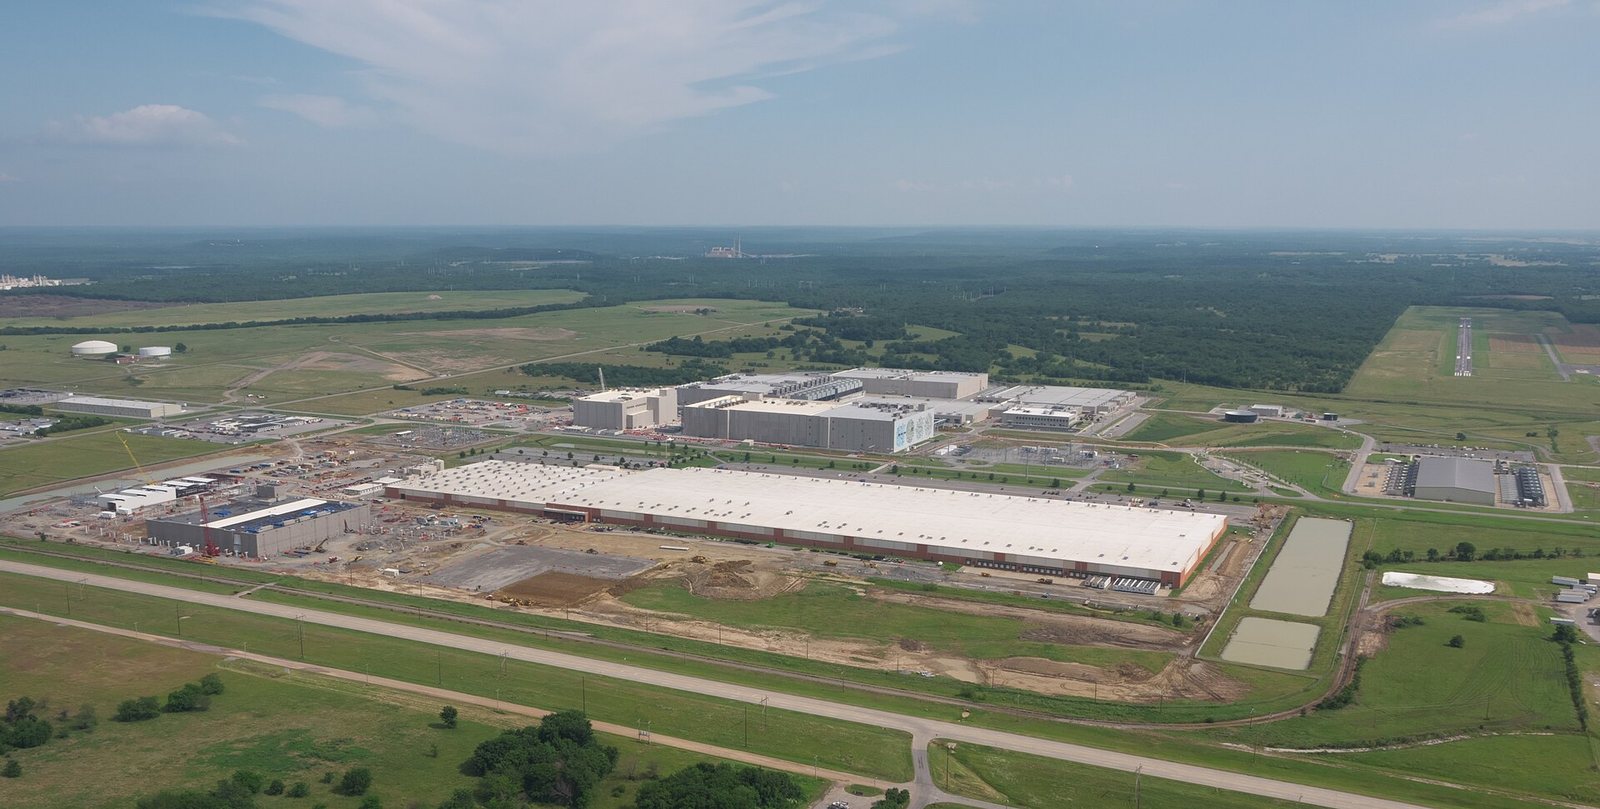
데이터센터 건설 현장 — 칩 이야기가 결국 토목 이야기가 되는 지점
부지, 전력 인입, 냉각 수원, 광케이블 경로가 먼저 정해지고 그 위에 건물이 선다. 5장에서 본 GW 단위 계약은 이런 공사 수백 건을 의미하며, 그래서 리드타임이 수년 단위다. 11장에서 「어느 세대 기준으로 설계할 것인가」가 왜 어려운 질문인지가 여기서 나온다.
출처: XpdaCC BY-SA 4.0TPU는 오랫동안 스위치형이 아닌 토러스 토폴로지를 써 왔다. 스위치를 줄이는 대신 이웃 칩과의 연결에 집중하는 방식으로, 8장에서 NVSwitch 방식과 비교한다.
AWS Trainium — 비용 최적화라는 일관된 목표
AWS의 자체 칩은 성능 1위를 노린 적이 없다. 목표는 언제나 같은 성능을 더 싼 인스턴스 단가로 제공하는 것이다.
| Trainium3 | Trainium4 | |
|---|---|---|
| 공정 | 3nm | — |
| 메모리 | HBM3e 144 GB | — |
| 저정밀 성능 | FP8 2.52 PF | FP4 기준 약 6배 |
| 서버 단위 | UltraServer 144칩 · FP8 362 PF | — |
| Scale-up | NeuronSwitch-v1 | NVLink Fusion 지원 |
| 클러스터 | UltraCluster 3.0 | MGX 랙에서 GPU와 혼용 |
자체 칩을 만드는 이유가 「NVIDIA 의존도를 낮추는 것」이었는데, 그 칩이 NVIDIA의 NVLink에 붙는다. 모순처럼 보이지만 논리는 명확하다.
- 고객 입장에서 「GPU냐 Trainium이냐」의 양자택일은 부담이다. 같은 랙에서 섞어 쓸 수 있으면 도입 장벽이 사라진다.
- AWS는 NVIDIA GPU도 대량으로 판다. 두 제품을 한 랙에 넣을 수 있으면 인스턴스 구성의 자유도가 올라간다.
- NVIDIA 입장에서도 나쁘지 않다 — 4장 NVLink Fusion 토론과 이어진다.
정리하면, 자체 칩 전략은 「NVIDIA를 대체한다」기보다 「선택지를 만들어 협상력을 얻는다」에 가깝다. 실제 도입 비중이 얼마든, 대안의 존재 자체가 가격에 반영된다.
Microsoft · Meta · OpenAI
| 칩 | 주요 사양 | 위치 | |
|---|---|---|---|
| Microsoft | Maia 200 | 3nm · 1,400억 트랜지스터 · HBM3e 6스택 · 750W | Azure 내부 워크로드 |
| Meta | MTIA (로드맵 진행 중) | — | 추천·랭킹 등 자사 워크로드 |
| OpenAI | Jalapeño | 추론 ASIC · 700W | 자사 추론 서빙 |
OpenAI의 Jalapeño에는 별도로 짚을 대목이 있다. AI를 활용해 9개월 만에 테이프아웃했다는 점이다. 칩 설계 기간이 짧아지면 자체 칩의 고정비가 내려가고, 그러면 위 「손익분기」 조건을 만족하는 회사가 늘어난다. 이 흐름이 계속되면 자체 칩을 만드는 주체의 문턱이 낮아질 수 있다.
Maia 200, MTIA 로드맵, Jalapeño는 대부분 Hot Chips 등 학회 발표와 제한적인 공개 자료에 근거한다. 상용 제품처럼 사양표가 정리돼 있지 않으며 표의 빈칸은 「없음」이 아니라 「확인하지 못함」이다. 매년 8월 Hot Chips 직후에 이 절을 갱신할 것.
자체 칩의 수명 주기 — 왜 이렇게 오래 걸리나
「자체 칩을 만들자」는 결정에서 실제로 서비스에 투입되기까지 걸리는 시간을 보면, 왜 아무나 못 하는지가 보인다.
| 단계 | 대략 기간 | 무엇을 하나 | 실패하면 |
|---|---|---|---|
| 아키텍처 정의 | 6~12개월 | 어떤 워크로드를 얼마나 빨리 돌릴 것인가 | 3년 뒤 워크로드와 안 맞는 칩이 나온다 |
| RTL 설계·검증 | 12~18개월 | 회로를 짜고 시뮬레이션으로 검증 | 버그가 실리콘에 굳어 재제작(수백억 원) |
| 테이프아웃·제조 | 3~6개월 | 파운드리에 넘겨 웨이퍼 제작 | 수율이 안 나오면 원가가 폭등 |
| 브링업·디버깅 | 3~6개월 | 실물이 돌아가게 만들기 | 이 단계에서 결함이 나오면 일정이 통째로 밀린다 |
| 소프트웨어 스택 | 병행 + 그 이후로도 계속 | 컴파일러·런타임·프레임워크 연동 | 칩은 되는데 쓸 수가 없다 — 가장 흔한 실패 |
| 양산·배치 | 6~12개월 | 물량 확보, 데이터센터 설치 | 공급망 병목 (2장의 CoWoS 등) |
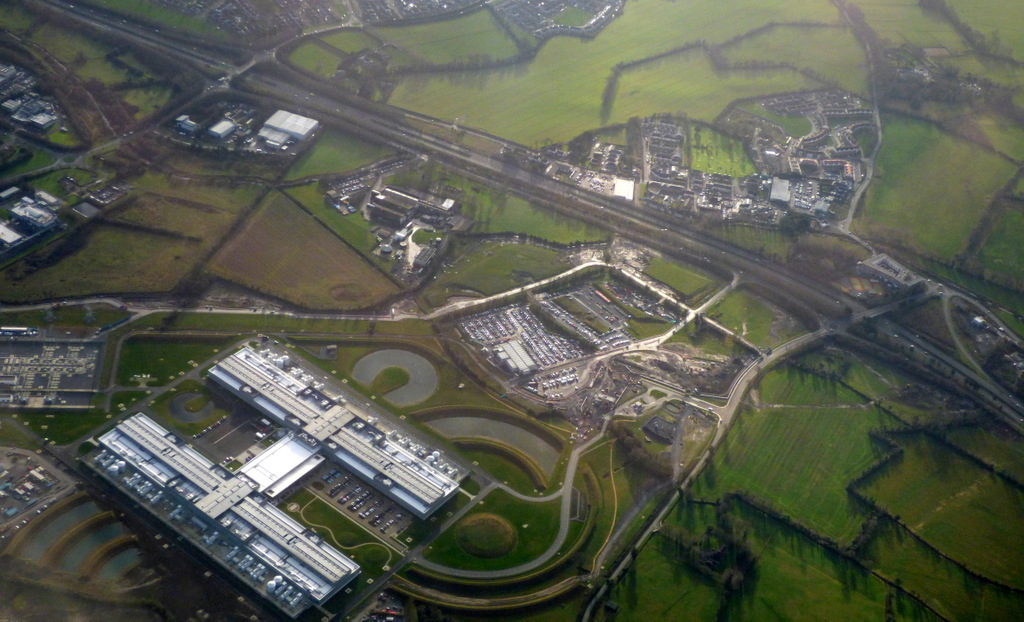
항공에서 본 하이퍼스케일 데이터센터
긴 건물 여러 동이 나란히 서고, 그 옆에 변전·냉각 설비가 붙는다. 자체 칩을 만들 만한 회사는 이런 부지를 여러 개 갖고 있다 — 6장 첫머리의 「물량이 있는가」라는 조건이 시각적으로 확인되는 지점이다.
출처: Thomas NugentCC BY-SA 2.0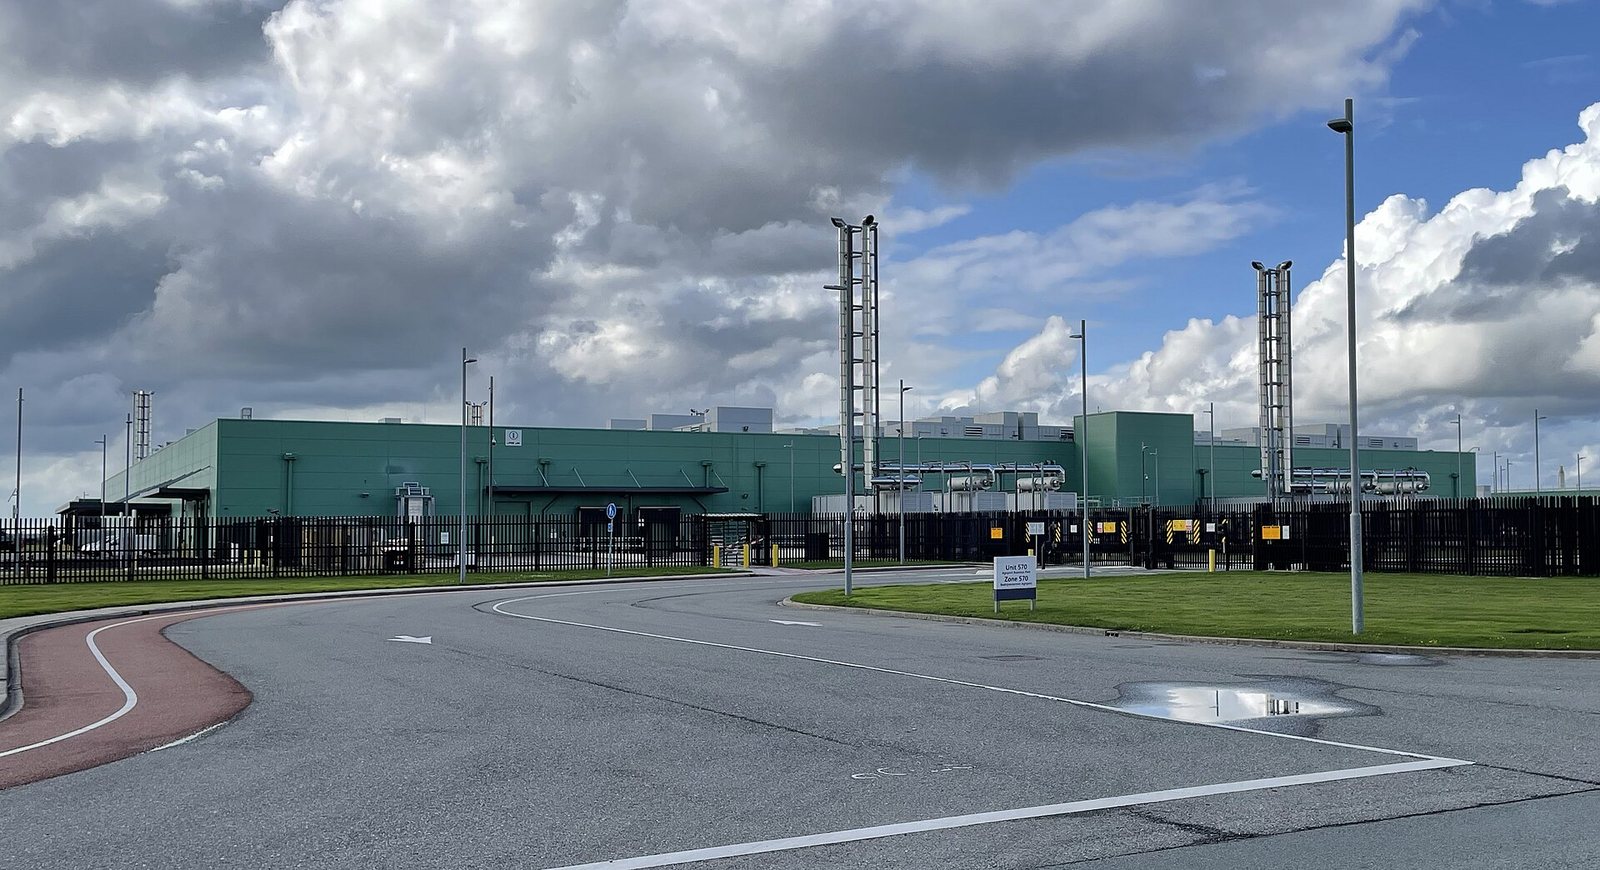
다른 사업자의 시설 — 형태가 거의 같다
회사가 달라도 건물의 형태가 비슷한 것은 제약이 같기 때문이다. 전력 인입, 냉각, 케이블 경로, 확장 여지가 형태를 결정한다. 17장 설계에서 「왜 이런 배치인가」를 설명할 때 이 제약들이 근거가 된다.
출처: Hay KranenCC BY 4.0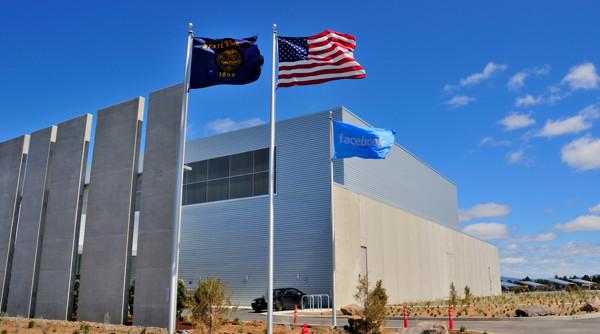
지상에서 본 외관 — 창문이 거의 없다
사람이 상주하지 않으므로 채광이 필요 없고, 외벽은 단열과 기류 관리를 위해 존재한다. 건물이 곧 하나의 큰 냉각 장치인 셈이다.
출처: Intel Free PressCC BY 2.0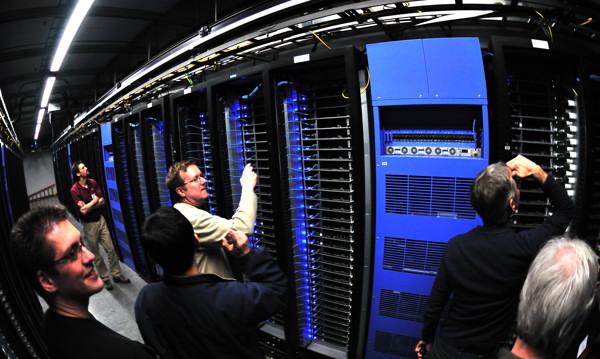
내부 — 랙 열과 통로
사람이 다니는 통로 폭과 랙 높이가 보인다. 이 여유 공간이 11장에서 볼 액체냉각 배관과 CDU가 들어갈 자리이기도 하다. 기존 시설을 AI용으로 개조할 때 이 여유가 있는지가 관건이 된다.
출처: Intel Free PressCC BY 2.0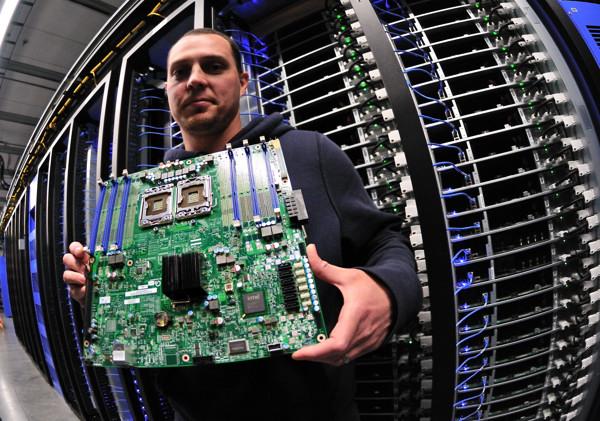
자체 설계 서버 보드
시판 서버를 사지 않고 자기 워크로드에 맞춰 보드를 직접 설계한다. 불필요한 부품을 빼고, 냉각과 정비를 자기 시설에 맞춘다. 칩을 만들기 전 단계로 대부분의 하이퍼스케일러가 먼저 여기까지 왔고, OCP는 그 설계를 공개하자는 운동에서 시작됐다.
출처: Intel Free PressCC BY 2.02026년에 서비스에 들어가는 칩은 2022~2023년에 아키텍처가 정해진 것이다. 그때는 지금의 MoE 비중이나 긴 컨텍스트 요구를 정확히 예측하기 어려웠다.
그래서 자체 칩 설계에서 가장 어려운 판단은 성능이 아니라 「3년 뒤에도 유효할 만큼 일반적이면서, 효율을 낼 만큼은 특화된」 지점을 찾는 것이다. 너무 특화하면 못 쓰고, 너무 일반화하면 GPU를 살 이유가 없어진다.
OpenAI의 Jalapeño가 AI를 활용해 9개월 만에 테이프아웃했다는 것이 의미 있는 이유가 여기 있다. 설계 기간이 짧아지면 이 예측 위험이 통째로 줄어든다.
네 벤더를 한 표로
이 장의 결론을 한 장으로 정리하면 다음과 같다. 실습에서 여러분이 채워 넣을 표의 뼈대이기도 하다.
| 학습칩 | 추론칩 | 분리했는가 | 핵심 논리 | |
|---|---|---|---|---|
| NVIDIA | Rubin GPU | Rubin GPU + Groq 3 LPU | 부분적으로 | 하나의 GPU로 커버하되 디코드는 전용 하드웨어로 보완 |
| AMD | MI455X | MI455X | 아니오 | 용량 우위로 양쪽을 커버 — 제품군을 단순하게 유지 |
| TPU 8t | TPU 8i | 예 (8세대부터) | 워크로드가 확실하므로 각각 최적화하는 편이 이득 | |
| AWS | Trainium3/4 | Inferentia 계열 · Trainium | 역사적으로 예 | 인스턴스 단가 최적화가 목표 |
토론 주제: 분리할 것인가, 하나로 갈 것인가?
- Google은 분리했고 AMD는 안 했다. 두 회사의 사업 구조 차이가 이 선택을 어떻게 설명하는가? (힌트: 한쪽은 자기가 쓰고, 다른 쪽은 남에게 판다)
- NVIDIA가 Groq를 인수해 라인업에 넣은 것은 「분리」인가 「보완」인가?
- 추론 비중이 계속 커진다면 5년 뒤 이 표는 어떻게 바뀌어 있을까?
- 우리나라 기업이 자체 칩을 만든다면 위 두 조건(워크로드를 안다 / 물량이 있다)을 만족하는가? 7장의 국산 NPU와 이어서 생각해 보라.
실습 — 설계 선택의 근거를 재구성하기
목표: 네 벤더 칩의 「학습용/추론용」 설계 선택을 표로 정리하고, 각 선택의 근거를 워크로드 특성으로 설명해 5분간 발표한다.
1단계 — 자료 수집
- 각 벤더의 1차 자료(블로그·키노트·Hot Chips 슬라이드)에서 사양을 확보한다.
- 출처 URL과 발표 시점을 반드시 기록한다. 2차 보도만 인용하지 말 것.
- 확인되지 않는 항목은 빈칸으로 두고 「미확인」이라고 표시한다.
2단계 — 표 작성
| 메모리 용량 | 메모리 대역폭 | 온칩 SRAM | 저정밀 지원 | 묶는 방식 | 겨냥한 단계 | |
|---|---|---|---|---|---|---|
| NVIDIA Rubin | ||||||
| AMD MI455X | ||||||
| Google TPU 8t | ||||||
| Google TPU 8i | ||||||
| AWS Trainium3 | ||||||
| Microsoft Maia 200 |
3단계 — 근거 재구성 (발표의 핵심)
각 행에 대해 다음 질문에 답하라. 사양을 읽는 것이 아니라 이유를 설명하는 것이 과제다.
- 이 칩은 어느 단계(학습/프리필/디코드)를 주로 겨냥했는가? 어떤 수치가 그 근거인가?
- 설계자는 「용량 · 대역폭 · SRAM」 중 무엇을 우선했는가? 무엇을 포기했는가?
- 그 선택이 이 회사의 사업 구조와 어떻게 맞물리는가?
- 1장 루프라인 위에 이 칩을 놓는다면 어디쯤인가?
제출물
표(출처 포함) + 발표 슬라이드 5장 이내. 평가는 표의 완성도보다 근거 설명의 설득력에 둔다.
참고 자료
- Google Cloud Blog — TPU : 이 페이지 자료 일부의 출처
- AWS Trainium
- Hot Chips 발표 슬라이드 (hotchips.org) — Maia·MTIA·Jalapeño의 1차 자료
- SemiAnalysis — TPU·Trainium 딥다이브
- Jouppi et al., TPU 관련 ISCA 논문 시리즈