추론 특화 아키텍처와 국산 NPU, 그리고 한국의 AI 인프라
디코드가 메모리 대역폭에 묶인다는 사실을 정면으로 노린 설계들이 있다. 그 원리를 이해하면 왜 웨이퍼 한 장이 통째로 칩이 되는지, 그리고 국산 NPU가 어디를 노리고 있는지가 보인다. 마지막으로 국가AI컴퓨팅센터를 놓고 「우리라면 어떻게 지을 것인가」를 묻는다.
이 장을 마치면
- SRAM 기반 추론 가속기가 대역폭을 얻는 원리와 그 대가를 설명할 수 있다.
- 웨이퍼스케일 집적의 이점과 수율 문제 해법을 설명할 수 있다.
- 국산 NPU의 기술적 포지셔닝과 공급 실적을 평가할 수 있다.
- 공개 자료를 근거로 데이터센터 장비 구성 제안서를 작성할 수 있다.
SRAM 기반 추론 — 대역폭을 곱하는 방법
1장에서 디코드 속도의 상한은 HBM 대역폭 ÷ 가중치 크기였다. 2장에서 분모를 줄이는 방법(양자화)을 봤다. 이 절은 분자를 늘리는 다른 길에 대한 것이다.
같은 모델을 한 칩의 HBM에 넣을 때와 여러 칩의 SRAM에 쪼개 넣을 때. 후자는 대역폭을 물리적으로 늘린 것이 아니라 칩 수만큼 곱해서 얻는다.
직접 제작 도해 · 자유 사용SRAM은 HBM보다 용량당 비용이 훨씬 비싸고 밀도가 낮다. 그래서 큰 모델을 담으려면 칩이 수백 개 필요하다. 그런데 각 칩은 자기가 가진 조각만 읽으면 되므로, 유효 대역폭이 칩 수만큼 곱해진다.
이것이 SRAM 기반 추론 가속기가 극단적으로 낮은 토큰 지연을 내는 원리다. 대가는 칩 수, 전력, 공간, 그리고 모델이 바뀔 때마다 다시 쪼개야 하는 유연성 손실이다.
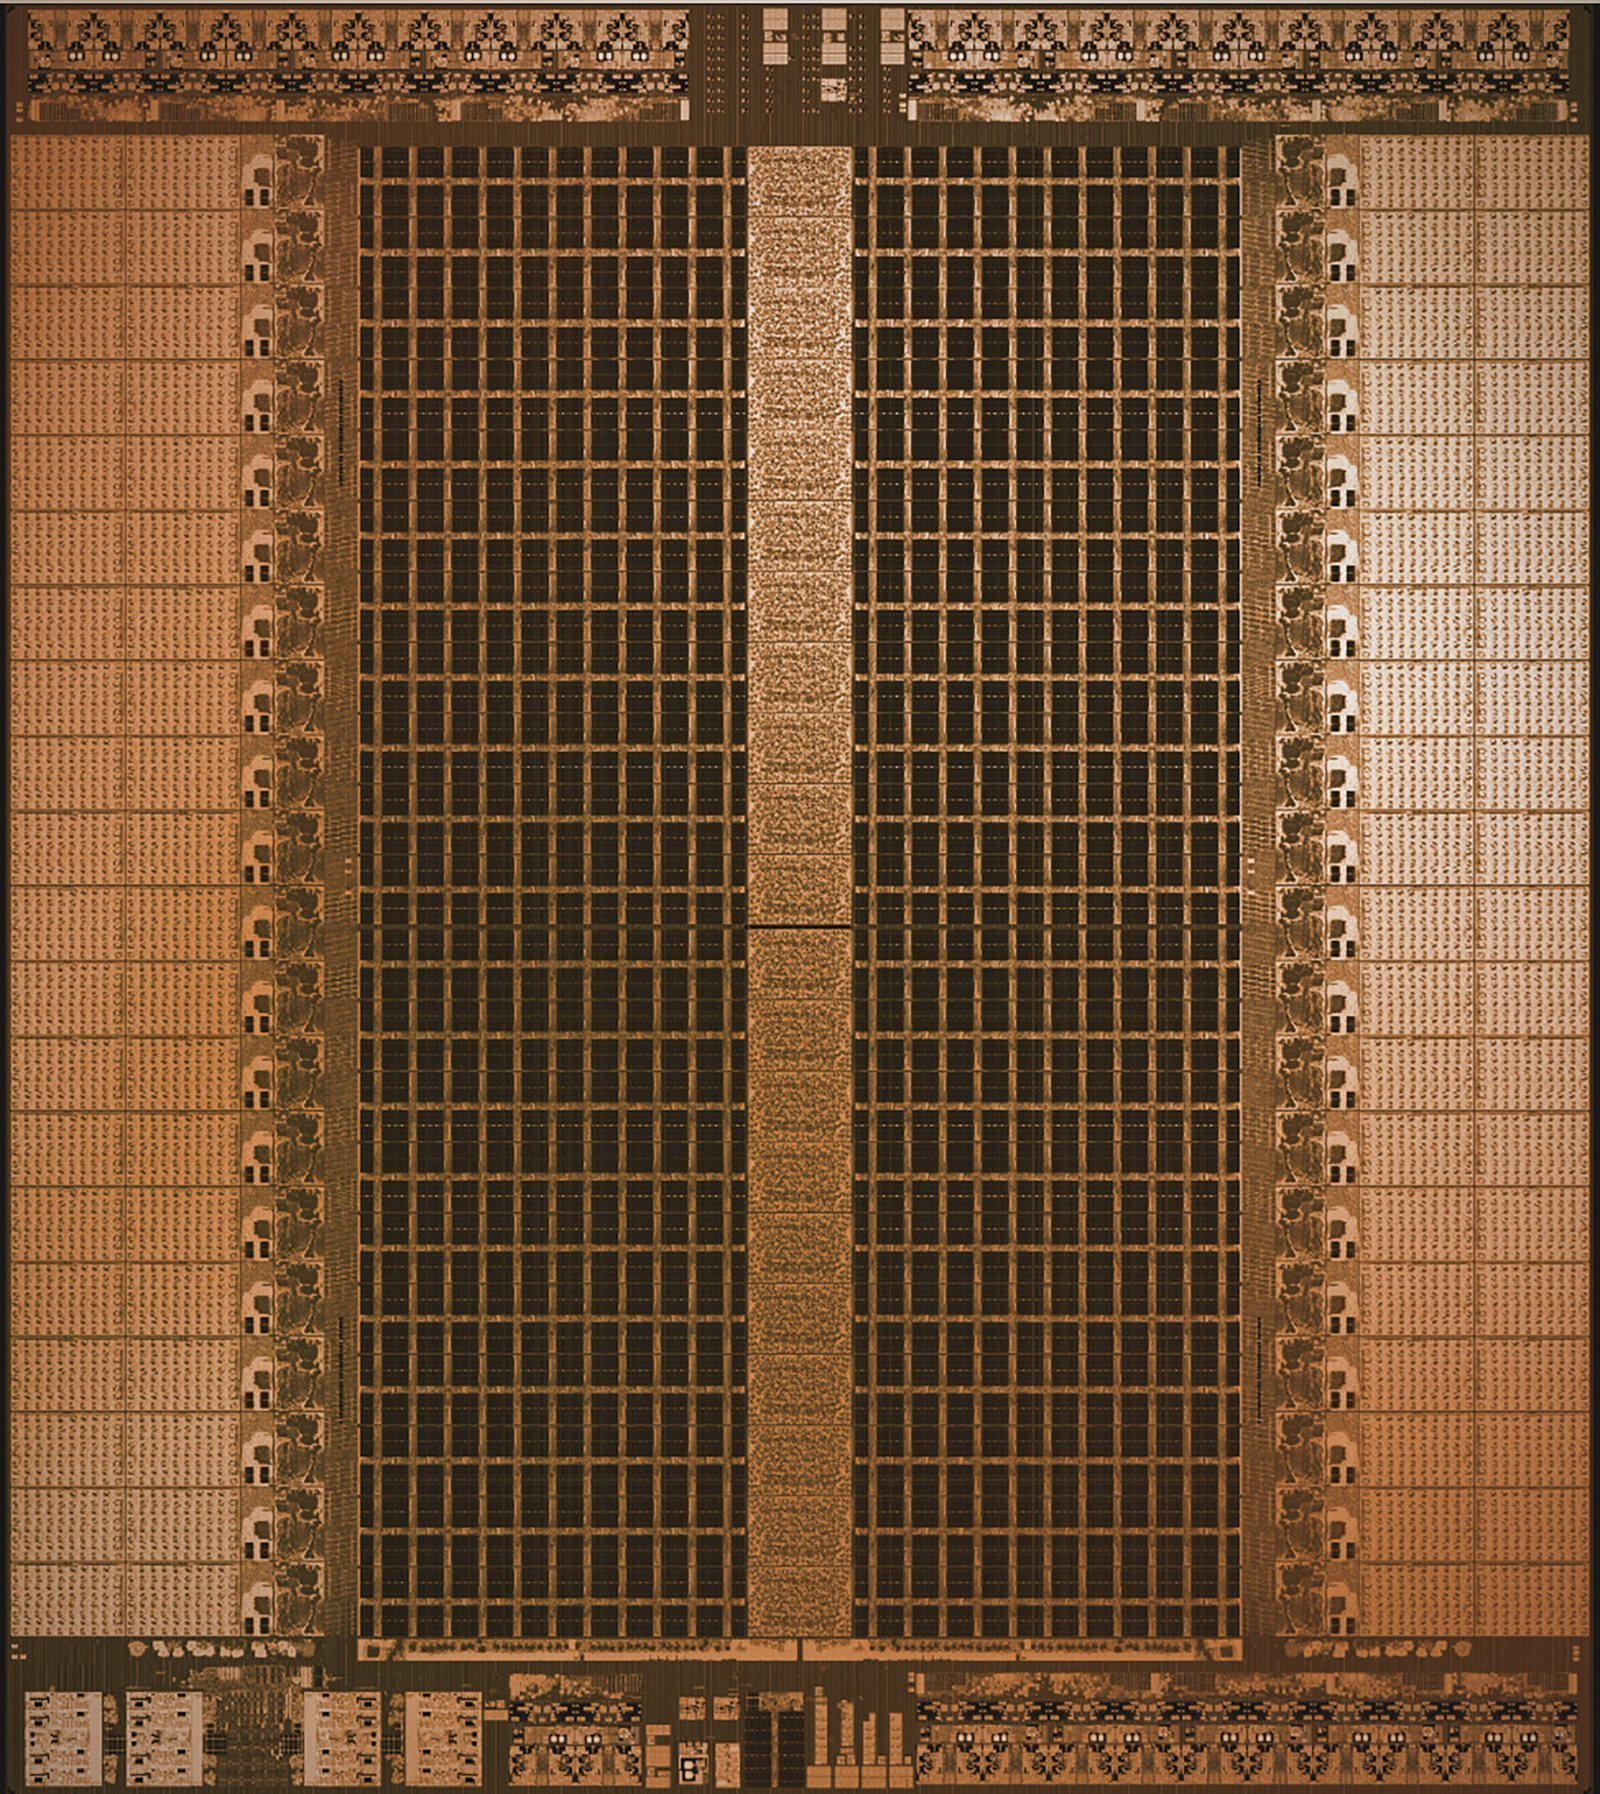
Groq LPU v1 다이샷. 가운데를 가득 채운 규칙적인 격자가 온칩 SRAM 어레이다. 2장에서 본 범용 GPU 다이와 비교해 보라 — 면적의 배분이 완전히 다르다. 이 칩은 「메모리를 칩 안에 넣는다」는 한 가지 목표에 면적을 몰아넣었다.
출처: AvivweinsteinCC BY-SA 4.0Vera Rubin 세대에서 NVIDIA가 Groq를 인수해 Groq 3 LPX를 디코드 전용 랙으로 편입한 것(4장), Google이 TPU 8i에 384 MB SRAM을 넣은 것(6장)이 모두 같은 논리 위에 있다.
추론 특화 진영 — 네 가지 접근
Cerebras — 웨이퍼 한 장을 통째로 칩으로
칩을 여러 개 만들어 연결하면 칩 사이 통신이 병목이 된다. 그렇다면 자르지 않으면 어떨까? 이것이 웨이퍼스케일 집적의 발상이다.
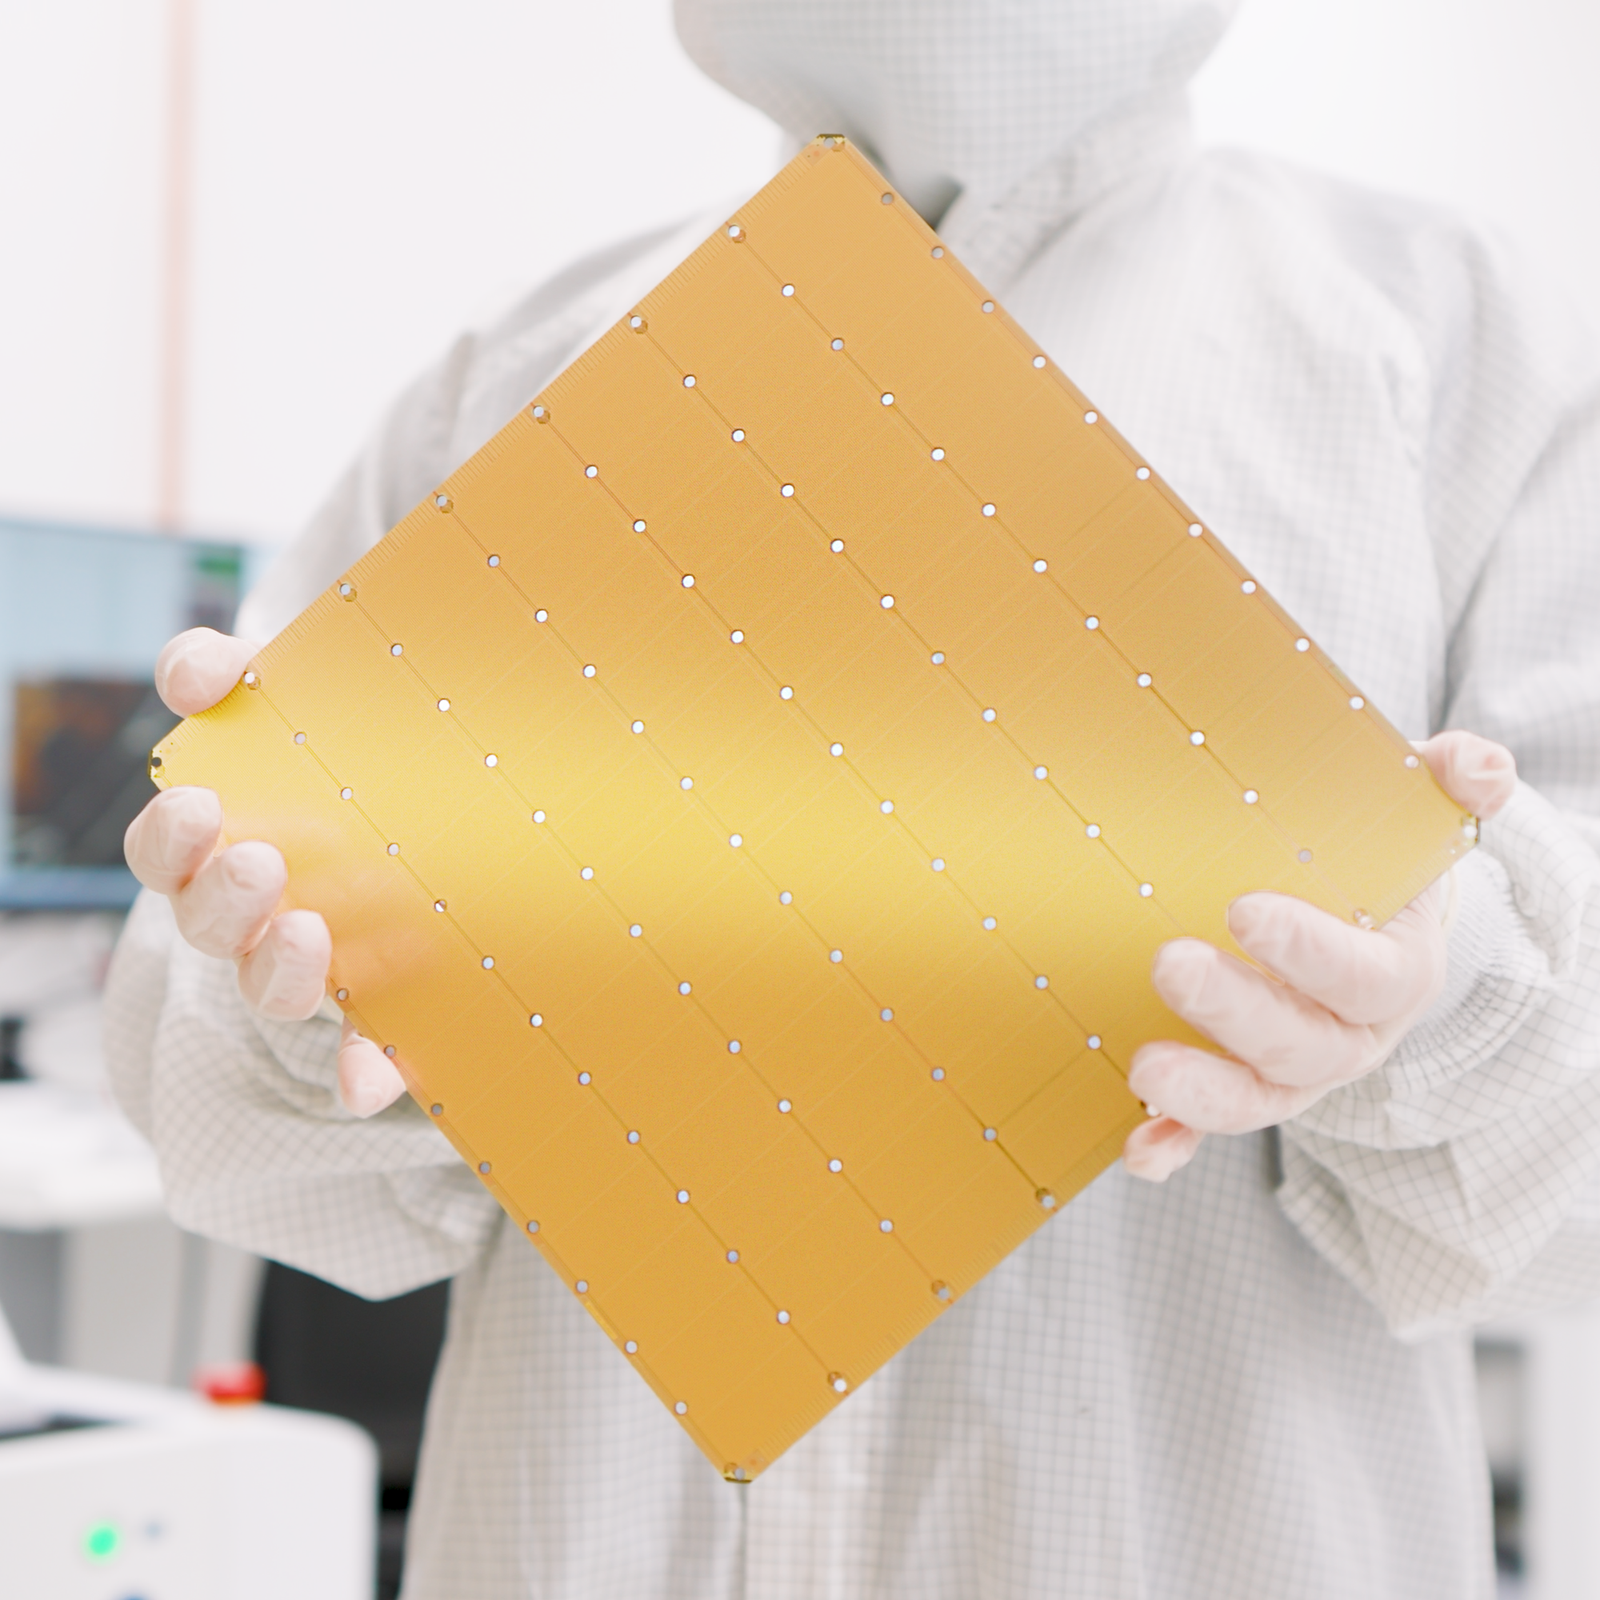
웨이퍼스케일 엔진 실물 — 사람 손과 비교한 크기
2장에서 본 대로 보통은 웨이퍼를 잘라 다이 수백 개를 만든다. 여기서는 자르지 않고 웨이퍼 한 장을 통째로 하나의 칩으로 쓴다. 칩 사이를 나가는 통신이 원천적으로 없어지므로 지연이 극도로 낮지만, 제조·전력공급·냉각·수율이 전부 새로운 문제가 된다.
출처: www.cerebras.ai© www.cerebras.ai (교육 목적 인용)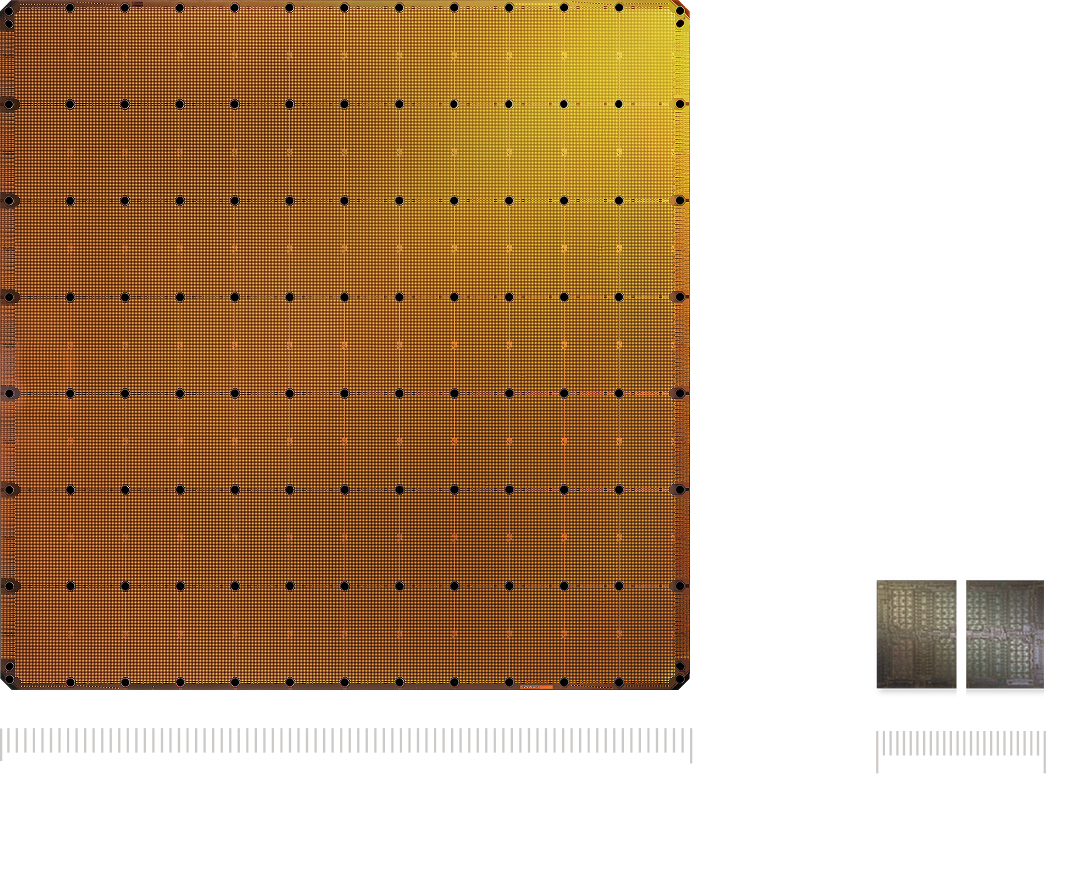
일반 GPU와의 크기 비교
오른쪽 아래 작은 사각형이 일반 GPU 다이다. 면적 차이가 수십 배다. 이 면적 대부분이 온칩 SRAM과 연산 유닛이며, 그래서 위 도해의 「대역폭을 칩 수만큼 곱한다」를 한 장의 실리콘 안에서 달성한다.
출처: www.cerebras.ai© www.cerebras.ai (교육 목적 인용)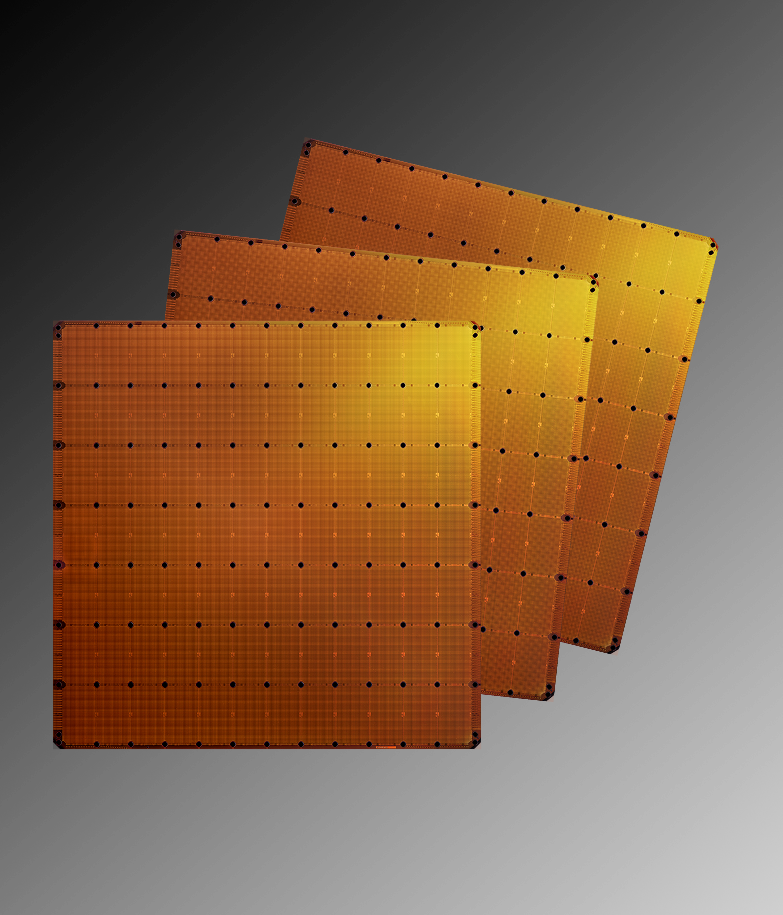
웨이퍼 여러 장 — 양산의 실체
한 장이 하나의 제품이므로 웨이퍼 한 장의 값이 곧 칩 한 개의 값이다. 일반 칩은 웨이퍼 한 장에서 수백 개가 나오므로 개당 원가가 나뉘지만, 여기서는 그 나눔이 없다. 7장의 「왜 다들 이 방식으로 가지 않는가」의 가장 직접적인 답이 원가다.
출처: www.cerebras.ai© www.cerebras.ai (교육 목적 인용)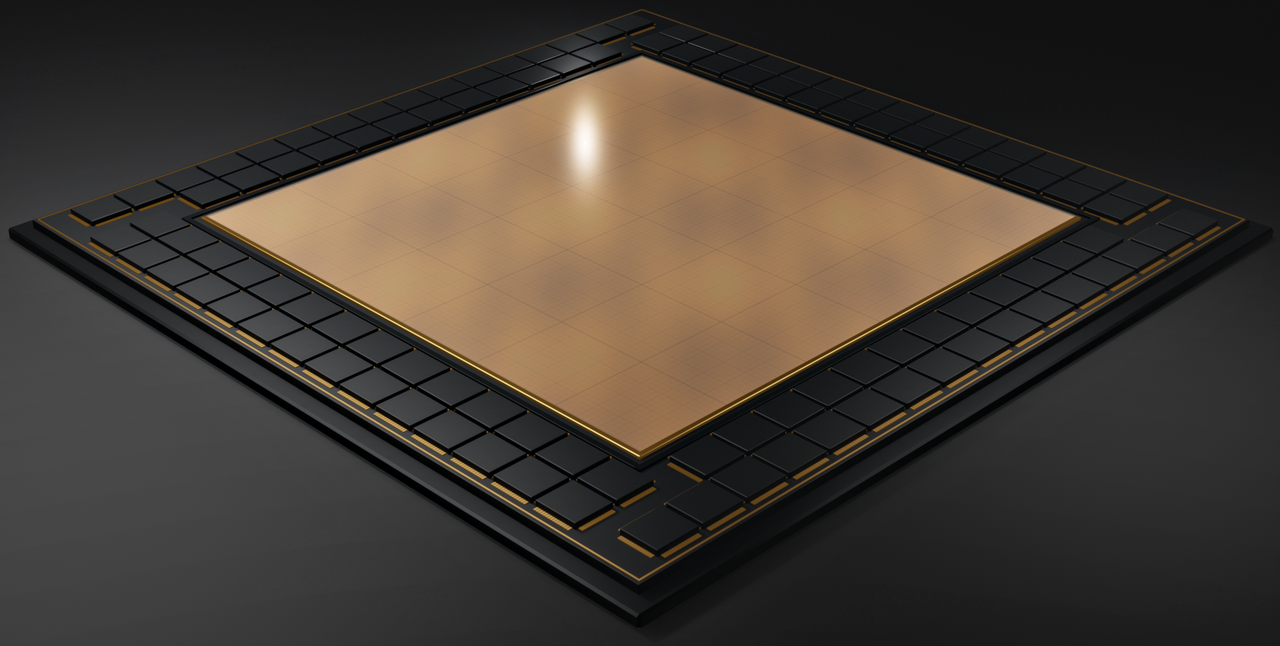
웨이퍼스케일 칩의 렌더링 — 구조를 보기 위한 그림
격자로 반복되는 타일 하나하나가 연산 코어와 로컬 SRAM의 묶음이다. 타일 사이는 칩 안의 배선으로 연결되므로 「네트워크」가 아니라 「메모리 버스」에 가깝다. 8장에서 본 scale-up의 의미론을 한 칩 안에서 구현한 셈이다.
출처: en.wikipedia.org© en.wikipedia.org (교육 목적 인용)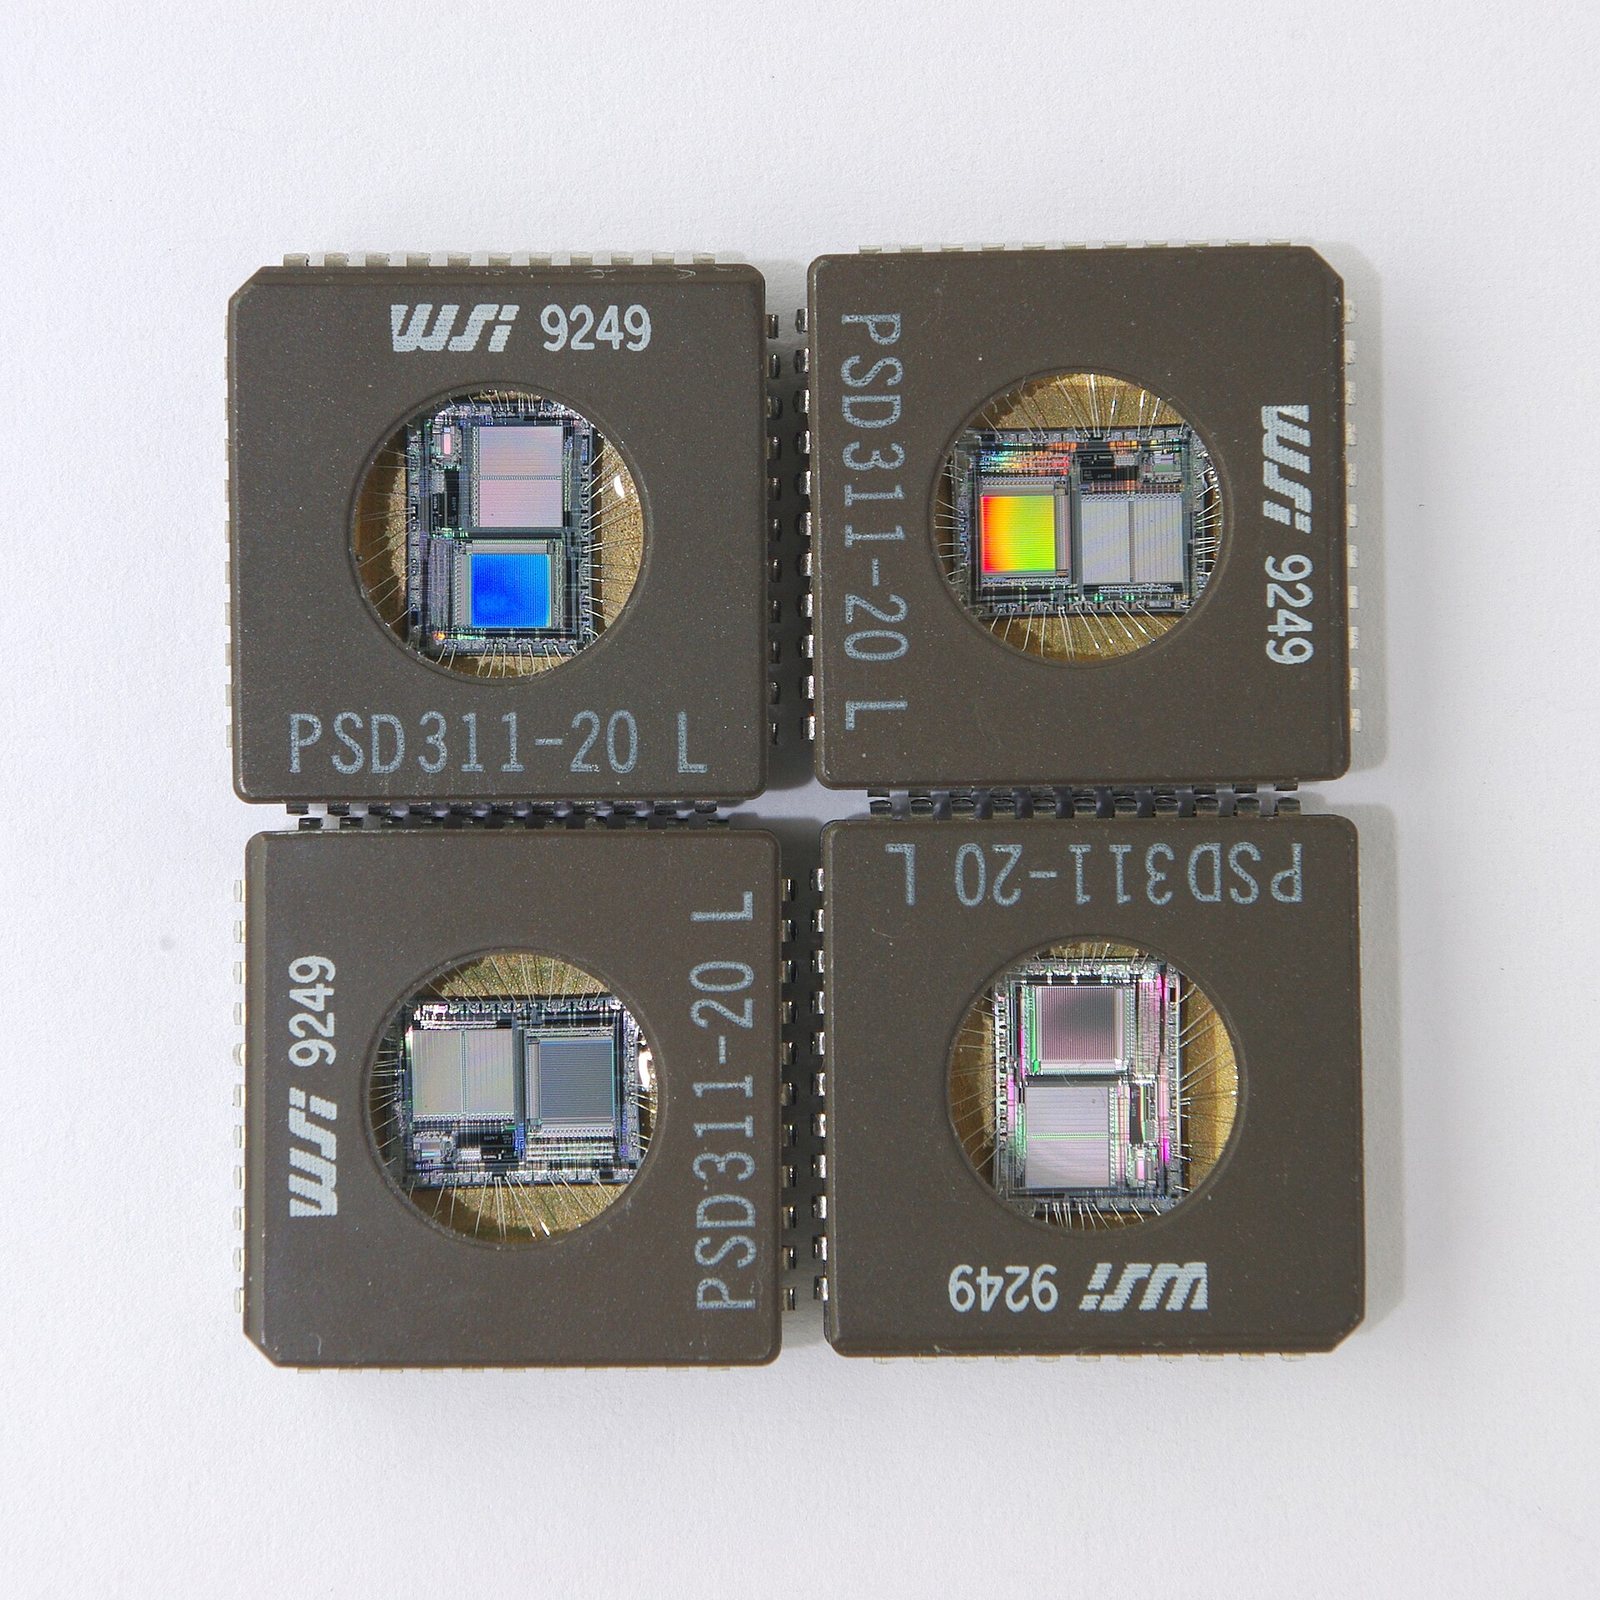
1980년대의 웨이퍼스케일 집적 시도 — 새로운 발상이 아니다
웨이퍼 전체를 하나의 소자로 쓰려는 시도는 수십 년 전에도 있었다. 당시 실패한 이유가 수율이었다 — 결함 하나가 웨이퍼 전체를 못 쓰게 만들었다. 지금 이 방식이 되살아난 것은 위에서 본 「여분 코어로 결함을 우회하는 설계」와 제조 공정의 성숙 덕분이다. 기술의 부활에는 대개 이런 조건 변화가 있다.
출처: yellowcloud from GermanyCC BY 2.02장에서 다이를 키울 수 없는 이유가 레티클 한계와 수율이라고 했다. 웨이퍼 전체를 쓰면 결함이 반드시 들어간다. 그럼 어떻게 하는가?
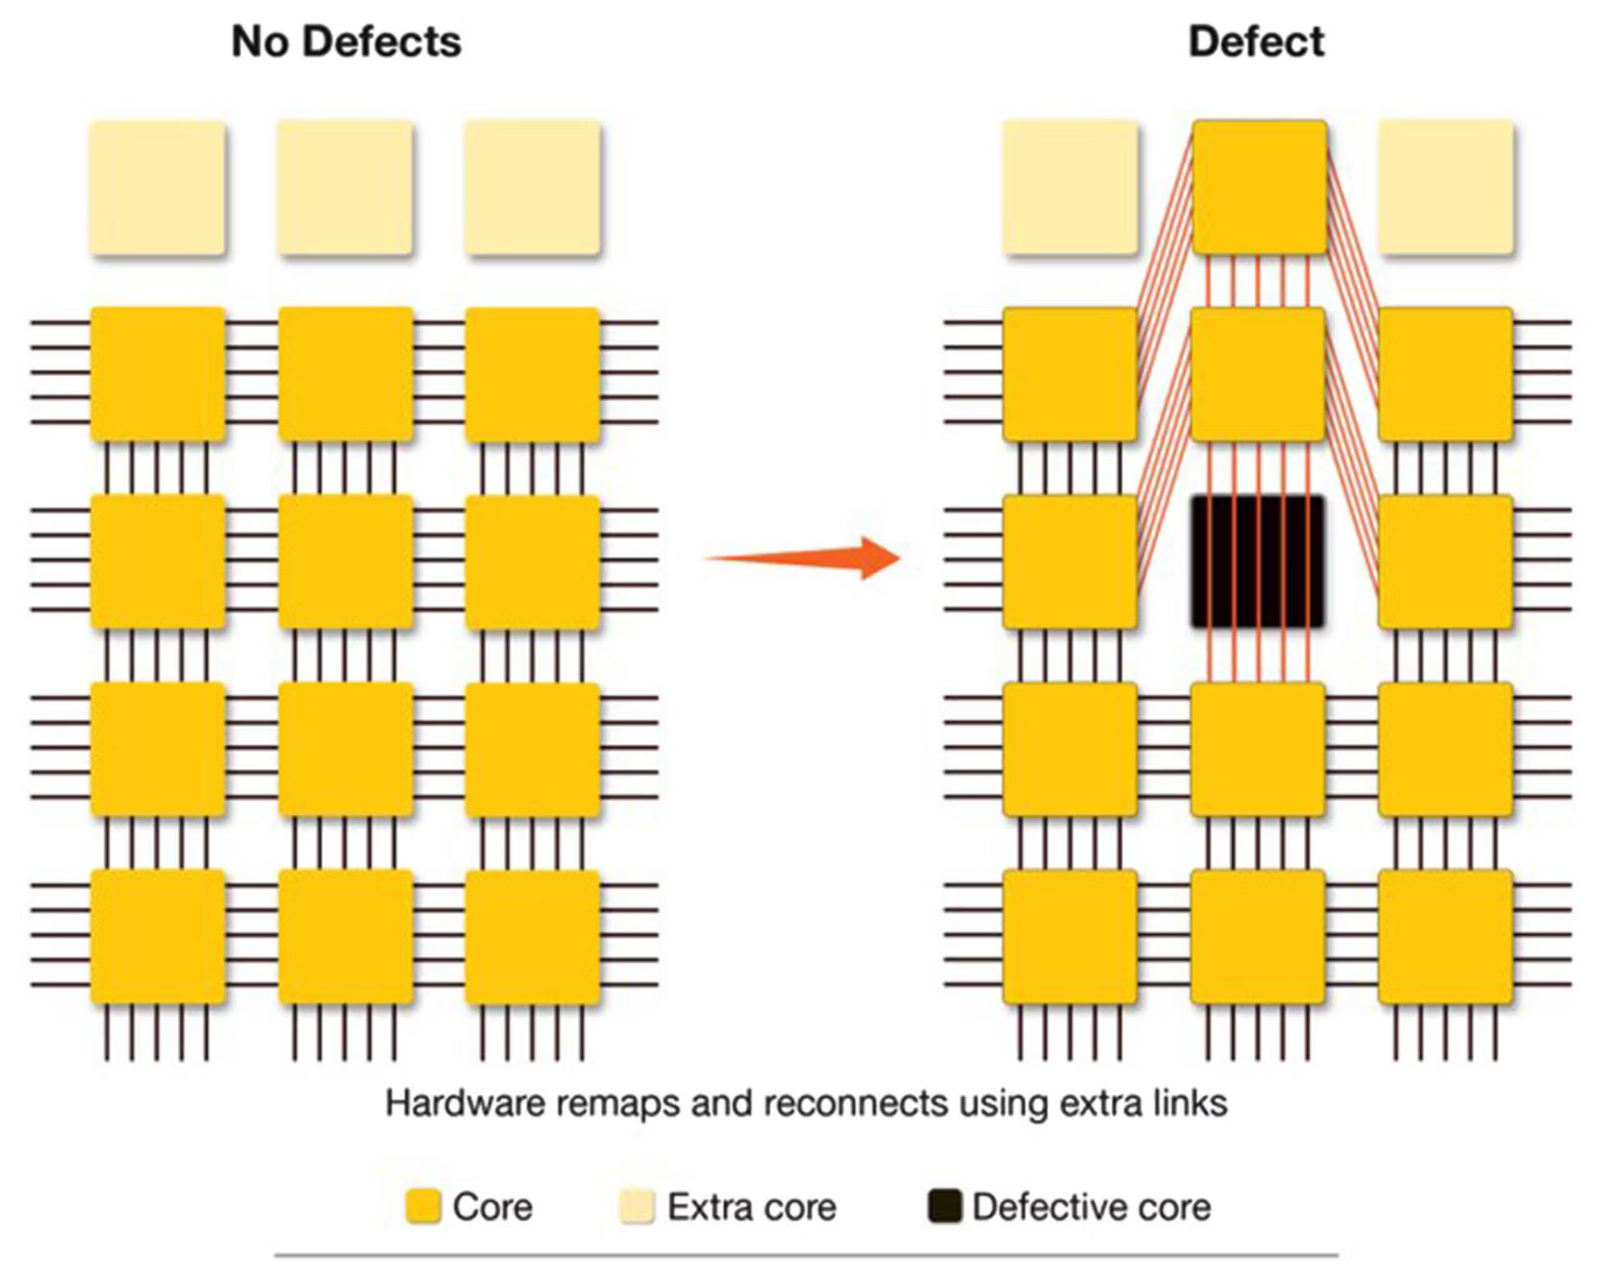
결함 대응 방식. 여분 코어를 미리 넣어 두고, 결함이 있는 코어를 하드웨어가 우회해 재연결한다. 수율 문제를 설계로 흡수한 것이다. 2장 「다이를 키울 수 없다」는 제약을 정면으로 우회한 사례다.
출처: www.cerebras.ai© www.cerebras.ai (교육 목적 인용)Groq — SRAM 기반 결정론적 실행
위 절에서 원리를 봤다. LPU는 SRAM 중심 설계에 더해 실행 시점을 컴파일 타임에 결정하는 접근을 취한다. 캐시 미스나 스케줄링 변동이 없으므로 지연이 예측 가능해진다 — SLO를 지켜야 하는 서빙에서 값어치가 있는 성질이다.
d-Matrix · Intel — 그 사이의 절충
- d-Matrix — DRAM을 적층해 카드당 100 TB/s급 대역폭을 노린다. SRAM만큼 비싸지 않으면서 HBM보다 넓은 지점을 겨냥한 절충이다.
- Intel Crescent Island (Xe3P) — MoE와 투기적 디코딩을 타깃으로 삼는다. 「어떤 추론 기법이 표준이 될 것인가」에 베팅한 설계다.
추론 특화 하드웨어는 벤치마크 조건에 극도로 민감하다. 모델 크기, 배치 크기, 컨텍스트 길이, 그리고 「몇 칩을 썼는지」에 따라 결과가 크게 달라진다. 특히 「토큰/초」만 제시하고 칩 수와 전력을 밝히지 않은 수치는 비교에 쓸 수 없다.
15장에서 벤치마크 읽는 법을 다루지만, 원칙은 하나다 — tokens/s가 아니라 tokens/$ 와 tokens/W 로 환산해서 볼 것.
국산 NPU — 어디를 노리고 있는가
국내 두 회사가 모두 추론을 겨냥하고 있다는 점에 주목하자. 6장에서 본 손익분기 논리를 떠올리면 자연스러운 선택이다 — 사전학습 시장은 물량과 소프트웨어 생태계에서 정면 승부가 어렵지만, 추론은 전력 효율과 단가로 파고들 여지가 있다.
| 리벨리온 | 퓨리오사AI | |
|---|---|---|
| 주력 제품 | REBEL-Quad · ATOM-Max | RNGD |
| 단계 | 공공조달 혁신제품 지정 | 양산 시작 |
| 구조 변화 | 사피온 합병 | — |
| 자본 | 국민성장펀드 1호 투자 | — |
| 공급 실적 | 공공 부문 중심 | 스웨덴 15MW 데이터센터에 8,800장 공급 |
| 겨냥 | 추론 | 추론 |
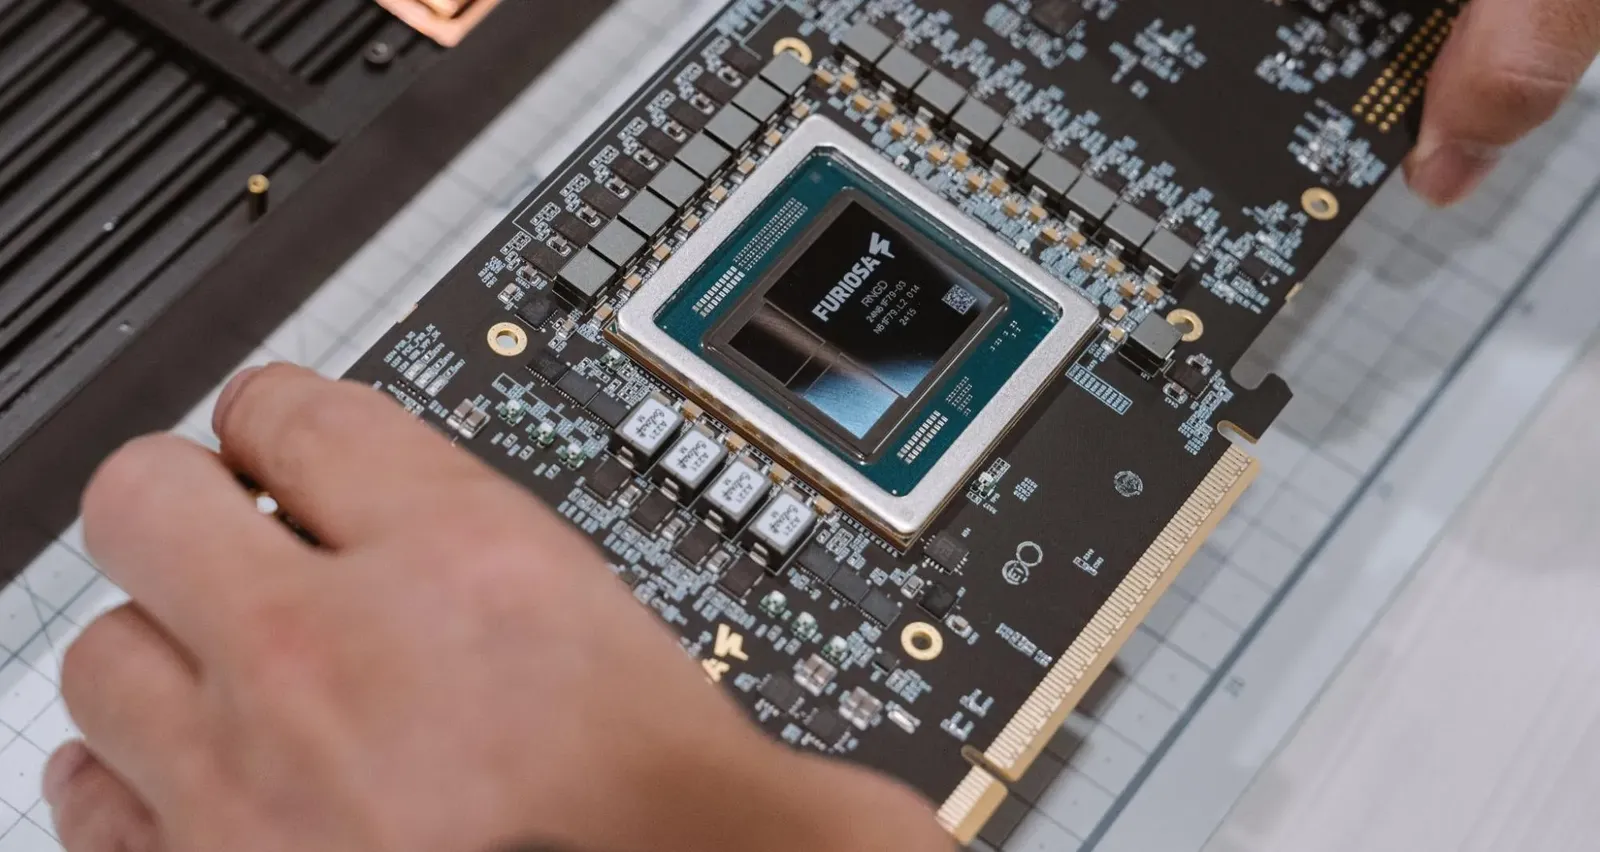
퓨리오사AI RNGD 카드
양산 단계에 들어갔고 해외 데이터센터 공급 실적을 확보했다는 점이 「샘플이 아니라 제품」이라는 가장 강한 근거다. 국산 가속기를 평가할 때 TOPS 수치보다 이 항목을 먼저 봐야 한다 — 물량, 리드타임, 장애 대응 체계가 서 있는지가 도입 가능 여부를 가른다.
출처: www.furiosa.ai© www.furiosa.ai (교육 목적 인용)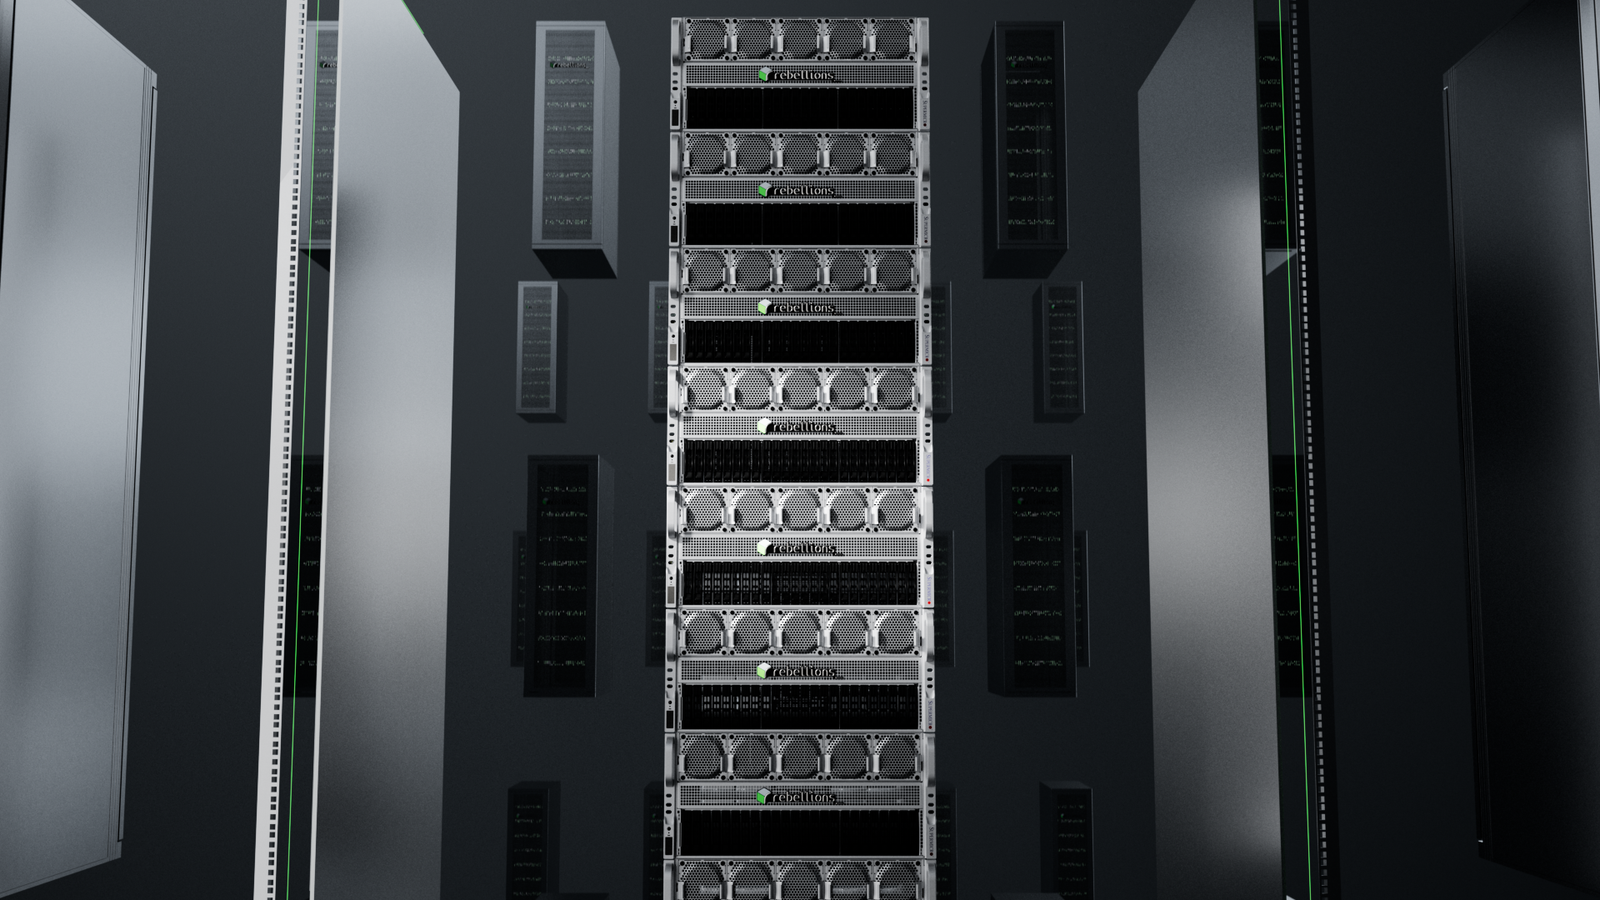
리벨리온의 랙 스케일 구성
칩 단위가 아니라 랙 단위로 팔아야 한다는 것은 4~5장에서 본 산업 전체의 흐름과 같다. 고객이 사는 것은 가속기가 아니라 「전력을 넣으면 토큰이 나오는 설비」이므로, 칩만 만들어서는 시장에 들어갈 수 없다.
출처: rebellions.ai© rebellions.ai (교육 목적 인용)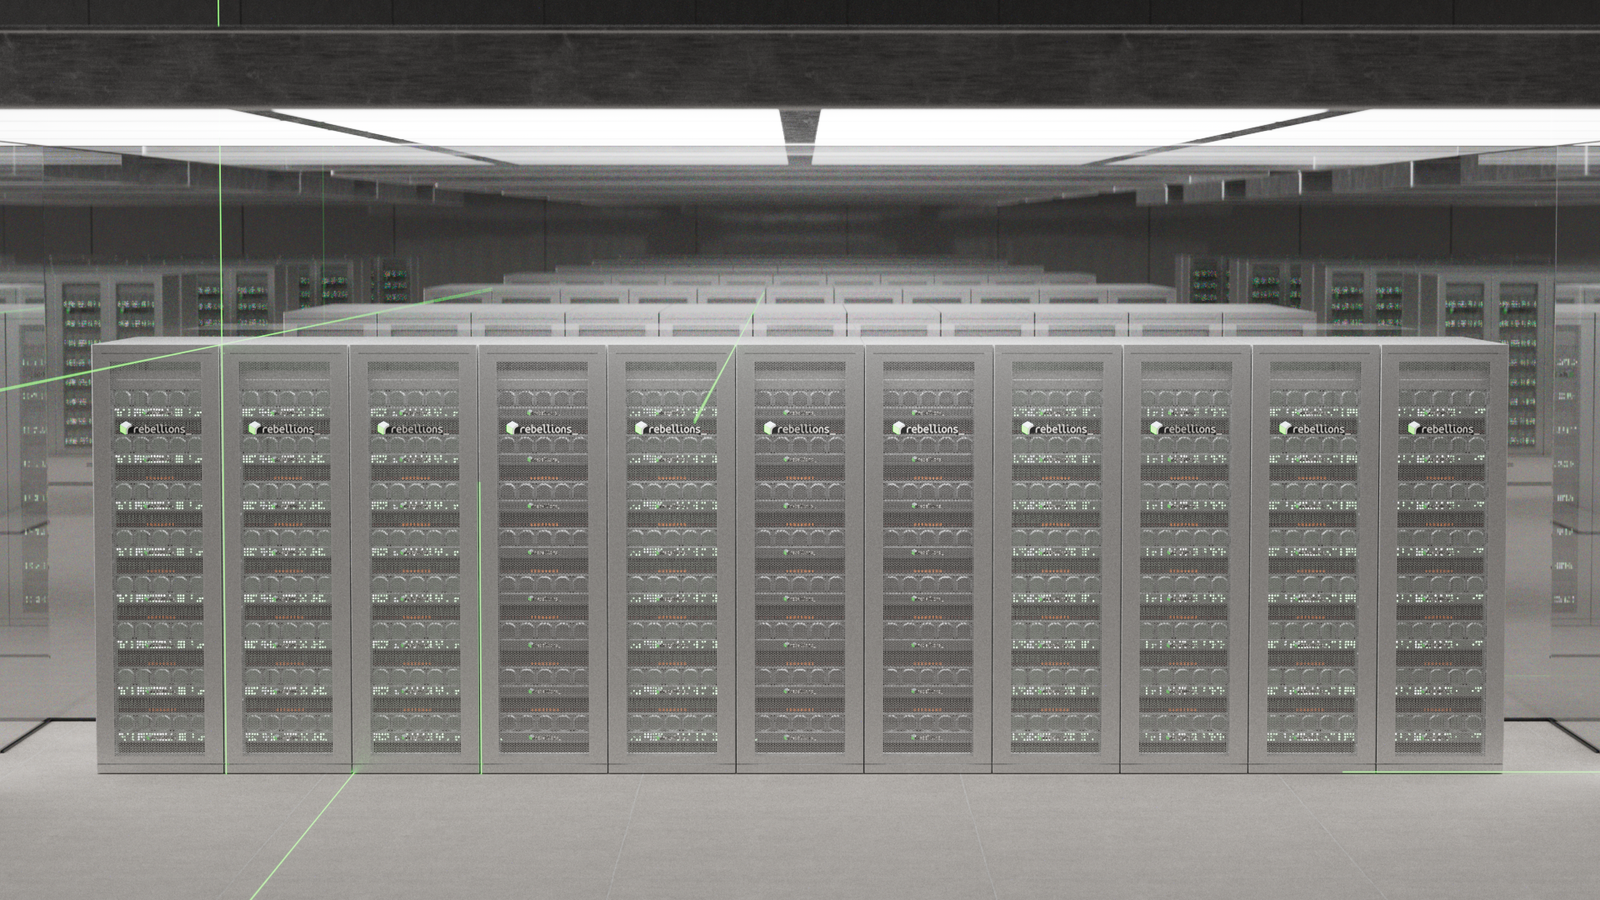
국산 NPU 기반 데이터센터 — 3D 렌더 (실제 시설 사진이 아니다)
랙이 열을 지어 선 컴퓨터 그래픽이다. 이 그림이 말하는 것은 「우리도 랙 스케일로 공급할 수 있다」는 주장이며, 그 자체가 사업의 단계를 보여준다. 17장 설계 프로젝트에서 국산 NPU 도입을 검토한다면, 이런 렌더가 아니라 실제 납품 실적·소프트웨어 지원 범위·유지보수 조건을 근거로 삼아야 한다.
출처: rebellions.ai© rebellions.ai (교육 목적 인용)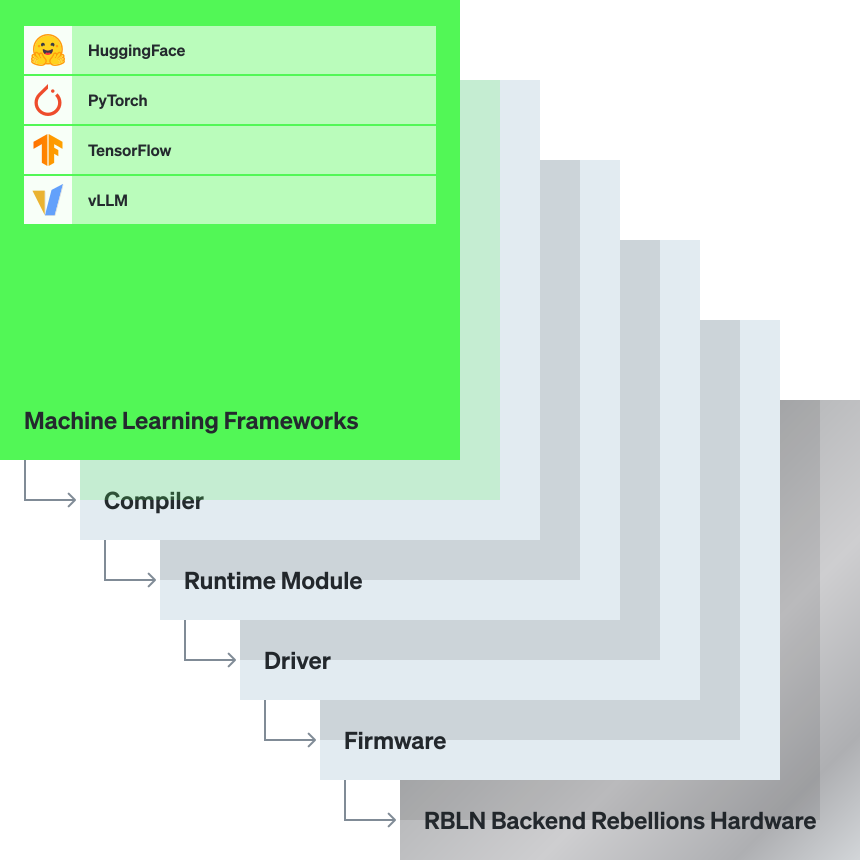
리벨리온 소프트웨어 스택 — 맨 위에 HuggingFace · PyTorch · TensorFlow · vLLM
계단식으로 쌓인 층이 위에서부터 ML 프레임워크 → 컴파일러 → 런타임 → 드라이버 → 펌웨어 → RBLN 백엔드(하드웨어)다. 하드웨어 사양보다 이 그림이 더 중요하다. 맨 윗칸에 vLLM이 들어 있다는 것이 핵심인데, 5장에서 봤듯 서빙 엔진이 붙으면 「기존 코드를 그대로 옮길 수 있는가」의 답이 달라지기 때문이다. 다만 「지원 목록에 있다」와 「우리 모델이 실제로 컴파일된다」는 다르다 — 도입 검토라면 직접 돌려 보고 확인해야 한다.
출처: rebellions.ai© rebellions.ai (교육 목적 인용)국산 NPU를 평가할 때 「TOPS가 얼마인가」는 거의 의미가 없다. 대신 이렇게 묻자.
- 소프트웨어 스택이 얼마나 돌아가는가 — vLLM/SGLang이 붙는가, 우리가 쓰려는 모델이 컴파일되는가. 5장에서 봤듯 여기가 진짜 격차다.
- tokens/W가 실제로 유리한가 — 독립 측정치가 있는가.
- 공급과 지원이 되는가 — 양산 물량, 리드타임, 장애 대응.
- 어떤 워크로드에서 이기는가 — 모든 곳에서 이길 필요는 없다. 특정 모델 크기·배치 구간에서 확실히 유리하면 그것으로 시장이 생긴다.
국가AI컴퓨팅센터 — 우리 앞의 실제 문제
이 과목에서 배운 것을 적용할 가장 가까운 대상이다.
| 항목 | 내용 |
|---|---|
| 부지 | 전남 해남 솔라시도 |
| 착공 | 2026년 8월 |
| 목표 규모 | 2028년까지 GPU 1.5만 장 |
| 참여 | 코아크 · 삼성SDS · 네이버클라우드 |
| 관련 사업 | 2026년 2조 원 규모 GPUaaS 사업 |
| 그 밖 | 슈퍼컴 6호기 |
GPU 기종을 고정하지 않고 최신 칩을 도입한다는 방침이 발표됐다. 이 과목의 관점에서 이것은 대단히 중요한 선택이다.
- 장점 — 1장에서 봤듯 세대 교체가 연 단위다. 기종을 미리 못박으면 완공 시점에 이미 두 세대 뒤진 장비가 된다.
- 부담 — 세대마다 랙 전력·냉각·배전이 바뀐다(11장). 기종을 고정하지 않으려면 건물이 그 변화를 흡수할 수 있어야 한다. 즉 전력·냉각 인프라를 미래 세대 기준으로 과잉 설계해 두어야 한다.
- 질문 — 그 여유를 어느 세대 기준으로 잡을 것인가? VR200(약 200kW)인가, Kyber NVL576(약 600kW)인가, 1MW급인가? 이 결정이 곧 건물 비용이다.
해남이라는 입지도 이 관점에서 읽을 수 있다. 대규모 AI 데이터센터의 제약은 이제 부지 가격이 아니라 전력 확보와 냉각이다. 5장에서 GW 단위 계약을 봤듯, 「이만한 전력을 끌어올 수 있는 곳」이 곧 입지 조건이 된다.
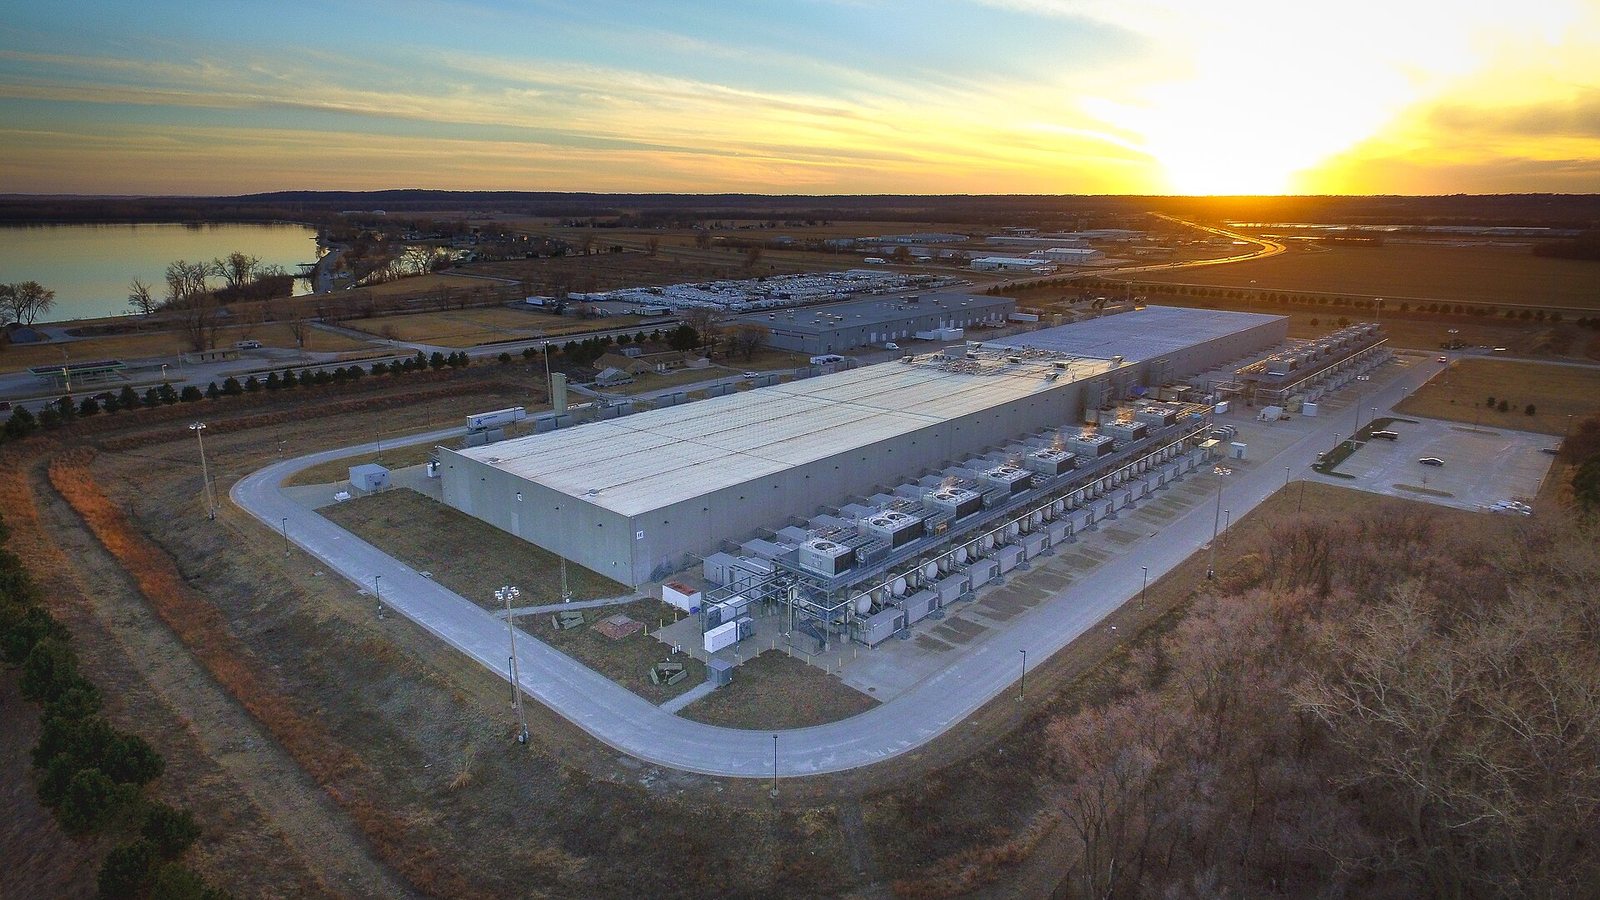
참고 — 해외 하이퍼스케일 데이터센터의 외관. 건물 자체보다 그 옆의 변전 설비와 냉각탑이 규모를 말해 준다. 11장에서 이 설비들을 하나씩 뜯어본다.
출처: Chad DavisCC BY 2.0중간 과제 — 「우리라면 어떤 랙을 몇 대 넣을 것인가」
중간 과제 (전체 성적의 20%). 국가AI컴퓨팅센터의 공개 자료를 근거로 장비 구성 제안서 초안을 작성한다. 17장 기말 프로젝트의 예행 연습이기도 하다.
1단계 — 전제를 정한다
제안은 전제가 명확해야 평가할 수 있다. 다음을 먼저 정하고 근거를 밝혀라.
- 이 센터가 주로 무엇을 할 것인가? (사전학습 / 사후학습 / 공공 추론 서비스 / GPUaaS 임대)
- 그 비중은 어떻게 되는가? 근거는 무엇인가?
- 가용 전력은 얼마로 가정하는가?
2단계 — 구성 제안
| 구분 | 제품 | 수량 | 선택 근거(워크로드와 연결) |
|---|---|---|---|
| 학습용 랙 | |||
| 추론용 랙 | |||
| CPU · 데이터 처리 | |||
| 스토리지 | |||
| 네트워크 (scale-out) | |||
| 국산 NPU 도입 여부 |
3단계 — 반드시 답해야 할 질문
- GPU 1.5만 장을 한 종류로 채울 것인가? 그렇지 않다면 어떻게 나누고, 왜 그렇게 나누는가?
- 국산 NPU를 넣을 것인가? 넣는다면 어느 워크로드에, 몇 대나, 무엇을 근거로? 넣지 않는다면 어떤 조건이 충족되어야 넣겠는가?
- 전력·냉각 인프라를 어느 세대 기준으로 설계할 것인가? 그 결정의 비용과 위험은?
- 2028년 완공 시점에 이 구성이 낡지 않으려면 무엇을 지금 결정하고 무엇을 미뤄야 하는가?
제출물
제안서 A4 6장 이내. 표와 계산을 포함하고, 모든 수치에 출처를 달 것. 평가는 「정답에 가까운가」가 아니라 「전제 → 근거 → 결론이 일관되게 이어지는가」를 본다.
공개 자료가 없는 항목은 추정하되, 추정임을 명시하고 근거와 오차 범위를 함께 적을 것. 모르는 것을 아는 척하는 것이 가장 큰 감점 요인이다.
- 국산 NPU가 국가 인프라에 들어가야 할 이유가 있는가? 산업 정책과 기술적 합리성이 충돌한다면?
- 「최신 칩을 도입한다」는 방침은 실제로 지켜질 수 있는가? 조달 제도와 어떻게 충돌하는가?
- 해남이라는 입지의 장단점을 전력·냉각·네트워크 지연 관점에서 각각 평가해 보라.
참고 자료
- Cerebras — 제품 페이지 : 웨이퍼스케일 관련 그림 출처
- FuriosaAI RNGD · 리벨리온
- 과기정통부 · NIPA 사업 공고 — AI컴퓨팅자원 활용기반 강화사업
- ZDNet Korea 등 국가AI컴퓨팅센터 관련 보도
- Hot Chips 발표 슬라이드 — 추론 특화 아키텍처의 1차 자료